Agent 推理负载画像:长 prompt 短输出、突发并发与工具调用链怎么压垮调度器
更新时间:2026-10-03。前面几篇把推理系统的零件讲了一遍:KV cache 与推理显存 讲显存账,连续批处理调度器 讲调度器怎么拼 batch,LLM 服务的 TTFT/TPOT 与 SLO 讲延迟指标。这些讨论大多以「聊天负载」为隐含基准——几百到几千 token 的输入、相当的输出、请求近似泊松到达。Agent(智能体,让模型自己规划、调工具、多轮迭代完成任务的用法)起来之后,这套基准画像全面失效。这篇给 Agent 推理负载画一张量化的像,再回答它对容量与调度的启示。
本文要回答的问题
- Agent 负载的输入输出长度分布和聊天差多少?为什么说它是「prefill 主导」?
- 工具调用链把一次任务拆成一串串行请求,对延迟和并发意味着什么?
- 突发到达模式怎么形成的?平均利用率规划的容量为什么必翻车?
- 长前缀在多轮迭代间反复出现,前缀缓存的命中率上限是多少?
- 针对这张画像,调度与容量规划上哪些动作收益最大?
一、负载三特征:长输入、短输出、链式串行
先看长度。聊天场景的典型输入是几百 token 的对话历史加一句新消息;Agent 场景的输入是系统提示词(工具定义、角色约束,常见 2K-8K token)+ 任务上下文(代码仓库片段、检索结果、上一轮工具返回,动辄数万 token)+ 越来越长的轨迹历史。而输出往往是几十到几百 token 的一段结构化动作——一个 JSON 函数调用、一行「继续搜索」的决策。实测画像里,输入输出比 50:1 甚至 100:1 不罕见,一次 20K 输入换 80 token 输出是常态。
这意味着算力账本翻面:聊天负载 decode 占比高,优化火力集中在解码效率;Agent 负载是 prefill 主导——每生成 1 个 token,要先消化几百个输入 token。prefill 是计算密集(GEMM 打满算力),decode 是显存带宽密集,两者对硬件的诉求完全不同,这直接决定了后文的配比结论。
再看结构。一次 Agent 任务不是一次请求,而是一条链:LLM 决策 → 调工具(搜索/执行代码/读文件)→ 工具结果塞回上下文 → 再决策,循环十几次到几十次才交卷。链内请求严格串行——下一步的输入依赖上一步的输出,没法并行;链的长度本身就是随机变量,提前不知道要调几次工具。
上图有两个要点。其一,输入逐轮变长——轨迹只增不减,链越往后 prefill 越贵,成本是超线性的。其二,端到端延迟由串行求和决定:12 轮迭代、每轮 TTFT 2 秒,用户就要等 24 秒以上,还不算工具耗时。所以 Agent 场景下 TTFT 的权重远高于 TPOT——输出本来就短,逐 token 流式的体验收益很小,先把每轮的首 token 尽快挤出来才值钱。这与聊天场景「TTFT、TPOT 并重」的 SLO 设计形成对照。
二、突发并发:到达不是泊松,是成批砸下来
聊天流量近似泊松到达,容量规划用均值加安全系数就能糊弄。Agent 负载的到达模式要恶劣得多,三个来源叠加:
- 编排层扇出:一个用户任务触发 Agent 并行探索多条路径(多假设分支、批量评估候选),一次点击变成几十上百个同刻请求;
- 定时批量:夜间批量跑代码审查、文档生成这类任务,整点准时涌入;
- 重试风暴:上游超时重试把同一批请求成倍复制。
数学后果是排队论的常识:利用率 ρ 超过 0.8 后,M/G/1 类队列的等待时间按 1/(1-ρ) 爆炸。突发到达相当于瞬时 ρ 远超 1,按平均利用率 70% 规划的容量,在整点洪峰里排队延迟能拉出一个数量级。更糟的是 Agent 单请求 prefill 重,一个 30K token 的 prefill 占位时间顶几十个聊天请求,队头堵一个就堵一片。
应对分三层。入口层做准入与整形:突发缓冲队列 + 按租户限速,重试要带抖动和预算,别把重试打成二次洪峰。调度层把 prefill 与 decode 分池(PD 分离的思路见 分离式推理集群),让突发洪峰只冲击可水平扩的 prefill 池,decode 池的稳定带宽不被拖垮。容量层按 P99 而非均值规划——Agent 业务的 P99/均值比常常是聊天的数倍。
三、前缀复用:命中率有天花板,别按满分规划
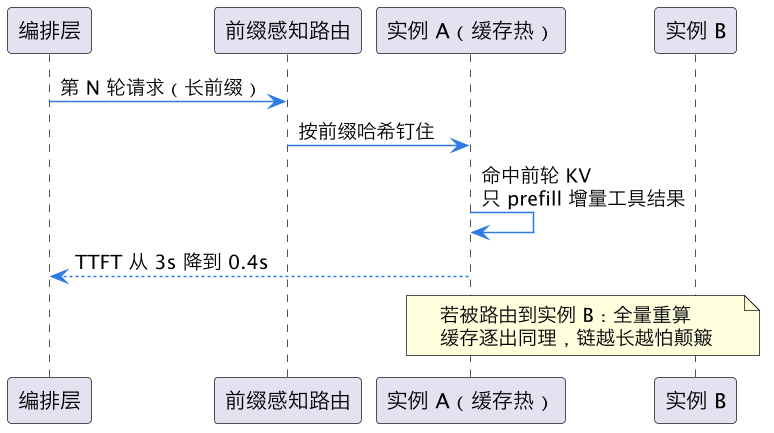
Agent 负载也有一个可爱的性质:同一任务的多轮请求共享巨大前缀。第 N 轮的输入 = 系统提示词 + 前 N-1 轮轨迹 + 新增工具结果,前两块和上一轮完全一致。这正是 前缀缓存与 Prompt 复用 的理想猎物:命中后前轮 KV 直接复用,prefill 只需算增量那一段。
理论命中率很高——若增量只有几百 token,复用率 95%+。但三个现实因素压低它:其一,轨迹中段被编排层动态改写(摘要压缩、检索结果重排),一改全废;其二,多副本部署下请求被路由到不同实例,缓存不跨实例,需要前缀感知路由把同一任务钉在同一实例(路由策略见 LLM 路由与负载均衡);其三,显存紧张时缓存被逐出,长链任务的后半程反而最容易被挤掉。规划时按 60%-80% 的实测命中率估,别按论文里的上限。
四、调度与容量启示:四件最值钱的事
把画像翻译成动作,按收益排:
| 动作 | 针对的画像特征 | 预期收益 |
|---|---|---|
| PD 分离 + prefill 池弹性扩 | prefill 主导、突发 | 洪峰不拖垮 decode,TTFT 稳定 |
| 前缀缓存 + 前缀感知路由 | 链式共享长前缀 | prefill 算力省一半以上,TTFT 降一个量级 |
| 准入控制与租户限速 | 突发、重试风暴 | 排队延迟不爆炸,SLO 可承诺 |
| SLO 重定:TTFT 优先、输出截断预算 | 短输出、链式串行 | 端到端延迟随轮数线性而非超线性增长 |
两件不要做的事也值一提。不要照搬聊天负载的 continuous batching 参数:Agent 请求的 decode 段极短,大 batch 的 decode 收益小,反而 prefill 抢占导致的调度抖动更刺眼,调度器设计可对照 vLLM V1 调度器 的分块 prefill 思路。不要忽视「轨迹膨胀」这个成本黑洞:链式任务输入只增不减,编排层做轨迹摘要压缩(把早期轮次压成几百 token 摘要)往往比任何推理侧优化都省——它是把待算的 token 从源头删掉。
这一篇在知识体系里的位置
本篇是「推理负载画像」线的一篇长尾专题:上游基准是 LLM 服务的 TTFT/TPOT 与 SLO(指标定义)与 连续批处理调度器(调度基线);同层配套 服务容量规划(把画像参数换成容量数字)、LLM 推理可观测性技术栈(怎么从线上数据量出这张画像);下游延伸是 PD 分离与前缀缓存的工程落地。
总结
Agent 推理负载的画像就三句话:prompt 极长输出极短让 prefill 成为算力主角,工具调用链把任务拆成严格串行的多轮请求让 TTFT 按轮数累加,编排扇出与批量任务让到达成批突发;对应的调度启示是 prefill 与 decode 分池弹性扩、前缀缓存配前缀感知路由吃掉重复 prefill、入口做准入整形,再让编排层压缩轨迹从源头省 token——画像认对了,钱才花在对的地方。