FPGA 原型验证专题 52:多站点机柜与互联拓扑——一个设计横跨多个实验室的 FPGA 时,时钟、触发与数据怎么走
更新时间:2026-09-13。本文是模块 F(规模化、云化与工程运营) 第七篇。12 多 FPGA 分区算法 割集/容量/图划分、13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频 解决了单板多片的逻辑切分与 TDM;本篇把视角拉到机柜和多站点:当 FPGA 数量从几片涨到几十上百片,系统级的时钟、互联、供电、故障域成为主战场。
一、规模阶梯:板 → 背板 → 机柜 → 站点
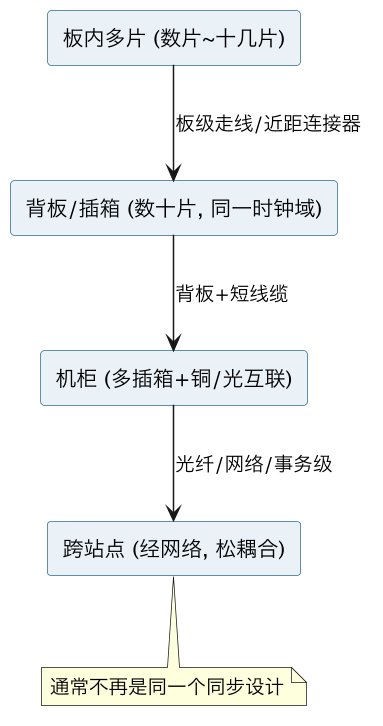
每跨一级,互联的延迟、可同步性、带宽代价都跳变。关键判断是:“同步设计边界”通常终止于同一个共享时钟树的插箱/机柜;跨站点一般不能维持逐周期同步,只能做松耦合。
二、跨片互联的带宽预算(TDM 倍率怎么吃带宽)
单板多片用 TDM 在一根物理线上时分复用多条逻辑连线(13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频),阵列规模越大,跨切分线越多、TDM 倍率越高:
所需单向物理带宽 B ≥ 跨切分信号位数 W × 单信号需传输的 TDM 时隙率
TDM 倍率 m 越高 → 等效逻辑延迟越大 → 原型可跑频率越低
约束:B ≤ 互联物理通道数 N_lane × 每通道速率 R_lane
工程取舍三条:
- 优先减少跨切分信号(分区优化比堆线缆便宜,12 多 FPGA 分区算法 割集/容量/图划分);
- 跨板尽量走 SerDes 高速串行而非海量并行 LVDS(线少、距离远、时钟嵌入),低速并行只在板内/近距;
- TDM 倍率要有全局预算:某一对板之间倍率过高会成为全系统频率瓶颈,分区时要均衡切分边的权重。
三、时钟:同源分发是阵列的地基
几十片要协同,时钟不能各用各的晶振(否则频偏累积、跨片 CDC 到处都是)。机柜级做法:
- 单一基准时钟源 + 时钟分发树:高稳晶振/时钟模块经缓冲器、背板等长分发到各插箱各板,保证同源、可控 skew(29 时钟网络约束);
- 每片本地用 MMCM/PLL 综合所需多频点,但都锁到同一基准,跨片保持确定相位关系;
- 冗余/可切换时钟源,主源故障可切备用,避免单点让整柜停机;
- 触发/时间同步单独走硬件触发总线(接 40 多板多 FPGA 全局触发与时间对齐 跨片 trace 同步),不与数据通道混用。
跨站点(异地)无法共享一个物理时钟:两地晶振必有 ppm 级漂移,不能假设同一拍,只能各用时钟 + 硬件时间戳(1588/基本道类)做事件对齐,且只适合事务级协同。
四、物理互联:铜缆距离边界与光
- 板内/短距(<十几~几十 cm):并行 LVDS/宽总线划算(16 LVDS);
- 板间/插箱内(数十 cm~数 m):SerDes 铜缆/背板,注意损耗、均衡、37 信号完整性;
- 跨机柜/更远(数 m~数十 m 以上):铜的衰减和 skew 失控,走光互联/有源光缆,延迟和带宽稳定但成本高、占光模块资源;
- 线缆是大规模阵列最常见的故障和现场错误来源:走线标识、防呆、长度/通道映射表、连接变更纳入配置管理(呼应 35 多 FPGA IO 引出与引脚规划 连接器/电平/SI/取舍)。
五、跨站点:松耦合,而不是“一个同步设计分两半”
两个城市的机柜不要试图跑同一个逐周期同步的 DUT,物理延迟(毫秒级网络 RTT)远超任何时钟周期。合理模式:
- 事务级/消息级协同:两地各跑相对独立的子系统,经 transactor/速率适配器交换事务(26 事务处理器 SCE-MI 三类通道/transactor 实现、31 速率适配器 Speed Adapter 弹性FIFO/两种范式);
- 独立验证 + 结果汇聚:一地跑计算子系统、一地跑 IO/软件,汇聚 trace 和结论(trace 汇聚见 45 Trace 带宽与深度工程 采样/缓冲/压缩/回传管线);
- 接入方式可走 48 远程实验室与 IO 重定向 虚拟前面板/远程上下电 的安全网关,但要明确它是“远程操控/数据交换”,不是“延展同一同步时钟域”。
六、机柜级供电与散热:规模放大的硬约束
单板几安电流,整柜就是数十~上百 kW,供电散热从“板级问题”变成“机房问题”:
- 每插箱/机柜核算总功率、PDU 分路、冗余电源、上电时序与浪涌(板级基础见 42 电源散热);
- 风道方向一致、前后不打架、温控按板监控(47 多用户资源调度 预约/作业/租约/防误烧 的遥测复用);
- 降频原型功耗低于真实 ASIC,但 FPGA 满载 + 大量 SerDes/光模块发热仍很可观,不能按空闲估算制冷。
七、故障域与可维护性:别让一片板拖垮全系统
上百片 FPGA 的系统,单板故障是常态而非意外。设计要限制故障域:
- 可热插拔/独立下电的插箱或板:维修一块板不整柜停机(与 88 篇资源隔离联动);
- 互联拓扑留冗余路径,某根线缆/光模块故障可绕行或快速定位;
- 分区配置支持“降级运行”:某板下线时,阵列能重组为较小容量继续跑较小设计,而不是全废;
- 健康监控到每片(温度、电压、链路误码、bit error),异常自动隔离告警,纳入 54 运营指标看板 利用率/TAT/flake/就绪度。
八、拓扑选择决策表
| 规模 | 互联 | 时钟 | 触发 | 典型 |
|---|---|---|---|---|
| 单板多片 | 板级并行/LVDS | 同板同源 | 硬连触发 | 中小 SoC |
| 插箱/背板 | SerDes 铜/背板 | 分发同源 | 触发总线 | 大型 SoC |
| 机柜/多插箱 | 铜+光 | 主备基准+分发 | 硬件时基 | GPU/NPU 切片 |
| 跨站点 | 光/网络事务级 | 各用时钟 | 时间戳对齐 | 异地松耦合 |
九、机柜级部署检查单
①单一高稳时钟源+等长分发+冗余切换;②每对板跨切分位宽/TDM 倍率/SerDes 通道算清且均衡;③铜/光按距离选型并跑通误码;④触发总线独立、全局时基一致;⑤线缆全部防呆标识+映射表入配置库;⑥机柜总功率/PDU/上电浪涌/制冷核算;⑦每片健康监控+异常自动隔离;⑧单板/单插箱可独立下电更换、支持降级重组;⑨比特流/分区/线缆版本与 20 比特流烧录与四方版本一致 manifest/门禁 绑定。
十、常见坑速查
- 各板用本地晶振还想逐周期对齐 → 同源时钟分发,异地只做事务级;
- 海量并行 LVDS 跨机柜 → 距离一长必失败,改 SerDes/光;
- 分区不看跨切分权重 → 某对板 TDM 倍率成全系统频率瓶颈;
- 把跨站点当一个同步设计 → 网络 RTT 决定了只能松耦合;
- 按空闲估制冷 → 满载 FPGA+光模块发热巨大;
- 一根线故障整柜停机 → 限故障域、冗余、可降级重组。
与系列及现有篇目的链接
- 单板基础:12 多 FPGA 分区算法 割集/容量/图划分、13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频、35 多 FPGA IO 引出与引脚规划 连接器/电平/SI/取舍
- 时钟与触发:40 多板多 FPGA 全局触发与时间对齐 跨片 trace 同步、29 时钟网络约束、16 LVDS
- 规模化运营:47 多用户资源调度 预约/作业/租约/防误烧、48 远程实验室与 IO 重定向 虚拟前面板/远程上下电、55 容量规划与故障预算 MTTR/N+1/RTO-RPO
总结
一句话总结:当 FPGA 从单板几片涨到背板插箱数十片、机柜上百片乃至跨站点时,成败从单 FPGA 设计转到系统级时钟、互联、供电和故障域——规模阶梯是板内(并行 LVDS、同板时钟)→背板插箱(SerDes 铜/背板、分发同源、触发总线)→机柜(铜加光、主备基准时钟)→跨站点(只能经网络/光做事务级松耦合,绝不能把一个逐周期同步设计拆到两地,因为毫秒级网络 RTT 和晶振 ppm 漂移使异地无法共享时钟,只能各用时钟加硬件时间戳做事件对齐);跨片带宽按“所需单向带宽 B≥跨切分信号位数 W×TDM 时隙率,且 B≤通道数×单通道速率”预算,应优先分区减跨切分信号、跨板用嵌入时钟的 SerDes 而非海量并行线、并全局均衡各对板 TDM 倍率防止某条切分边成全系统频率瓶颈;时钟是阵列地基,单一高稳基准经缓冲器和等长背板同源分发、各片用 MMCM/PLL 锁同一基准综合多频点、配主备冗余源、触发时间同步走独立硬件总线;物理互联按距离选型(板内并行、板间 SerDes 铜并做均衡 SI、跨柜数米以上走光),线缆是最常见故障和接错来源须防呆标识加映射表入配置管理;机柜级供电散热是机房问题(整柜数十上百 kW、PDU 分路冗余、上电浪涌、一致风道、按满载 FPGA 加光模块而非空闲估制冷);上百片时单板故障是常态,要用可独立下电热插拔的插箱、冗余互联路径、某板下线可重组较小容量的降级运行、以及每片温度电压误码健康监控自动隔离来限制故障域;最终按“单板多片/插箱/机柜/跨站点”四级拓扑分别选互联、时钟和触发方案,并通过绑定比特流分区线缆版本的部署检查单把时钟同源、跨切分均衡、误码、触发、功耗、可维护性逐项落地。