W4 GEMM kernel:Marlin 路线的反量化融合 GEMM 工程拆解
更新时间:2026-10-01。在 仅权重量化 GPTQ 与 AWQ 里我们回答了「4 bit 权重怎么量化才不掉精度」,但量化只解决了一半问题——权重以 4 bit 躺在显存里,算的时候还要还原成 FP16 喂给 Tensor Core,这一步如果走「先反量化成 FP16 矩阵再做普通 GEMM」的两段式,带宽收益会被反量化开销吃掉大半。这一篇讲专门为此设计的 W4 GEMM kernel:以 Marlin 为代表,把反量化融进 GEMM 主循环,权重布局重排、寄存器级位运算、双缓冲与 L2 复用四件套配合,把 W4A16 打到接近显存带宽峰值。
本文要回答的问题
- 两段式「反量化 + FP16 GEMM」为什么慢,W4 GEMM kernel 融合后省下的到底是什么?
- 权重布局重排(layout reorder / interleave)为什么在离线阶段必不可少,重排成什么样?
- 寄存器级反量化怎么用几条位运算指令把 4 bit 整数变成 FP16,开销为什么能压到近乎为零?
- 双缓冲(double buffering)和 cp.async 流水线怎么把权重搬运藏到计算背后?
- 调度与 L2 复用怎么做,才能在 A100 上把 W4 GEMM 打到 90% 以上的带宽利用率?
一、W4 GEMM kernel 解决什么问题:先把两段式的账算清
仅权重量化(W4A16:权重 INT4、激活 FP16)的核心收益是带宽。decode 阶段 batch=1 时 GEMM 退化为 GEMV,计算量极小,性能几乎完全由「从显存搬多少字节」决定。FP16 权重矩阵 K×N 要搬 2KN 字节,INT4 只要 0.5KN 字节,理论加速 4 倍。但这个 4 倍有一个前提:搬进来的 4 bit 数据必须以接近零的代价还原成 FP16 参与计算。
最朴素的实现是两段式:先跑一个 dequantize kernel,把 INT4 权重展开成 FP16 写回显存(或 L2),再跑普通 FP16 GEMM。问题在于中间产物——FP16 权重矩阵的写和读各一次,带宽开销 2×2KN = 4KN 字节,比 INT4 原始数据还大 8 倍。两段式下,总带宽消耗是 0.5KN(读 INT4)+ 2KN(写 FP16)+ 2KN(读 FP16)= 4.5KN,只比不量化的 2KN 略好,而且多了一次 kernel 启动和同步开销。W4 GEMM kernel 的做法是把反量化挪进 GEMM 主循环:INT4 数据从显存经 shared memory 进寄存器后,在寄存器里就地反量化,马上喂给 Tensor Core 的 mma 指令,FP16 中间产物永不落显存。

把账落实到一个具体例子:Llama-2-7B 的 FFN 层 down projection,K=11008、N=4096。FP16 权重大约 90 MB,INT4 压缩到约 23 MB(加 group-wise scale/zero 后约 25 MB)。A100 显存带宽 1.6 TB/s 实测有效约 1.3-1.4 TB/s,batch=1 时两段式实际吞吐提升只有 1.3 倍左右,而 Marlin 这类融合 kernel 能把单层延迟压到接近「搬 25 MB 的理论时间」,decode 端到端提速 3.5 倍以上。差距全部来自中间产物的流量和反量化指令开销。
二、权重布局重排:让 4 bit 数据按 mma 的胃口排队
普通 GEMM 的权重按行主序或列主序存就够了,W4 GEMM kernel 却必须在离线阶段做一次权重布局重排,原因有三层。
第一层是解包粒度。INT4 权重是 8 个值打包在一个 32 bit 字里,而 Tensor Core 的 mma 指令(如 mma.sync.aligned.m16n8k16)要求每个线程持有特定位置的 FP16 片段。如果按原始顺序解包,每个线程需要的 4 bit 值散落在不同的 32 bit 字里,解包后还要做跨线程 shuffle 才能凑齐 mma 的操作数,开销巨大。重排的思路是:离线把权重的打包顺序调整成「一个线程解包一个 32 bit 字,得到的 8 个值恰好就是它下一步 mma 需要的 8 个值」——解包即就绪,零 shuffle。
第二层是 ldmatrix 兼容。Ampere 起共享内存到寄存器的搬运用 ldmatrix 指令,一次按 8×8 的 FP16 块搬。重排要让反量化后的数据在 shared memory 里的布局恰好满足 ldmatrix 的地址模式,否则又要额外搬一次。
第三层是 scale/zero 的存放。group-wise 量化(典型 group size 128)每 128 个权重共享一组 scale(FP16)和可选 zero point。重排时把 scale 放到独立的连续数组,主循环每处理完一个 group 边界才加载一次新 scale,避免和权重数据交错造成 shared memory bank conflict。

重排是纯离线操作,跟着 GPTQ/AWQ 的导出脚本一次做完,运行时完全无感。代价是权重文件格式和 kernel 实现绑定——Marlin 格式的权重不能直接喂给 AWQ 的 GEMM kernel,vLLM 等推理框架里每种 kernel 对应一套量化配置。这也是工程上选 W4 GEMM kernel 时要同时确认「我的量化工具能不能导出这个格式」的原因。
三、寄存器级反量化:几条位运算把 INT4 变 FP16
反量化的数学形式很简单:fp = (q - z) × s,q 是 4 bit 整数,s 是 scale,z 是 zero point。难的是要在每个 mma 片段上、每个线程每个循环迭代里做几十次,还不能让 ALU 成为瓶颈。Marlin 的巧思是把这一步几乎完全用位运算实现。
对称量化(z 隐含处理)时,核心技巧是利用 FP16 的位模式:把一个 4 bit 值加上偏移后塞进 FP16 指数的低位,让它落在 [1024, 1040) 这个区间——这个区间里 FP16 数的尾数是连续整数,等价于「用一次整数加法 + 一次 FP16 减法」完成 8 个值的整数转浮点,且 8 个值共用同一组寄存器操作。Ampere 的 LOP3(任意三输入布尔运算,单周期)和 PRMT(字节重排)指令进一步把「从 32 bit 字里抠出 8 个 4 bit 值并扩成 16 bit 槽位」压缩到两三条指令。实测下来,反量化每条 mma 平均只摊到个位数的额外 ALU 指令,而 mma 本身是 Tensor Core 异步执行,ALU 和 Tensor Core 天然重叠——反量化的有效开销趋近于零,这正是「融合」的底气。
zero point 的处理分两种路线。非对称量化(AWQ 风格)把 -z×s 折叠成一个修正项:因为激活和常量修正项相乘可以提到 mma 外面做(对整行激活点积一次),主循环里仍然只做对称反量化。Marlin 用的是另一种:离线把 zero point 吸收进 scale 加一个全局偏置,运行时反量化公式不变。两种都遵循同一原则——主循环里不许出现 per-element 的分支或额外乘法。

和这条路线对照的是「查表反量化」:4 bit 只有 16 种取值,理论上可以预建 16 项的 FP16 查找表。但 GPU 的查表要么走 shared memory(bank conflict 和额外延迟),要么走 PRMT 半字节查表(只能覆盖 16 项且要多次拼接),实际都不如位运算法干净。位运算法对 scale 是 per-group 变化也天然友好——查表法每换一个 group 要重建表,位运算法只是换一个乘数。
四、双缓冲流水线:把 global→shared 的搬运藏进计算
反量化不烧算力之后,瓶颈回到老问题上:权重从显存到 shared memory 的搬运延迟怎么藏。答案是标准的软件流水线,但 W4 GEMM 把它做到了极致。
Ampere 的 cp.async 指令允许 global→shared 的拷贝不占用寄存器、不等拷贝完成就继续执行后续指令。Marlin 的主循环按 K 维分成若干 stage(典型 3-4 级),每次迭代干三件事:发出下一个 tile 的 cp.async、对已经在 shared memory 里的 tile 做 ldmatrix + 反量化 + mma、用 cp.async.wait_group 保证最老的那个 stage 就绪。INT4 权重每字节信息密度是 FP16 的 4 倍,同样大小的 shared memory 能装 4 倍 K 深度的 tile,流水线的「在途数据量」天然更厚,隐藏延迟更容易。
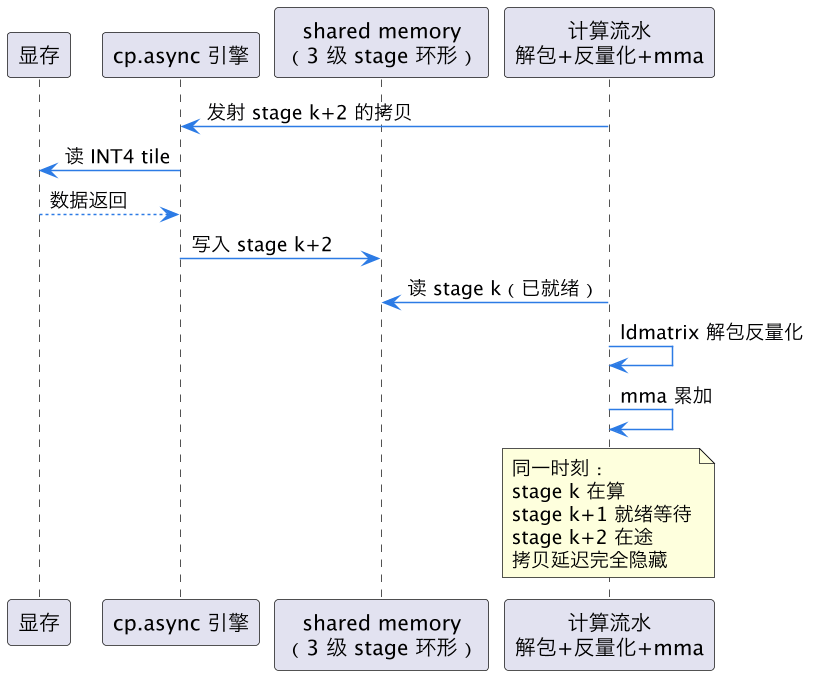
这张图里的关键点:计算单元永远在处理「早已就绪」的 stage,拷贝引擎永远在为「两轮之后」的 stage 搬数据,两者时间轴错开,显存延迟(A100 上约 400-600 纳秒)被 stage 数乘以单 stage 计算时间完全覆盖。stage 数不是越多越好——每级 stage 占 shared memory,3-4 级后 shared memory 会成为限制并发 block 数的瓶颈,反而掉 occupancy。Marlin 的默认配置就是在这个平衡点上选的。
激活一侧同样要进 shared memory,但 decode 场景激活只有一行(或一个 batch 的小矩阵),流量可以忽略;prompt 阶段(batch 大)激活流量上来,这时 kernel 的行为更像普通 GEMM,tile 划分要兼顾两侧的复用,Marlin 对 M 维做了分段处理:M 小于 16 走纯带宽模式,M 大时退化成计算受限,此时 W4 的带宽优势仍在(权重读取量仍是 FP16 的四分之一),只是加速比从 4 倍往 2 倍回落。
五、调度与 L2 复用:90% 带宽利用率的最后一公里
单 block 的流水线做好了,全局还差两件事:block 调度顺序和 L2 命中。
GEMM 的 K×N 权重矩阵被切成许多 tile,block 调度顺序决定 L2 的复用模式。朴素做法按 N 维顺序发射 block,相邻 block 读完全不同的权重列,L2 基本不命中。Marlin 的做法是沿 K 维条带化(strip-mined)调度:把同一组 N 列的、K 维上相邻的 tile 分给一组连续发射的 block,它们读的是同一段激活(K 维相邻)且权重在 L2 里按 K 条带自然衔接;再辅以 swizzled 的 block 线性化(类似 CUTLASS 的 threadblock swizzle),让同一时刻在飞的 block 覆盖的激活窗口最小,激活在 L2 的复用率最高。对 decode 这种激活极小的场景,更重要的效果是:所有 SM 的读请求在 K 维上是「齐步走」的,显存控制器的行缓冲命中率显著提高——这是从 80% 带宽利用率爬到 90%+ 的关键,且和 DRAM 物理行为强相关,不看硬件细节很难想到。
另一个容易忽略的点是 scale 的加载时序。group size 128、K=11008 时一条 K 维有 86 个 group 边界,如果每跨边界才同步加载 scale,流水线会周期性地顿一下。Marlin 把 scale 也纳入预取:权重 tile 的 cp.async 发出的同时,下一个 group 的 scale 已经在飞,跨边界无停顿。
| 优化手段 | 作用层面 | 典型收益 | 代价 |
|---|---|---|---|
| 反量化融合 | 消除 FP16 中间产物显存流量 | 总流量 4.5KN → 0.5KN | kernel 复杂度 |
| 权重布局重排 | 解包零 shuffle、ldmatrix 兼容 | mma 就绪无等待 | 离线格式绑定 |
| 位运算反量化 | ALU 开销摊平、与 Tensor Core 重叠 | 反量化开销趋近零 | 指令级实现门槛高 |
| cp.async 多级流水 | 隐藏显存延迟 | 带宽持续打满 | shared memory 占用 |
| K 条带调度 + swizzle | L2 与 DRAM 行缓冲命中 | 80% → 90%+ 带宽利用率 | 调度器复杂度 |
| scale 预取 | 消除 group 边界停顿 | 流水线无气泡 | 少量额外寄存器 |
把这六项叠起来,就是 Marlin 在 A100 上的实测成绩:batch 1-16 区间、group size 128 的 W4A16 GEMM 稳定达到理论带宽的 90% 以上,相对 FP16 cuBLAS 的单层加速 3.87 倍,接近 4 倍理论上限。换句话说,W4 GEMM kernel 这个题目在 Ampere 上已经被解到「贴着硬件上限走」的程度,剩下的提升空间只能来自硬件本身(Hopper 的 TMA、更大的 shared memory)而不是调度技巧。
六、落地清单:选用与排错
工程上直接用现成实现即可,不需要自己写:vLLM、TensorRT-LLM、ExLlamaV2 都内置了 Marlin 或同路线 kernel,量化工具侧 GPTQ/AWQ 的导出格式与 Triton kernel 自动调优 里讲的 block 配置调优是互补关系——固定格式的 Marlin 不需要 autotune,但非标准形状(K/N 不能整除 tile)时 Triton 版 W4 GEMM 加 autotune 反而更灵活。
排错时记住三个信号。第一,加速比只有 1.2-1.5 倍:十有八九是走了两段式路径或反量化没融合,用 Nsight Compute 看有没有独立的 dequantize kernel 在跑。第二,大 batch 下加速比骤降:正常现象,计算受限后带宽优势自然缩水,不必调。第三,换模型后 kernel 报错或精度崩:检查量化导出的格式版本和 kernel 是否匹配,group size、对称/非对称标志、激活序(act-order)开关三者必须一致,格式绑定的代价就体现在这里。
还有两个实战细节值得记住。其一,W4 GEMM kernel 对 K、N 的整除性有要求:Marlin 要求 N 是 256 的倍数、K 是 128 的倍数(group size 128 时),不满足就要在量化导出时 pad,pad 的列对结果无贡献但会占带宽,异形矩阵(比如某些 MoE 专家的中间维)要先把这笔账算进去。其二,激活序(act-order)重排会让 K 维的访问顺序与 group 边界交错,支持 act-order 的 kernel 变体要额外维护列索引表,吞吐会比非 act-order 版本低 5%-10%——精度收益不明显时优先关掉它。
与 KV cache 侧的 INT4 化(见 KV cache INT4 量化)组合使用时,权重 W4 和 KV cache W4 是两条独立的带宽压缩链路,收益近似相乘,长上下文 decode 场景下两者缺一不可。
这一篇在知识体系里的位置
本篇是「量化 → kernel → 推理系统」链条的中间环:上游是 仅权重量化 GPTQ 与 AWQ,决定权重以什么数值形态存在;本篇解决这些 4 bit 权重怎么以接近零的额外开销参与矩阵乘;下游则进入推理框架的调度与 batching(如 decode 阶段的 Attention decode SplitK 与 FlashDecoding)。底层机制上,双缓冲与异步拷贝的手法和 CUDA streams 异步重叠 一脉相承,只是一个在 kernel 内、一个在 kernel 间;带宽与互联的物理底座见 多 GPU NVLink 互联。
总结
W4 GEMM kernel 的本质是把「4 bit → FP16」的反量化从显存流量降级为寄存器位运算——离线重排让解包即就绪、LOP3/PRMT 让转换近乎免费、cp.async 多级流水让搬运隐身、K 条带调度让 L2 与 DRAM 行缓冲全程高效,四件事叠加,W4A16 的 4 倍带宽理论收益才真正落进 A100 实测的 3.87 倍。