MMMC corner 裁剪:组合爆炸下的 signoff 角剪枝方法
X2 角、模式与 MMMC讲过 MMMC(Multi-Mode Multi-Corner)分析框架如何把「模式 × 角」组织成 analysis view,SPEF 寄生提取讲过每个角背后是一套独立的寄生数据。这两篇都默认「该跑的角都跑」——但真实项目里这个前提根本撑不住:一个中等复杂度的 SoC 轻轻松松组合出几百个 scenario,全跑一遍签核 STA 要几周。本篇讲的就是这个现实矛盾:组合为什么会爆炸、工程上用什么方法把 scenario 集合剪到可承受规模、剪枝剪错了会怎样漏签、以及怎样给裁剪决策留下可审计的证据链。配套的 RC 角选择讲单个 PVT 角内部的 RC 配对,SDC 约束 lint讲模式约束本身的质量保障,三者合起来才是完整的 signoff 角治理。
本文要回答的问题
- PVT 角和工作模式各自有哪些维度?为什么它们的组合是乘法而不是加法?
- 什么是 corner dominance?怎样判断一个 scenario 被另一个「支配」从而可以剪掉?
- 除了 dominance,工程上还有哪些裁剪手段(等价归并、约束复用、统计抽样)?各自的适用边界在哪?
- 裁剪剪过头会漏掉什么样的 violation?硅后才发现的代价有多大?
- 一套负责任的裁剪流程应该长什么样,决策依据如何留档?
一、组合爆炸从哪来:模式 × 角 × 检查类型
先把「角」和「模式」两个轴拆开看。
PVT 角这一轴,来源是三层波动的笛卡尔积:工艺(Process)——SS/TT/FF 加上先进节点的局部失配与片内偏差建模;电压(Voltage)——标称电压 ±10% 是常态,低功耗设计还有 DVFS 多档电压点,每档都要配套签核;温度(Temperature)——消费级 −40℃ 到 125℃、车规到 150℃,先进节点温度反转又让「冷」和「热」都成了 setup 候选最坏角。三层一乘,单模式下的 setup 角就有 6 到 10 个候选,hold 角另有 4 到 6 个。
模式这一轴来自设计本身的功能多态:功能模式(func)、测试模式(scan shift、scan capture、BIST)、各种低功耗模式(sleep、retention)、接口速度档位(USB 的 HS/FS、PCIe 的 Gen1 到 Gen5)。每种模式对应一套不同的时钟结构、case analysis 常量、有效路径集合——约束文件里用 mode 切换的正是这些东西。
两个轴一乘,再乘上检查类型(setup/hold 至少两类,max delay 和 min delay 的角需求正相反),scenario 数量就失控了:
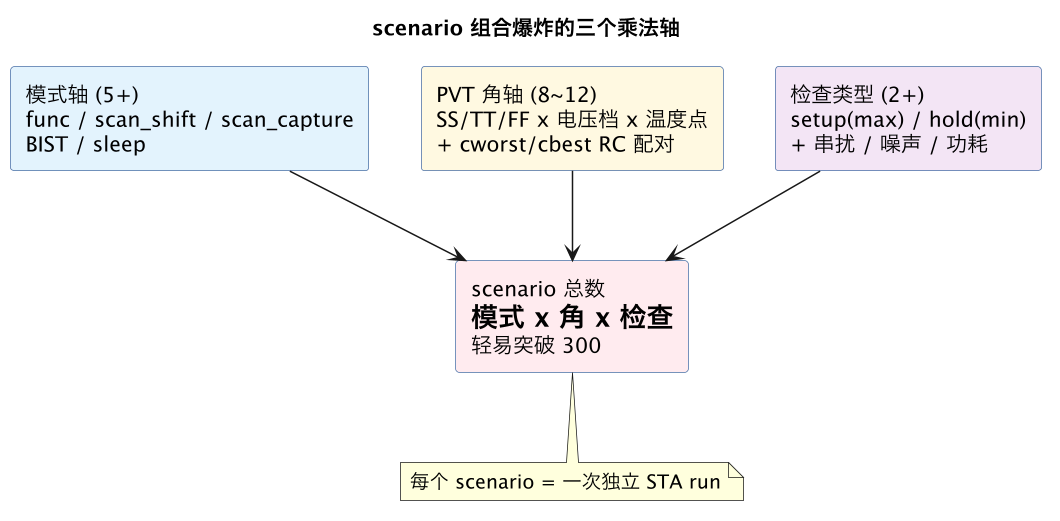
这张图里最要命的是右下角那句注释:每个 scenario 不是一行配置,而是一次独立的 STA 运行——独立的寄生反标、独立的时序图更新、独立的报告输出。先进节点一次全芯片 PrimeTime 签核运行要数小时到十几小时、吃上百 GB 内存(调度见 LSF 作业调度),300 个 scenario 串行跑就是一个多月,就算并行铺到集群上,许可证和内存配额也扛不住全量常驻。这就是 MMMC corner 裁剪存在的理由:不是角不重要,而是全量跑不起,必须证明哪些角不跑也不漏。
二、dominance:裁剪的理论基石
裁剪的第一性原理是支配关系(dominance)。给定两个 scenario A 和 B,如果对于设计中任意一条路径,A 角下算出的延迟都不优于 B 角(对 setup 而言 A 的延迟总是 ≥ B),那么 B 被 A 支配——B 角就算跑出 violation,A 角一定也出,且更糟。于是 B 可以从 setup 签核清单里安全剪掉。
判断 dominance 的实操依据有三个层次:
- 库延迟单调性:查 .lib 里同一单元在不同 PVT 下的延迟表。如果角 A 的每个单元延迟都 ≥ 角 B 对应单元,A 对 B 构成单元级支配。这是最强也最省事的判据,写个脚本扫一遍 Liberty 就能出结论;
- RC 配对单调性:寄生角必须和库角配套比——cworst 寄生的 SS 角 vs cbest 寄生的 FF 角比 setup 没有意义,两者落在延迟谱的两端,同向才可比。RC 角内部的配对规则见 RC 角选择;
- 路径结构相关性:即使单元级不严格支配,对该设计实际存在的路径集合做抽样 STA,若 A 角下所有抽样路径 slack 都更差,可形成「统计支配」证据——这已经不是数学证明,而是工程置信,必须记录抽样规模与覆盖率。
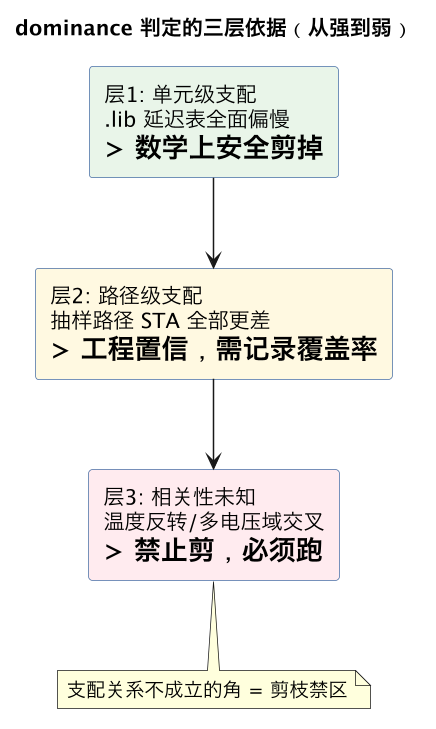
这张图强调的是一个梯度:越往下剪枝证据越弱,到了第三层就不存在剪的权力。温度反转(先进节点低电压下 −40℃ 可能比 125℃ 更慢,机理见 SPEF 寄生提取第三节)正是把大量角推进第三层的元凶——它破坏了「热角支配冷角」的教科书假设,让 setup 最坏角在温度轴上不再单调。多电压域设计里,跨域路径的始端和末端吃不同电压档,延迟对两个电压的偏导方向可能相反,同样摧毁单元级单调性。凡是存在这类「非单调因素」的轴,裁剪时一律按保守处理。
三、dominance 之外的裁剪工具箱
真实项目的裁剪清单里,dominance 只能剪掉一部分,剩下靠三类手段。
等价归并(equivalence)。若干 scenario 的时序行为如果本质相同,只留一个代表。典型例子:BIST 模式和 scan capture 模式共用同一套时钟树与频率目标时,两者时序视图等价,跑一个即可;多个 DVFS 档位中相邻两档电压差 30mV、库延迟差小于 1% 时,低频档往往被高频档支配而归并。归并的前提仍然是证据——要么约束文件 diff 证明时序相关部分逐行一致,要么抽样 STA 证明 slack 谱重合。
约束驱动的整模式豁免。有些模式根本不存在「签核时序」的概念:scan shift 跑在 10MHz 量级,时序余量按纳秒富余,行业惯例是只做 max transition/capacitance 等规则检查而不做全 setup 签核;sleep 模式的唤醒序列由 PMU 固件握手保证,不看建立时间。这类豁免必须由 SDC 约束 lint 背书——先证明该模式的约束本身完整(时钟定义、case analysis、false path 都齐),豁免的才只是「跑 STA」这一步,而不是「这个模式不需要管」。
统计抽样与分阶段签核。收敛期只跑 dominance 证明过的「骨干角」(通常 setup 3-5 个、hold 2-3 个),其余角挂到 nightly 或 milestone 回归;最终 tapeout 前的 golden 签核窗口再全量补跑。这套打法的风险窗口在「骨干角漏判」,所以抽样角集合的选取本身要过评审,并且任何一次骨干角上出现接近零 slack 的 violation 时,自动触发相关角族的扩容重跑。
| 裁剪手段 | 依据强度 | 适用场景 | 主要风险 |
|---|---|---|---|
| dominance(单元级) | 数学证明 | 同向 PVT 角族 | 温度反转破坏单调性 |
| dominance(路径级) | 统计置信 | 抽样覆盖率高的成熟设计 | 抽样盲区路径 |
| 等价归并 | 约束/行为等价证明 | 多模式、多电压档 | 等价前提随设计迭代失效 |
| 整模式豁免 | 行业惯例 + 约束 lint | scan shift 等低速模式 | 豁免范围被误扩大 |
| 分阶段补跑 | 流程纪律 | 收敛期降载 | 补跑窗口被进度挤压 |
四、裁剪的工作流:从全量清单到签核矩阵
把上面的方法组织成一条可执行的流水线,大致是五步:
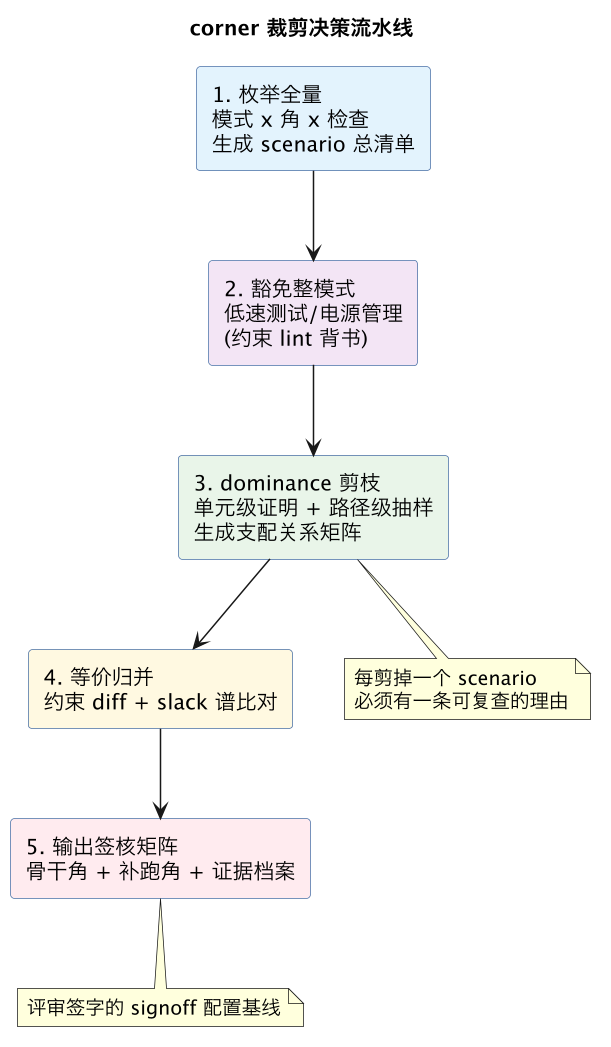
这条流水线有两个非显然的设计点。第一是顺序:先豁免、再剪枝、后归并,因为豁免只依赖模式语义,成本最低;dominance 需要库和寄生数据,成本居中;归并要做约束 diff 和抽样运行,成本最高。把便宜的过滤放前面,能让后面贵步骤面对的集合最小。第二是证据档案:每一步产出物不只是「剩下的角清单」,还有「每个被剪 scenario 的剪除理由」——支配它的兄弟角是谁、支撑数据是什么。这份档案是硅后问题回溯时唯一的线索,也是代工厂 signoff 评审(见 S5 签核枢纽)必查的材料。
一个中型 SoC 走完这条流水线的典型账目:全量枚举 320 个 scenario,模式豁免去掉约 90 个低速测试 scenario,dominance 剪掉约 140 个被支配角,等价归并再收掉 30 个,最终签核矩阵剩 60 个上下——其中骨干角日常回归 12 个,其余进 milestone 全量。裁剪比约 5:1,这个数字在先进节点项目里算中规中矩。
五、漏 signoff:剪错一个角的代价链
裁剪的本质是风险换产能,那么风险敞口长什么样必须说清楚。漏签的机理分三类:
支配关系被设计迭代破坏。裁剪证明是基于某个版本的库、寄生和约束做的,之后任何一次 ECO 换库、升 PDK 版本、改时钟架构,都可能让曾经的「被支配角」翻上来。最典型的是 ECO 变更传播 场景:修 setup 的 ECO 在高 VDD 角加了 buffer,这条路径在低 VDD 角的 hold 裕量被吃掉——如果低 VDD hold 角恰好在剪枝名单里,这个 violation 就静默通过了。对策是流程纪律:裁剪矩阵与库/PDK 版本绑定,任何版本变更自动作废全部裁剪证明并重审。
统计抽样的盲区。路径级 dominance 抽了十万条路径,但设计里有几千万条;没抽到的那部分里如果藏着对某角特别敏感的结构(比如一条跨电压域的 feedthrough),漏签就发生了。先进节点的局部互连效应还会制造「角序翻转」:同一条路径在角 A 比角 B 快,它的邻居路径却相反——因为两条路径的层别分布、耦合环境不同,RC 排序不一致。这就是为什么 MMMC 与 OCV 强调片上偏差建模与角选择必须一起看:OCV 余量给得足,能兜住一部分角序翻转;余量抠得太紧,裁剪的任何小失误都会直接漏到硅上。
约束层的隐性角。有些 scenario 不在时序矩阵里却在别的签核维度上是最坏的:高温高漏角对功耗签核最坏、cbest 寄生对角对串扰最坏、低电压角对电迁移和 IR drop 最坏。只从 STA 视角做裁剪,可能把别的签核域的最坏角顺手剪掉了。所以裁剪矩阵必须是跨签核域对齐的——时序、功耗、信号完整性、可靠性各自的骨干角取并集,而不是各剪各的。
漏签的代价链在硅后呈指数放大:硅前 STA 阶段发现并修复一个 violation,成本是一次 ECO 迭代(几天);tapeout 后发现,成本是改版流片(先进节点一次 mask 费用数百万美元级、周期数月);量产后发现,是召回级别的商业事故。历史上真实的翻车案例大多不是「完全没跑某角」,而是「某角在裁剪清单里被一条早已失效的支配证明挡在门外」——证据档案过期的危害,比没有证据更大,因为它制造了虚假的安全感。
六、工程实践清单
把全文收成一份可照做的纪律清单:
- 裁剪矩阵是配置管理对象:和库版本、PDK 版本、约束版本一起入库,变更需评审,与 PDK 版本基线 同级管理;
- 每个被剪 scenario 留一条机器可读的剪除记录:类型(豁免/支配/归并)、依据数据、证明日期、证明所用的版本指纹;
- 温度反转工艺节点上,setup 角的温度轴两端都保留,禁止沿「热支配冷」的旧直觉剪;
- 骨干角出现 |slack| < 30ps 的临界 violation 时,自动扩容同族角重跑,不等人肉决策;
- tapeout 前的 golden 窗口全量补跑所有被剪角——这是裁剪风险的最终对冲,窗口必须在项目计划里显式占位,不能被进度挤掉;
- 时序、功耗、SI、EM/IR 的角清单取并集对齐,跨域对齐会议要有签字记录。
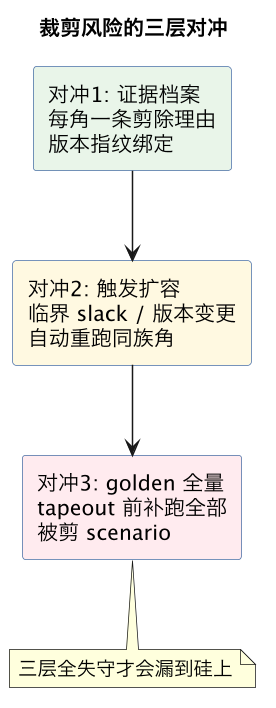
这张图是全篇的落点:裁剪不是一次性的「剪完就放心」,而是三层独立防线——档案层防「剪错而无知」,触发层防「证明过期」,全量层防「前两层的任何疏漏」。三层都失效,漏签才会真正流到硅上;而每一层的成本(写档案、跑增量、排窗口)都远低于一次硅后返工。
这一篇在知识体系里的位置
本篇是 MMMC 主题的「治理面」:X2 角、模式与 MMMC 建框架,SPEF 寄生提取 供数据,RC 角选择 定单角配对,本篇解决「角太多跑不完」的规模治理。上游依赖 SDC 约束 lint 保证模式约束质量,下游产出 signoff 角矩阵交给 S5 签核枢纽 调度执行;ECO 阶段裁剪证明的作废与重审则挂在 X3 ECO 变更传播 流程上。
总结
MMMC corner 裁剪是在「全量跑不起」和「漏签赔不起」之间走钢丝:用 dominance、等价归并、模式豁免把 scenario 剪掉一个数量级,再用证据档案、触发扩容、golden 全量三层对冲把剪错的风险压到可接受——裁剪的每一刀都必须可审计、可回溯、与版本绑定,否则省下的机时终将以硅后返工的形式连本带利还回去。