UVM callback 机制:driver/monitor 扩展点、注册调用三步、不改源码的错误注入与覆盖增强
更新时间:2026-10-02。做验证的人都遇到过这个局面:环境里的 driver 跑得好好的,某天要加一个「在第五笔事务上注入 CRC 错误」的定向场景。最顺手的改法是打开 driver 源码塞一个
if (cnt == 5),改完这个用例过了,三个月后 driver 里长满了各种用例留下来的刺,没人敢动。UVM callback(回调机制)就是为治这个病设计的:组件作者在 driver/monitor 的关键位置预先埋好「扩展点」,测试编写者派生一个回调类、写注入逻辑、在测试里注册——driver 的源码一个字不用动,不同测试各挂各的钩子,互不污染。站内的 UVM 组件与 phase 讲了组件骨架,UVM sequence driver scoreboard 讲了激励主链路,SV 回调钩子 讲了 SystemVerilog 层面回调的语法原型;这一篇聚焦 UVM 库内建的 callback 设施(uvm_callback、uvm_callbacks、uvm_register_cb三件套),把「怎么埋、怎么挂、什么场景该用它而不是 factory override」讲透。UVM callback 的核心价值一句话:它把「环境行为的变化点」从源码修改变成运行前的对象注册,让同一份环境代码在几十个测试里表现出几十种行为。
本文要回答的问题
- UVM callback 到底解决什么问题,为什么直接改源码或用 if 开关不行?
- 一个完整的 callback 要几步落地:
uvm_callback派生、uvm_register_cb宏、uvm_do_callbacks触发各干什么? - 回调是「对象级注册」还是「类型级注册」,两者语义差在哪、什么时候用哪个?
- driver 错误注入、monitor 数据旁路、覆盖率增强这三类典型场景各怎么挂钩子?
- callback 与 factory override、sequence、config_db 四种扩展手段的边界怎么划?
一、为什么需要 callback:环境代码的「开闭原则」
先看清问题本质。验证环境的 driver/monitor 是被所有测试共享的基础设施。行为变化的需求有三种典型形态:错误注入(让 driver 偶发或定向地发出非法波形)、数据加工(在事务发出前改几个字段)、观测增强(monitor 看到某类事务时额外采样一份覆盖)。这些需求的共同点是「变化粒度很细」——只在某个组件内部的某个时机插入一段逻辑,主链路完全不动。
如果靠改源码实现,代价是环境代码随测试数量线性膨胀,而且不同测试的需求会互相打架:测试 A 加的 if 分支可能被测试 B 的随机种子踩中。如果靠配置开关(config_db 传一堆布尔位),组件代码会变成开关的丛林,每加一个场景就要在组件里预埋一个分支——组件作者得提前预知所有场景,这不可能。如果靠 factory override 整个换掉 driver,又太重了:为了改一行注入逻辑,要派生整个 driver 类、复制粘贴主体代码,之后 driver 升级补丁还得手动合并回派生类。UVM factory 环境派生 讲的 override 适合「整体替换实现」,不适合「在实现里戳一个洞」。
callback 正是「戳洞」的标准化方案:组件作者在代码里声明「这里允许外部插一段逻辑」(扩展点),组件代码只负责在时机到了时遍历所有已注册的回调对象、逐个调用;测试侧派生回调类写自己的逻辑,注册进去。组件对回调一无所知(只知道接口),回调对组件内部实现也一无所知(只看到扩展点暴露的参数)——这就是开闭原则在验证环境里的落地:对扩展开放,对修改关闭。
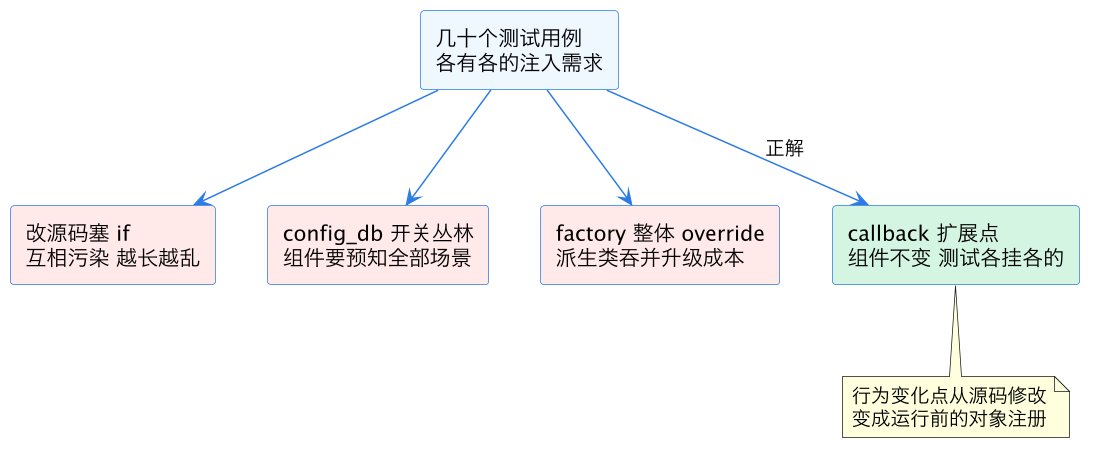
上图把四条路线的分叉画清楚了。前三条不是不能用——它们各自有适用场景(第六节会给选型表)——而是用在「细粒度行为插入」这个需求上都不合身。callback 是这个需求形状的专属工具。
二、三步落地:声明、埋点、注册触发
一个可挂接的 UVM callback 由三方配合完成,先看代码骨架再逐句拆。
// 第一步:定义回调类(组件作者写,空实现即「默认什么都不做」)
class my_driver_cb extends uvm_callback;
  `uvm_object_utils(my_driver_cb)
  function new(string name = "my_driver_cb");
    super.new(name);
  endfunction
  // 扩展点:事务驱动到总线前被调用,返回 1 表示丢弃这笔
  virtual function bit pre_drive(my_driver drv, ref my_txn tr);
    return 0;
  endfunction
endclass

// 第二步:组件里注册回调类型并埋触发点
class my_driver extends uvm_driver #(my_txn);
  `uvm_component_utils(my_driver)
  `uvm_register_cb(my_driver, my_driver_cb)   // 声明可挂的回调类型

  task run_phase(uvm_phase phase);
    my_txn tr;
    forever begin
      seq_item_port.get_next_item(tr);
      bit drop;
      `uvm_do_callbacks(my_driver, my_driver_cb,
                        pre_drive(this, tr))   // 触发点
      if (!drop) drive_one(tr);
      seq_item_port.item_done();
    end
  endtask
endclass

// 第三步:测试侧派生回调并注册
class err_inject_cb extends my_driver_cb;
  int cnt;
  virtual function bit pre_drive(my_driver drv, ref my_txn tr);
    cnt++;
    if (cnt == 5) begin tr.crc = ~tr.crc; end  // 第五笔注错
    return 0;
  endfunction
endclass

// 在测试的 build_phase 里注册(对象级:只挂这一个 driver 实例)
uvm_callbacks #(my_driver, my_driver_cb)::add(env.agent.drv, err_cb);
三步各自的职责。第一步「声明回调类」:必须派生自 uvm_callback,方法做成 virtual 空实现——空实现不是偷懒,是「默认无操作」的语义,测试只重写它关心的方法。参数设计上有个惯例:第一个参数传组件句柄本身(this),让回调能反向读组件状态(比如当前发送计数),第二个参数用 ref 传事务句柄,回调对事务的修改才能被组件看见。第二步「埋点」:uvm_register_cb 宏在组件类里登记「本组件接受哪类回调」,它是静态类型层面的配对声明;uvm_do_callbacks 宏出现在组件的关键时机处,展开后的逻辑是「遍历注册到这个组件上的所有该类回调,逐个调用指定方法」。第三步「注册」:uvm_callbacks#(...)::add 把一个回调对象挂到某个组件实例上,可以在 build_phase 就完成,任何 phase 里动态加挂、删除(delete)也都合法。
这里有一个容易踩的顺序坑:uvm_do_callbacks 只是「在代码里写了触发点」,如果忘了在组件类里加 uvm_register_cb,编译期并不报错(宏展开不检查配对),运行时回调永远不会被调用,现象是「注入逻辑没生效、日志一片空白」。排查的第一件事永远是检查三件套是否配齐:回调类、register_cb、do_callbacks。
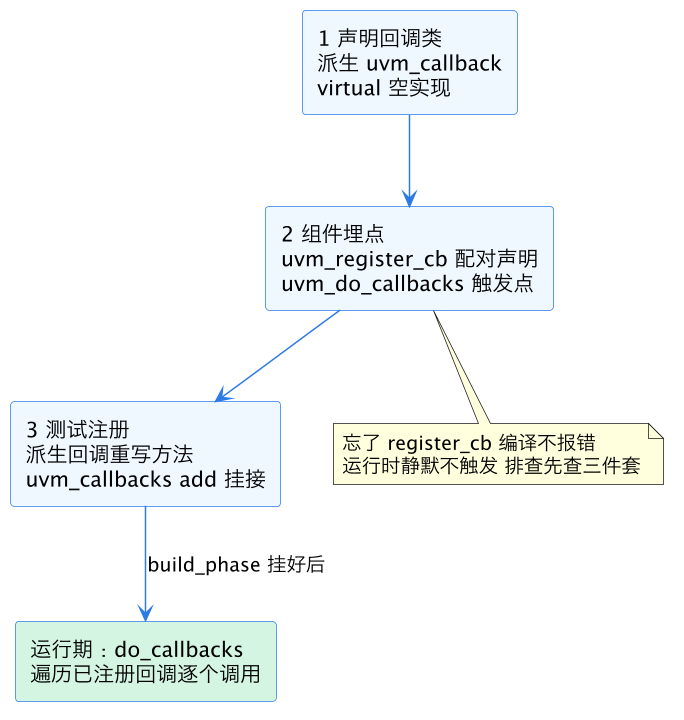
上图把三方协作的顺序固定下来:声明 → 埋点 → 注册,缺任何一环回调链都不通。这也是 review callback 代码时的检查清单顺序。
三、对象级与类型级注册:add 的两个世界
uvm_callbacks #(T, CB)::add 的第一个参数决定了注册的作用域,这是 UVM callback 语义里最容易混的一点。
对象级注册(instance-specific):add(env.agent.drv, cb)——回调只挂在 env.agent.drv 这一个实例上。同类型的另一个 driver 实例(比如 SoC 验证里两个相同 agent 的两个 driver)完全不受影响。这是绝大多数场景应该用的形式:注入需求几乎总是「针对某个具体接口的具体实例」。
类型级注册(type-wide):add(null, cb)——第一个参数传 null,回调挂到整个类型上,该类型的所有实例、包括之后才 build 出来的实例,触发点上都会调用这个回调。它适合「整个验证平台层面都要生效」的场景,比如给所有寄存器访问统一加日志(UVM 寄存器 callback 就大量用这种形式做访问前后的钩子)。类型级注册的风险是作用域失控:一个测试里 add(null, cb) 忘了在结束时 delete,如果仿真里接着跑第二个测试(多测试同进程串跑),回调残留会悄悄污染后面的测试。纪律是:谁 add 谁 delete,最好成对写在测试的 build/final phase 里。
还有一个组合语义要知道:对象级和类型级可以叠加,同一触发点上类型级回调和对象级回调都会被调用,顺序是注册顺序(先 add 的先执行)。多个回调串成链时,前一个回调对 ref 参数的修改会被后一个看到——这既是能力(可以叠加多个小的数据加工回调)也是坑(两个回调都改同一字段时结果依赖注册顺序)。工程上建议一个触发点上的回调保持「互相正交」:一个管注错、一个管采样,不要两个都改数据。
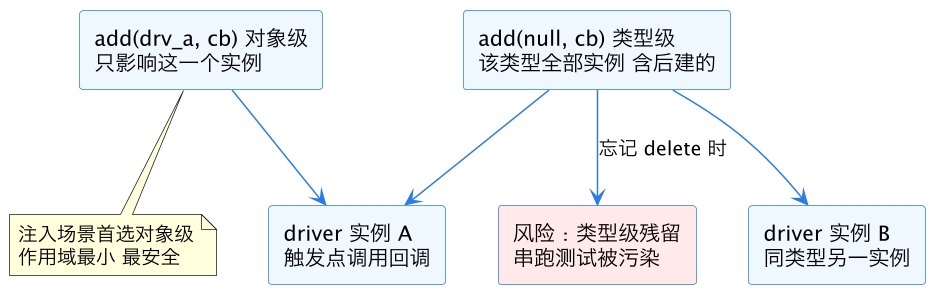
上图对比了两种注册的作用域边界:对象级是一支精准的点射,类型级是一片面杀伤。选型原则一句话:能对象级就不要类型级;用了类型级就必须配对 delete。
四、三类典型场景:错误注入、观测增强、数据旁路
场景一,driver 侧错误注入。这是 callback 最经典的使用场景,也是站内 UVM 错误注入策略 里推荐的手段之一。做法就是在 driver 的「事务即将驱动到总线」处埋 pre_drive 触发点,测试派生回调在 ref 事务上动手术:翻转 CRC、截断长度字段、把 valid 延迟一拍生效。相比在 sequence 里生成错误事务,callback 注入的优势是「注入点离总线最近」——sequence 层生成的错误事务会经过 driver 主链路的全部处理(握手计算、打包),有些错误形态(比如驱动时序本身违规)只有在 driver 层才能表达。注入类回调建议返回 bit 表示「是否丢弃这笔」,让「随机丢包」这类故障模型也能用同一扩展点表达。
场景二,monitor 侧观测增强。monitor 的职责是把总线波形还原成事务广播出去(参见 UVM monitor analysis imp),但不同测试对「看到事务后做什么」需求不同:某个测试想对特定 opcode 采样功能覆盖,另一个测试想把某类事务写进 trace 文件。在 monitor 的「事务还原完成、即将 write 广播」处埋一个 post_sample 回调,测试挂自己的采样/落盘逻辑,monitor 主体保持纯净。这类回调不该改事务内容(观测者不该碰被观测对象),只读使用,纪律上建议在回调类的文档注释里写明「只读扩展点」。
场景三,数据旁路与加工。scoreboard 比对前对预期数据做一层转换、寄存器写之前对地址做重映射、覆盖率采样前对字段做归一化——这些「过一道手」的需求都可以做成 callback。UVM reg callback pre post 讲的寄存器模型 pre_write/post_read 钩子就是这个模式在 RAL 里的官方落地。数据加工回调因为用 ref 参数改数据,要特别注意「默认空实现必须返回放行值」,否则忘了重写的基类回调会把数据流截断——这是新手写 callback 最高发的 bug:派生类只重写了感兴趣的方法,基类其他方法返回的默认值把组件行为改掉了。
三个场景的共同模式是:组件作者只需要在「事务过手的咽喉要道」各埋一个触发点(发送前、接收后、写出前),测试侧的无穷变化全部走注册路线。组件作者的埋点成本很低,但埋哪里需要判断力——埋少了测试不够用,埋多了组件代码被宏切割得支离破碎。经验值:一个组件 2-4 个触发点是舒适区,超过这个数通常说明组件本身该拆了。
五、回调链的执行语义:顺序、短路、调试
多个回调挂在同一触发点上时,uvm_do_callbacks 按注册顺序遍历执行,这一节的细节决定链式使用时的行为。
顺序问题前面提过:先注册先执行,ref 参数沿途传递。如果业务上要求「注入回调先跑、采样回调后跑」(采到的是注入后的数据),注册顺序就得按此排,并在测试注释里写明依赖——靠注册顺序表达业务依赖是脆弱的,更稳的做法是让组件提供两个不同触发点(pre_drive 给注入、post_drive 给采样),用触发点位置而不是注册顺序表达先后。
短路语义:UVM 的 uvm_do_callbacks 本身没有内建短路机制(不像 uvm_report_catcher 有 CAUGHT 动作),如果业务需要「某个回调处理后后续回调不再执行」,要自己通过回调方法的返回值或共享标志实现——常见做法是回调把组件句柄当上下文用,在组件里写一个公共标志位,后续回调先检查它。UVM report catcher 是 UVM 里另一套回调式机制(挂在消息系统上),它的 caught/demote 语义可以看做 callback 思想在报错通路上的特化实现。
调试手段:回调不生效时按三层排查。第一层查注册——uvm_callbacks 提供 display 能力,在触发点前后打印当前挂接的回调列表,确认回调确实挂上了、挂在了预期的实例上(对象级注册挂错实例路径是常见失误,uvm_config_db 的通配作用域问题在 UVM config_db wildcard scope 里讲过,注册路径同理要逐字符核对)。第二层查触发点——在回调方法第一行放 uvm_info,确认组件真的走到了 do_callbacks。第三层查顺序——多个回调时打印执行序列,确认没有互相覆盖。这三层自上而下,九成问题在第一层就现形。
六、选型边界:callback 与 override、sequence、config_db
callback 不是银弹,四种扩展手段各占一块领地,划错边界比不用更糟。
| 手段 | 变化粒度 | 改动成本 | 适合场景 | 不适合场景 |
|---|---|---|---|---|
| callback | 组件内部单点插入 | 派生小类加注册一行 | 错误注入、观测增强、数据加工 | 整体替换算法 |
| factory override | 整个类替换 | 派生全类、维护合并 | 换一种 driver 实现、换协议模型 | 只改一行的注入 |
| sequence | 激励内容层 | 写 sequence | 改发什么数据、什么时序 | 改组件行为本身 |
| config_db 配置 | 组件作者预埋的开关 | 加字段加分支 | 数量有限、可预知的模式切换 | 场景开放增长时 |
读表原则:问「变化的是数据还是行为、是单点还是整体」。改激励内容用 sequence,这是 UVM sequence driver scoreboard 的主战场;整体换实现用 override(选型细节见 UVM factory 环境派生 与 UVM factory override 审计);可枚举的模式切换用 config_db(基础见 UVM config object 与 resource db);只有在「组件内部某个时机插一段开放的行为」时,callback 才是唯一正解。
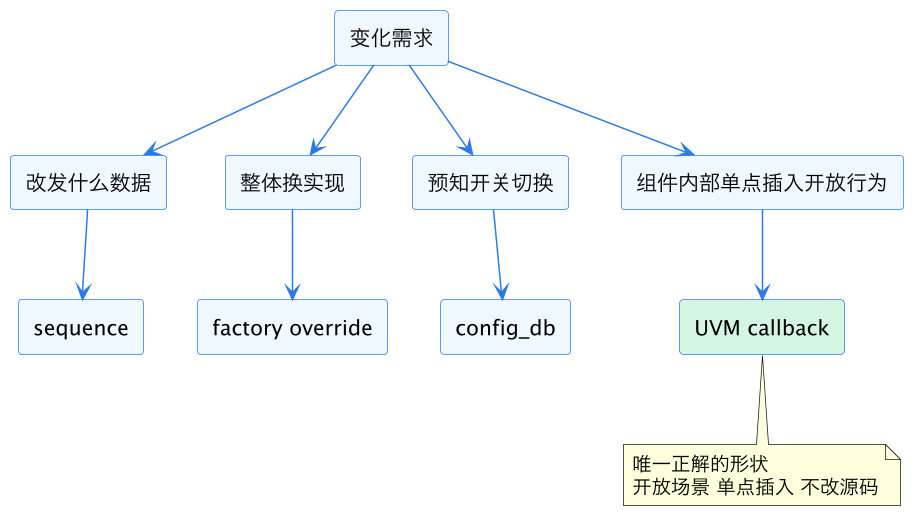
最后给一条架构纪律:callback 扩展点属于环境的「公开契约」。组件作者埋了触发点,就等于承诺这个位置、这套参数长期稳定——测试代码会依赖它。所以扩展点的设计要和组件 API 一样慎重:参数用句柄不用内部字段、语义写在注释里、升级时保持向后兼容。一个环境如果从头到尾不埋任何扩展点,等于宣告「所有行为变化都请来改我源码」,这在需要长期复用的 IP 级环境里是不可接受的,testbench 分层架构复用 讲复用维度时强调的「可扩展接口」正是指这类预埋。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录下 UVM 机制线的一篇标准深文,关键词 UVM callback。向上,它承接 UVM 组件与 phase 的组件骨架与 SV 回调钩子 的语言层原型,把「回调语法」推进到「UVM 三件套工程用法」。横向,它与四篇互补:UVM 错误注入策略 把 callback 作为注入手段之一放进完整的注错方法论;UVM reg callback pre post 是同一思想在寄存器模型里的官方形态;UVM report catcher 是回调思想在消息通路上的特化;UVM factory override 审计 管另一种扩展手段的滥用排查。向下,callback 支撑的观测增强汇入 代码与功能覆盖率 的采样体系,环境的可扩展设计汇入 testbench 分层架构复用。
总结
UVM callback 是「不改组件源码、在组件咽喉要道插入开放行为」的标准化扩展点机制:组件作者用 uvm_callback 派生类声明空实现钩子、uvm_register_cb 配对登记、uvm_do_callbacks 在发送前接收后等时机触发,测试侧派生回调重写方法并用 uvm_callbacks::add 挂接——对象级注册做点射式错误注入与数据加工,类型级注册做平台级观测但须配对 delete,多回调按注册顺序链式执行且 ref 参数沿途可见;选型上改数据用 sequence、整体替换用 factory override、可枚举开关用 config_db,只有「开放场景的单点行为插入」才是 callback 的领地,而扩展点一旦埋出就是环境的公开契约,设计要和 API 一样慎重。