cudaMallocAsync 内存池:stream 序分配语义、release threshold 与碎片控制
更新时间:2026-10-04。前面 CUDA 统一内存 讲过托管内存怎么用页迁移省掉手工拷贝,锁页内存与传输 讲过 H2D/D2H 拷贝为什么必须走 pinned buffer。这两篇关心的是「数据怎么搬家」,本篇关心的是另一个问题:显存本身怎么借怎么还。传统的
cudaMalloc/cudaFree是同步、昂贵、还和流(stream)并发作对的老式接口;CUDA 11.2 引入的cudaMallocAsync/cudaFreeAsync把分配器换成了 stream-ordered 内存池(stream-ordered memory pool),让分配变成几乎零成本的异步操作。pytorch 的 caching allocator、vLLM 的显存池背后都是同一套思想。本篇把它的语义、阈值和碎片行为讲透。
本文要回答的问题
cudaMallocAsync相对cudaMalloc到底改了什么,「stream-ordered」是什么意思?- 在同一个流上 free 之后立刻再 malloc,内存能被复用吗?跨流复用为什么危险?
- release threshold 控制什么行为,默认 0 会引发什么线上症状?
- 内存池的碎片从哪里来,
cudaMemPoolTrimTo什么时候用? - 推理服务(动态 shape、continuous batching)该怎么配池子?
一、老式 cudaMalloc 的三宗罪
先看清要解决什么问题。cudaMalloc 有三个结构性毛病。
第一,它是设备级同步操作。调用它时,CUDA 运行时要向驱动申请整段 VA(virtual address,虚拟地址)空间并建立页表映射,这个过程会隐式同步设备——所有正在跑的流都得等。一个 kernel 跑得正欢,host 侧一次 cudaMalloc 就把整条流水线掐停。
第二,它的粒度粗、成本高。驱动按大块分配,小块请求照样付全价,频繁 malloc/free 的 workload(比如每个 iteration 分配临时 buffer 的训练循环)会把大量时间烧在分配器里。实测中一次 cudaMalloc 的开销在几十到几百微秒,而一次 cudaMallocAsync 命中池子时只要几微秒——两个数量级。
第三,它和 stream 语义脱节。cudaFree 之后的内存何时能被安全复用,老式接口不给出任何和流关联的保证,程序员只能全局同步后再复用,进一步放大停顿。
PyTorch 当年自己造 caching allocator(缓存分配器)就是为了绕开这三宗罪:free 的块不还给驱动,留在进程内的池子里下次复用。cudaMallocAsync 相当于把这套做法收编进了 CUDA 运行时官方实现。
二、stream-ordered 语义:复用的合法性来自「程序序」
cudaMallocAsync(ptr, size, stream) 的核心约定一句话:内存的生命周期跟着流的执行顺序走,而不是跟着 host 侧的调用时刻走。
具体规则:
- 在流 S 上
cudaMallocAsync拿到的指针,可以立刻被流 S 上后续的 kernel 使用,无需任何同步——因为 kernel 排队在分配操作之后,流内天然有序。 - 在流 S 上
cudaFreeAsync归还的块,流 S 上后续的cudaMallocAsync可以立即复用它,同样因为流内有序:复用这个块的 kernel 排在 free 之后,而 free 排在之前所有使用者之后。 - 跨流复用不受保护。流 S free 的块,池子可能把它发给流 T 的 malloc;如果流 S 上还有 kernel 在读这块内存,而流 T 的 kernel 已经开始写,就是数据竞争。要么用 event 做跨流依赖(record event on S,T wait event),要么
cudaStreamSynchronize之后再还。
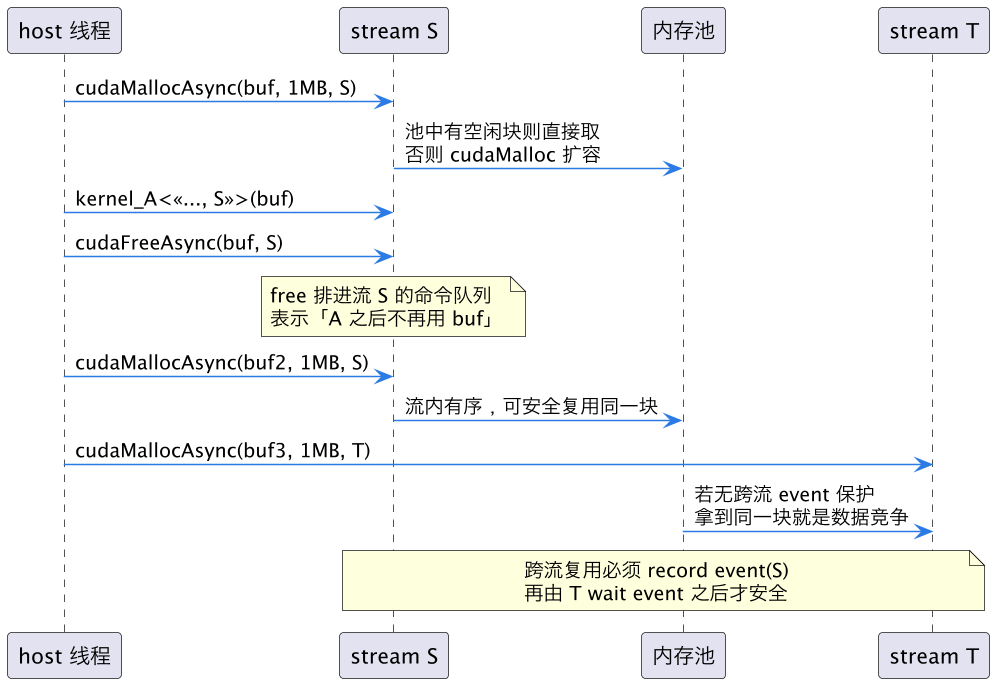
上图把「合法复用」和「危险复用」画在了一张图里:流 S 内部的 malloc→use→free→malloc 形成一条命令链,池子复用永远安全;而 stream T 来借同一块内存时,没有任何机制保证 S 的 kernel 已经跑完。很多从老式分配器迁移过来的代码就是栽在这里——老代码里 free 后全局同步是隐含的,新接口把同步责任交还给了程序员。
这套语义对推理框架极其友好。以 continuous batching 场景 为例:每个调度轮次要按当前 batch 形状分配临时激活 buffer,形状每轮都变。用 cudaMallocAsync 把分配挂在计算流上,分配开销从百微秒级降到微秒级,且不再打断在跑的 decode kernel。
三、release threshold:池子什么时候「吐」显存给系统
池化分配器的天性是要囤:free 的块留在池里等复用,不还给驱动。问题是囤多少算够?尤其多进程共享一张卡(或者同进程里 PyTorch 和 TensorRT 各开各的池)时,一个池子囤住 10GB 不放,别人就 OOM 了。
控制阀门是内存池属性 cudaMemPoolAttrReleaseThreshold(释放阈值)。语义:每发生一次「真实同步点」(stream synchronize / device synchronize / event synchronize),池子会检查空闲块总量,超过阈值的部分归还给驱动。
默认值是 0——意思是每次同步点池子清空,全部还掉。这对「池化」初衷几乎是自残:每个 iteration 末尾一旦同步,下个 iteration 的 malloc 又得重新向驱动要内存,付出和老式接口同级的成本,还顺带制造 VA 空间的反复映射/解除映射。

上图给出三档配置和各自症状。工程上的定值流程:开发期把阈值设成 UINT64_MAX(只进不出)跑典型压测,用 cudaMemPoolGetAttribute(pool, cudaMemPoolAttrUsedMemHigh, &v) 读出池子的历史使用峰值;稳态 workloads 的峰值就是阈值候选,再留 10%~20% 裕量。上线后如果流量有潮汐(白天推理、夜里训练混部),夜间跑 cudaMemPoolTrimTo(pool, 0) 主动把池子修剪到指定大小,把显存让给训练进程。
四、碎片从哪里来,怎么压
池化分配器会碎,机理和任何堆分配器一样:不同大小、不同寿命的请求交错,把连续空闲空间切成渣。CUDA 内存池的碎片有两层。
第一层是池内碎片:free 列表里一堆小块,来了个大的装不下,只能再向驱动扩池。池子的 ReservedMemCurrent(向驱动保留的总量)和 UsedMemCurrent(实际用掉的)之间的差越拉越大。读这两个属性的比值是体检池子健康度的最直接指标,长期低于 60% 说明碎得厉害了。
第二层是跨池碎片:每个 stream 默认挂自己的默认池(也可以用 cudaMemPoolCreate 建显式池、多个流共享),A 池里躺着大量空闲块,B 池照样找驱动要新的。缓解办法是共享池——把多个流指到同一个 cudaMemPool_t 上,但代价是回到第二节的跨流复用安全问题,同步纪律必须自己管住。
控制碎片的手段按性价比排序:
- 请求尺寸归一化:把分配尺寸向上取整到少数几档(256B/1KB/4KB/...),块的可复用率立刻上升。PyTorch 的 allocator 就是这么干的。
- 按寿命分池:长寿命的(模型权重、KV cache)和短寿命的(激活临时 buffer)用不同的池,避免短寿块把长寿池切碎。
- 定期 trim:低峰期
cudaMemPoolTrimTo强制合并归还,代价是下一个高峰要重新扩池。 - 改不了形状就改调度:连续 batching 里把 shape 相近的请求凑一轮,分配尺寸序列会平滑很多,碎片自然少。
| 维度 | cudaMalloc / cudaFree | cudaMallocAsync / cudaFreeAsync |
|---|---|---|
| 同步性 | 设备级隐式同步 | 流内有序,host 不阻塞 |
| 单次分配开销 | 数十到数百微秒 | 命中池时几微秒 |
| 复用保证 | free 后需全局同步才安全 | 流内 free 后立即可复用 |
| 显存归还 | free 即还驱动 | 囤在池里,同步点按阈值释放 |
| 碎片控制 | 驱动内部,不可见 | 属性可读、阈值可调、可 trim |
| 多流场景 | 无争用问题(反正都同步) | 需 event 守护跨流复用 |
五、推理服务的配置建议
把前面几节收拢成一份落地清单。
动态 shape 越多的系统,越离不开内存池:vLLM 类 serving 框架每轮 batch 组成都在变,激活 buffer 尺寸跟着变,用 cudaMalloc 等于每轮掐一次流水线。建议配置:threshold 按稳态 P99 工作集设;KV cache 这类「一次分配、贯穿全程」的大块走独立显式池,不进默认池,避免被激活块的频繁借还切碎;多流推理(比如 prefill 流和 decode 流并行,见 CUDA stream 异步重叠)时跨流借用 buffer 一律 event 守护,别省这几行代码;最后把 UsedMemHigh 和 ReservedMemCurrent 接进监控,阈值漂移和碎片恶化都能提前看见。
这一篇在知识体系里的位置
本篇是 CUDA 内存子系统中「分配器」这一环:上游是 CUDA 统一内存(页迁移式托管,另一种省心的内存模型)和 锁页内存与传输(H2D 通路的 buffer 管理);同层对照 GPU 显存层次与带宽(显存物理侧)与 KV cache 推理显存(池化思想在 serving 层的大规模应用);配合 CUDA stream 异步重叠 理解多流下的复用安全。
总结
cudaMallocAsync 把显存分配从「设备级同步的系统调用」变成「流内排队、池里复用的微秒级操作」:同一条流上 free 后立即可复用、跨流复用必须 event 守护;池子囤不囤显存由 release threshold 决定——默认 0 每次同步清空等于白池化,设成稳态工作集才能在性能和多进程共享间两全;碎片靠尺寸归一化、按寿命分池和低峰 trim 三招压,配合 UsedMemHigh/ReservedMemCurrent 监控,动态 shape 的推理服务就能把分配开销从瓶颈清单里划掉。