UVM virtual register:用虚拟寄存器/字段建模非地址映射逻辑寄存器,与间接寄存器的分工
更新时间:2026-10-03。UVM 寄存器模型默认假设「一个寄存器一个地址」,但真实芯片里总有一类东西打破这个假设:状态字高位在 0x10、低位在 0x24,软件读它们要拼两次访问;或者某个 64 位计数器横跨两个 32 位地址。UVM 用 virtual register(uvm_vreg)和 virtual field(uvm_vreg_field)来建模这种「逻辑上是寄存器、物理上没有独立地址」的对象。同目录里 UVM 寄存器块与 map 结构 讲了常规寄存器的地址组织,UVM 间接索引访问 讲了带索引/数据对的间接寄存器;这一篇把 virtual register 讲透,并划清它与间接寄存器的分工。
本文要回答的问题
- 什么样的寄存器该建成 uvm_vreg,它与普通 uvm_reg 的本质差别在哪?
- virtual field 怎么挂到多个底层寄存器的字段上,读写时怎么扇出?
- 虚拟寄存器的前门/后门路径怎么实现,callback 要覆盖哪些钩子?
- virtual register 与 uvm_reg_indirect_data 间接寄存器怎么分工,别混用?
一、什么场景需要 virtual register
典型的三种长相。第一种是跨地址拼接:一个 64 位时间戳计数器,低 32 位在 0x40,高 32 位在 0x44,软件要原子语义的「读一个寄存器」,硬件却给了两个地址。第二种是字段聚合:一个「设备健康状态字」,ready 位在控制寄存器 bit3、error 码在状态寄存器 bit[7:4]、温度值在传感器寄存器——逻辑上是一个寄存器,物理上是三个寄存器的字段拼起来的。第三种是纯组合派生:某个值根本不是存储的,是若干底层字段按公式算出来的(比如实际分频比 = (N+1)×(M+2))。
这三种的共同点是:对验证环境的读写者来说,它们应该表现得像一个寄存器——有 mirror、能 read/write、能进 covergroup——但 UVM 默认的地址翻译帮不了你,因为没有一个地址对应它。这就是 uvm_vreg 的位置:它不挂在 map 的地址空间里,而是自己实现 read/write,把一次逻辑访问翻译成若干次对底层真实寄存器的访问。
二、uvm_vreg 与 uvm_vreg_field 的结构
结构上,virtual register 由若干 virtual field 组成,每个 virtual field 挂在一个父 virtual register 下,但它本身不背存储——存储在底层的 uvm_reg_field 里。建模分两步:先把真实物理寄存器照常建成 uvm_reg/uvm_reg_field,挂进 block 的 map;再建 uvm_vreg/uvm_vreg_field 作为逻辑视图,vreg 不 add_reg 到 map(加了会占假地址),只 add_hdl_path 声明后门拼接关系。
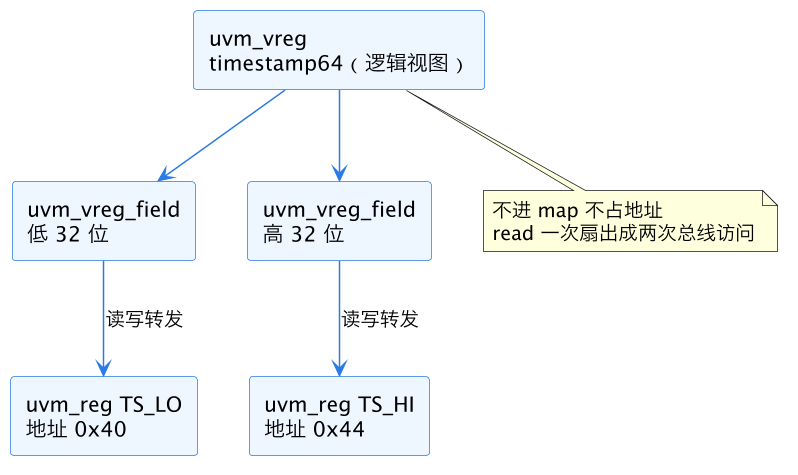
上图是一个 64 位虚拟寄存器的典型结构:逻辑视图在上,物理实现在下,一次 vreg.read() 在底层展开成两次前门总线事务,读回的 32 位值拼接后放进 vreg 的 mirror。对 scoreboard 和 sequence 来说,它们只看见一个 64 位寄存器。
三、前后门读写路径怎么实现
virtual register 没有默认的前门实现——UVM 不知道你的拼接规则,所以 uvm_vreg::read/write 默认直接调 pre_read/post_read 加 XMR 后门,或者干脆报 not-implemented。工程上有两条路。
第一条路是用 vreg_field 的 parent 机制:如果每个 virtual field 恰好一一对应某个底层寄存器字段,可以不重写 read/write,改为在 vreg 的子类里实现 write/read,遍历自己的 field 列表,对每个 field 调用其关联底层字段所在寄存器的 read/write,再把值按位拼接。这是最常见的写法,配合 UVM 寄存器回调 pre/post 在 pre_write 里做原子性检查(比如 64 位计数器高低 32 位读之间禁止被改写,读法是先读高、再读低、再读高比对)。
第二条路是完全自定义:对「组合派生」类 vreg(存储根本不存在),重写 read 为「读两个底层寄存器、按公式计算返回值」,write 为「反解公式、拆写两个底层寄存器」。这类 vreg 的 mirror 语义要特别小心——UVM desired 与 mirror 语义 里 mirror 是「上次硬件确认的值」,派生值每次 read 都会变,建议把这类 vreg 标成 volatile,并在 predict 策略上用 explicit prediction,参见 UVM 自动预测与显式预测。
后门路径上,vreg 通过 add_hdl_path_slice 逐段声明 HDL 层级路径,UVM 的 backdoor 机制会把多段 slice 拼成完整位向量,细节可对照 UVM 后门 HDL 路径。注意 vreg 的 slice 顺序就是拼接顺序,写反了后门读回的值会高低位颠倒,前门后门对不上时第一个要查这里。
四、与间接寄存器的分工:别混用
这是最容易踩的坑,因为两者都是「访问一个寄存器需要多次总线事务」,但机制完全不同。
间接寄存器(uvm_reg_indirect_data)是硬件给了一个索引/数据窗口协议:先写 index 寄存器选槽位,再读写 data 寄存器拿到该槽位的值——比如 256 个表项共用一个地址对。它有真实的、固定的地址(index 和 data 各一个),UVM 有内建类处理访问序列,adapter 接法和 UVM 寄存器模型集成 一致,内建寄存器序列(如 UVM bit-bash 序列)都能直接跑。
virtual register 是软件侧的逻辑视图:物理上各个字段散落在真实地址上,每次访问要散打到多个不同的地址。它没有 UVM 内建的访问序列(要你自己写 read/write),也不适合跑内建寄存器序列。
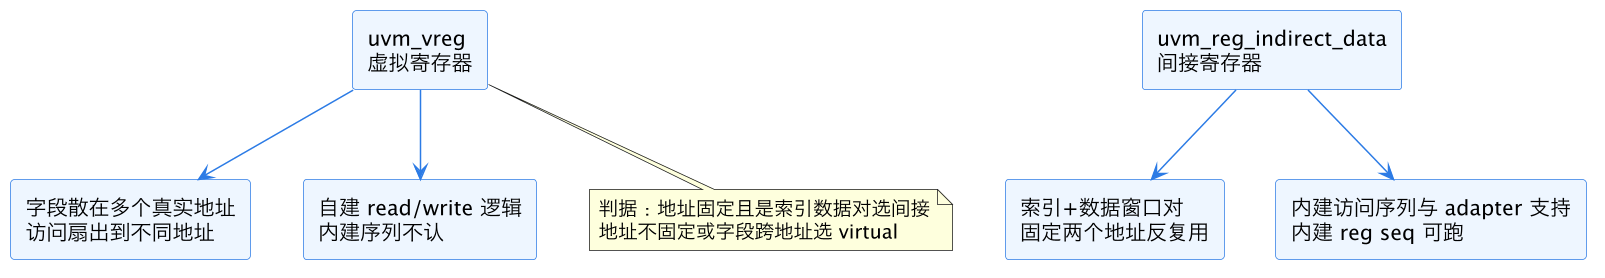
上图给出选型判据:看底层地址形态。固定一个「索引+数据」地址对、槽位在硬件内部复用,用间接寄存器(详见 UVM 间接索引访问);字段散在多个不同地址、或者根本没有独立存储,用 virtual register。两者甚至可以叠加——一个 vreg 的底层字段本身位于间接窗口后面,此时 vreg 的 read/write 里调间接寄存器的 read/write 即可,层次保持清晰。
五、验证与覆盖率的收口
virtual register 的验证重点是拼接正确性和访问原子性。覆盖点上,对 vreg 建 covergroup 采样逻辑值域(比如 64 位计数器的 0、满量程、高低位翻转边界),采样时机放在 vreg 的 post_read 里,与 UVM 寄存器覆盖率采样 的做法一致。检查侧,前后门对照是性价比最高的手段:sequence 走前门读 vreg,checker 走后门 peek 同一 vreg 比对,拼接顺序、slice 声明错误立刻现形。对 UVM volatile 字段访问 类 volatile vreg(比如只读计数器),还要在 pre_predict 里禁用 mirror 陈旧性检查,避免误报。
还有一个调试习惯值得养成:vreg 出问题时的排查顺序固定为三步——先单独读写每个底层寄存器确认物理层没问题,再走后门 peek 整个 vreg 看拼接位序,最后才在前门 read 上加波形。大多数「vreg 读回值错位」最后都落在 slice 声明顺序或者字段扇出时漏了某个底层寄存器的 reset 值,一上来就追前门波形会绕远路。团队规范上建议把 vreg 集中放在 block 文件末尾、命名带 _v 后缀(如 timestamp64_v),评审时一眼能把逻辑视图和物理寄存器分开。
总结
UVM virtual register 是给「逻辑上是一个寄存器、物理上没有独立地址」的对象建的一层软件视图:uvm_vreg/uvm_vreg_field 不进 map 不占地址,靠自建 read/write 把一次逻辑访问扇出成对底层真实寄存器的多次访问,后门靠 add_hdl_path_slice 声明拼接路径。选型的判据一句话:地址形态是固定索引/数据窗口对用 uvm_reg_indirect_data 间接寄存器,字段跨多个地址或纯派生值用 virtual register——两者都能叠加,但别把扇出逻辑塞进间接类里,层次一乱,前后门对账和内建序列就全废。