sequencer 独占仲裁:lock 与 grab 的语义差异、抢占死锁与释放纪律
更新时间:2026-09-29。UVM sequence 与 sequencer 仲裁机制 讲了 SEQ_ARB_FIFO、SEQ_ARB_WEIGHTED 等常规仲裁模式怎么选;那一篇有个隐含前提——每个 item 独立参与仲裁。可总线协议里常有一类需求:一个 sequence 要连续发一串 item,中间不许别人插队。这就是
lock/grab存在的意义,也是 sequencer 独占仲裁的全部内容。driver 侧怎么配合取 item,另见 UVM driver 与 sequence 的 item 流转。
本文要回答的问题
lock和grab都拿到 sequencer 独占权,语义差在哪?- 相对优先级(
start_item的 priority)在独占面前还有没有用? - 两个 sequence 互相
lock等待对方释放,为什么会死锁,怎么破? unlock/ungrab的书写纪律是什么,忘了会怎样?
一、为什么需要独占:常规仲裁管不了的场景
默认情况下,sequencer 每来一个 item 就仲裁一次。假设两个 sequence 都在发 AXI 写事务:sequence A 发寄存器配置序列,sequence B 发背景流量。如果 A 的「写使能寄存器」和「写数据寄存器」两个 item 之间被 B 插了一条读,DUT 侧协议可能依然合法,但测试意图被破坏了——你想验证的是连续配置,不是交织配置。更糟的是有些协议根本不允许交织:比如要先发 unlock 命令紧跟 key 序列的安全寄存器,中间插任何其他事务都会触发错误。
这时需要的是「批量原子性」:把一段 item 流整体锁定在 sequencer 上。UVM 给两个 API:
task cfg_seq::body();
  // 连续写 4 个寄存器,中间不许别人插队
  lock();
  repeat (4) begin
    `uvm_do(req)
  end
  unlock();
endtask
lock() 返回后,直到 unlock() 为止,sequencer 只接收本 sequence 的 item。注意 lock 是阻塞的:如果 sequencer 正被别的 sequence 独占,或者按仲裁规则排不到你,lock() 就挂在那里等。
二、lock 与 grab:排队者与插队者
两个 API 都拿独占权,差别只在拿不到时的行为:
lock():礼貌排队。它按常规仲裁规则参与竞争,等轮到自己才获得独占权。此前已在跑的 sequence 正常完成。grab():强行插队。立即挂起当前正在发 item 的其他 sequence,直接抢到独占权。被挂起的 sequence 停在当前 item 边界,等ungrab()后恢复。
一张时序图看三者的交互:
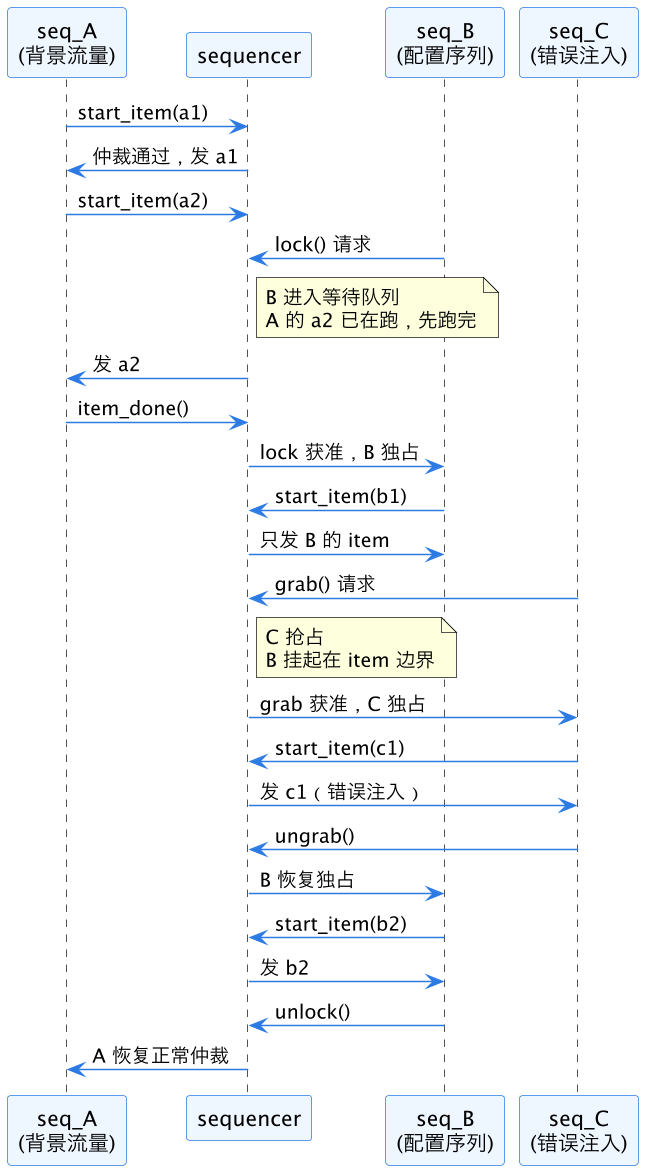
这张图抓三个要点。第一,lock() 不是立刻生效的:B 请求 lock 时 A 的 a2 正在发,B 等到 a2 完成才拿到独占权——这就是「按仲裁规则排队」的含义。第二,grab() 是异步抢占:C 在 B 独占期间 grab,B 被冻结在 b1 与 b2 之间的 item 边界上,sequencer 上能看到的现象是 B 的 item 流中间突然插进了 c1。第三,释放是嵌套恢复的:C 的 ungrab 把独占权还给 B 而不是直接归还公共仲裁,因为 B 的 lock 还没释放。
用一句话记:lock 排队,grab 插队;被 lock 等的是「轮到我」,被 grab 打断的是「正在跑」。
| 维度 | lock / unlock | grab / ungrab |
|---|---|---|
| 获取时机 | 按仲裁规则排队,轮到才独占 | 立即抢占,挂起当前 sequence |
| 被打断方的状态 | 不存在(等完了才轮到你) | 冻结在当前 item 边界 |
| 典型用途 | 协议要求的连续 item 流 | 错误注入、高优先级打断 |
| 死锁风险 | 双 sequence 互 lock 会死锁 | grab 本身不死锁,但嵌套不当会 |
| 优先级影响 | 受 priority 影响 | 不受,无视优先级 |
还有一个值得说清的边界:独占锁的是 sequencer 的仲裁入口,不是 driver。driver 的 get_next_item / item_done 握手完全不受影响,它甚至感知不到独占的存在——它只看到 item 一个接一个一个来源稳定地来。这意味着独占窗口内的时序压力全部转移到 sequence 侧:如果你的 lock 段里某个 item 构造耗时很长(比如调用了复杂的约束求解),独占就被白白占着,其他 sequence 干等。经验法则是独占窗口越短越好,能在 lock 之前算好的数据绝不放进 lock 段里。
三、优先级与独占的叠加规则
常规仲裁下 start_item(req, priority) 的优先级管排序。独占介入后规则变成两条:
grab永远赢。无论别的 sequence 优先级多高,grab 一到立刻让位。lock仍走优先级。多个 sequence 同时lock(),按仲裁模式(FIFO / weighted / priority)决定谁先拿到;拿到后,独占期间其他 sequence 的 item 优先级再高也插不进来。
这里有个反直觉的坑:lock 持有期间,本 sequence 自己的 item 之间不仲裁,但 lock 等待阶段是参与仲裁的。也就是说一个 priority = 1 的 sequence 调用 lock(),可能永远排不过 priority = 100 的 lock 竞争者。若你的 lock 迟迟拿不到,先查是不是优先级被压了,而不是怀疑 lock 坏了。
四、抢占死锁:互锁的成因与解法
经典事故:sequence X 和 Y 各自需要先拿 sequencer 独占、再拿一个共享资源(比如 register model 的 semaphore):
// sequence X:先 lock sequencer,再拿 reg semaphore
task seq_x::body();
  m_sequencer.lock(this);
  reg_sema.get();
  ...
endtask

// sequence Y:顺序反过来
task seq_y::body();
  reg_sema.get();
  m_sequencer.lock(this);
  ...
endtask
X 持有了 sequencer 在等 reg_sema,Y 持有 reg_sema 在等 sequencer——双方 lock() 都是阻塞 task,仿真时间不再前进,波形上看就是两个 sequence 都停住,test 直到 timeout 才报。这就是标准的循环等待死锁,和操作系统课上的哲学家就餐同构。
解法沿用死锁四条件的老三样,落到 UVM 里最实用的是统一资源获取顺序:
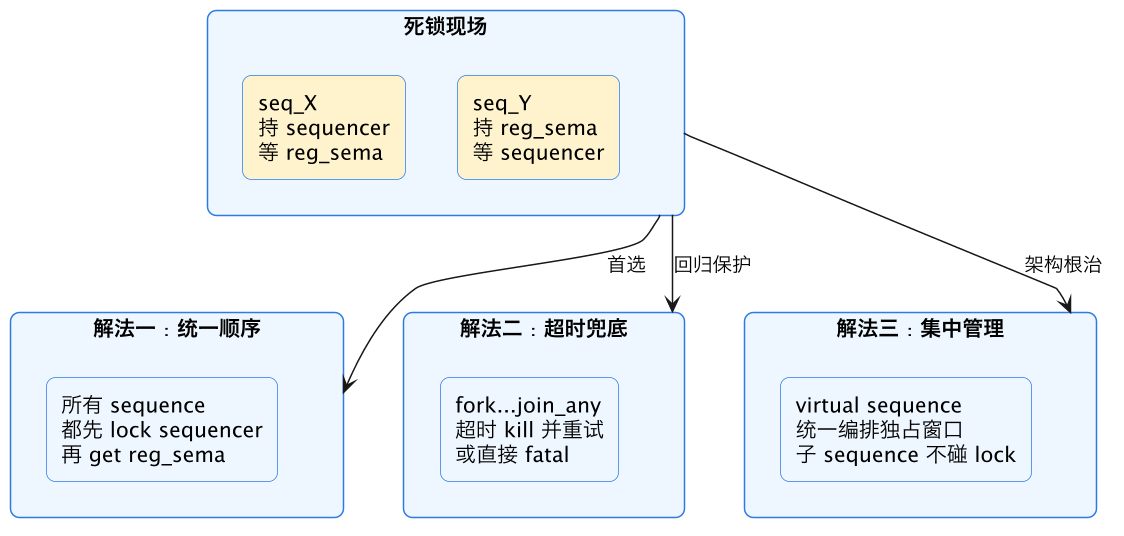
三种解法对应三个层次。统一顺序是纪律:全环境约定「先 sequencer 后 reg_sema」,不许反过来,code review 把关。超时兜底是防线:给 lock() 包一层 fork ... join_any 超时,比如 10us 拿不到就 uvm_fatal 带现场信息——死锁从「hang 到 regression timeout 三小时后才发现」变成「10us 内报尸」,调试成本天差地别。集中管理是架构:只有 virtual sequence 允许碰 lock/grab,子 sequence 只管发 item,独占窗口由编排者统一划分,从结构上消灭交叉持锁的可能。
还有一类隐蔽死锁:lock 与 grab 混用的自锁。sequence 持有 lock 时自己又调 grab(比如在错误回调里),某些场景下会形成自己等自己的路径。纪律是:一个 sequence 同一时刻只用一种独占方式,不嵌套。
五、释放纪律:unlock 必须成对出现
lock 拿到独占权后,如果 sequence 因为异常路径提前 return、被 kill、或者干脆忘了写 unlock(),sequencer 就永久卡死——其他所有 sequence 的 start_item 都排队等一个永远不会来的释放,driver 端表现为 get_next_item 永远阻塞,仿真安静如鸡,直到超时。
工程纪律三条:
- unlock 写在 finally 式路径上。SystemVerilog 没有 try/finally,用子 task 或宏保证所有退出路径都走到 unlock。最稳妥的写法是把独占段封成一个 task,task 末尾无条件 unlock。
- kill 场景显式释放。如果测试会在中途 kill sequence(比如 phase jump 或主动 stop),kill 前确认它不在独占窗口内;否则在 environment 层补一句防御性的
sequencer.stop_sequences()前先 unlock。 - 回归加一条「独占泄漏」检查。test 结束时检查 sequencer 的
is_blocked()/ 仲裁队列状态,发现还有未释放的独占直接报 error。这把「偶发 hang」变成确定性失败,能在单测阶段就抓住。
这一篇在知识体系里的位置
- 上游:UVM sequence 与 sequencer 仲裁机制 讲常规仲裁模式与优先级,本篇的 lock/grab 是仲裁机制上的独占层。
- 配合:UVM driver 与 sequence 的 item 流转 讲 driver 侧 get_next_item/item_done 的握手,独占期间该握手不变,只是仲裁入口被收窄。
- 死锁背景:共享资源语义可参考 UVM event pool 与 barrier 同步 里对多 sequence 同步原语的讨论。
总结
sequencer 独占仲裁用 lock 与 grab 两种 API 实现「连续 item 不被插队」:lock 按仲裁规则排队、礼貌获取,grab 立即抢占、挂起当前 sequence,被 grab 打断的 sequence 在 ungrab 后于 item 边界恢复;工程上三大纪律——lock 等待阶段仍受优先级影响、多资源场景统一获取顺序防循环等待死锁(给 lock 加 fork 超时兜底)、unlock 必须在所有退出路径上成对出现——做到这三条,独占窗口可控,仿真不会因泄漏的 lock 安静挂死。