数据中心功耗入门:从单芯片到机柜,电费怎样成为第一成本
更新时间:2026-09-15。本文是「集成电路大类 · 低功耗设计与验证」入门层系统篇第 42 篇。很多人以为低功耗只是手机和手表的事,但在云计算和 AI 时代,数据中心是低功耗技术最大的买单方之一:一座大型集群三年的电费可能超过买服务器的钱,单机柜功率密度正把风冷逼到极限。这一篇把视角从芯片拉远到供电链路、机房散热和运营指标,看看同一套物理规律在兆瓦尺度上长什么样。系统地图见低功耗导读。
本文要回答的问题
- 从墙上插座到芯片,中间到底浪费了多少电?
- PUE 是什么,为什么 1.1 比 1.5 重要那么多?
- AI 机柜几十千瓦的功耗从哪来,散热怎么反过来影响芯片功耗?
- 「功率封顶」是什么,它和芯片上的 DVFS 怎么联动?
- 芯片级的省电手段在数据中心语境有什么不同的目标?
一、供电链:每一瓦都过好几道收费站
数据中心的电要经过多级变换才能到晶体管,每级有效率 η:
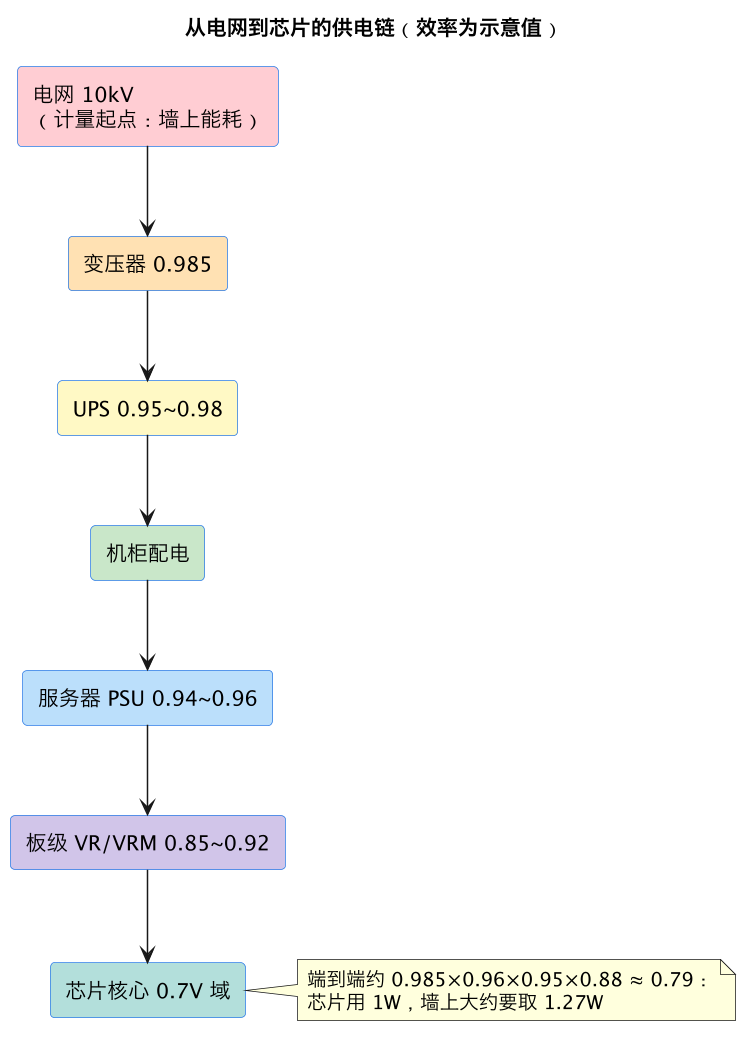
两个直接结论:
- 芯片省 1W,墙上不止省 1W:供电和散热被连带省掉,放大系数约 1.3~1.5 甚至更高(再算冷却)。这放大了芯片低功耗设计的商业价值。
- 轻载时效率塌:PSU/VR 都有最佳负载区间,服务器在 20% 负载时电源效率显著下降——低利用率是双重浪费(芯片每任务能效差 + 变换器效率差)。
板级 VR 到芯片这一段与电源管理芯片讲的 buck 完全同构,只是电流大几个数量级(单封装数百到上千安培),PCB 铜皮、电容阵列和封装 C4 凸点都是供电路径(见电源网格)。
二、PUE 与冷却:看不见的另一半电费
PUE = 数据中心总能耗 ÷ IT 设备能耗。理想值 1.0(所有电都进了服务器);普通老机房可能 1.5~2.0(每 1W 计算电再花 0.5~1W 养空调),现代优效机房靠热通道封闭、变频冷机、自然冷却可到 1.1~1.2。
冷却方式随功率密度演进:
- 风冷:经济成熟,但单机柜散热上限约二三十千瓦,AI 机柜(几十甚至上百千瓦)扛不住;
- 冷板式液冷:液体直接带走 CPU/GPU 冷板热量,风液混合可支撑高功率密度,余热还可回收供暖;
- 浸没式液冷:整机泡在绝缘冷却液,散热上限更高,省去大量风扇功耗。
冷却反过来影响芯片:进风/冷却液温度决定了结温,而漏电随温度指数上升(见漏电与工艺)。同样一帧推理,机房热失控时芯片漏电更高、睿频更短——所以「散热设计」和「芯片功耗签核」在数据中心是耦合优化,IR-drop 签核必须覆盖高温高电流角(见 IR-Drop,多工艺角联合签核见待写篇《多角多模签核》)。
三、AI 时代的指标:每焦耳产出
手机看毫安时,数据中心 AI 看每焦耳完成的有用功:J/token、J/inference、images/sec/watt。原因是业务计费和扩产决策都由「每个请求的电钱」驱动。能效差异来自:
- 数据移动:HBM 和互连在 AI 加速卡里常占可观功耗,和片上「搬运比计算贵」(见存储器功耗)是同一规律的放大版;
- 量化与专用化:低精度数据通路直接削 V²C 里的电容和翻转,NPU 相对 GPU、GPU 相对 CPU 的能效代差主要来自专用化(见低功耗趋势);
- 规模不经济的边界:集群越大,跨节点通信和供电散热损耗占比越高。
四、功率封顶:机房版的 DVFS
机柜和机房有硬性供电/散热配额(签约容量、断路器、冷量),但服务器实际功耗随负载波动很大。**功率封顶(power capping)**让集群管理系统给每台机器设功率上限:负载冲高逼近上限时,通过 BMC/驱动要求芯片快速降压降频(运行 RAPL 一类机制,本质是DVFS的系统级闭环),把整机房功率压在契约线内。这样机房可以按「平均+可控峰值」而不是「所有机器同时满载」的极端值规划供电,显著提高部署密度——芯片 DVFS 的响应速度和曲线质量因此成了数据中心的基础设施能力,不只是手机的省电功能。
五、Race-to-halt:快跑完去睡,还是慢慢跑?
数据中心和移动端共享一个经典争论:一个任务,是高频短时跑完再让节点进入低功耗态(race-to-halt),还是压低频长时间慢跑?
- 动态功耗 ≈ CfV²,高频要高压,能量按 V² 涨;低频低压跑单位时间省电但通电久。
- 是否「快跑完睡」划算,取决于睡眠态省多少和高频电压溢价多大:若睡眠确实接近零功耗且任务不可中断,race-to-halt 常占优;若睡眠状态仍有大固定开销(DRAM 自刷新、PHY 待机,见外设功耗)、或任务持续到来根本没有空闲可睡,压低频更省。
- 数据中心还有利用率维度:让一半服务器高负载、其余深度休眠/关机,常比全部机器低载蠕动更省电(变换器和芯片都在高效区),但要付作业调度和冷启动延迟(容器/虚拟机拉起、缓存预热)的代价。
这本质上是待机模式 residency问题在机房尺度的重现:任何低功耗态的价值都等于「深度×驻留时间−进出代价」。
六、运营层手段
- 负载整形与削峰:把可延迟任务(批处理、训练、备份)调度到供电富余/电价低谷/自然冷却充足时段,减少按峰值建设的容量浪费。
- 提升利用率但守住能效区:容器化和混部把服务器利用率从个位数提到更高,但要监控单位工作能耗而非只看利用率——超过热设计点后 DVFS 降频反而做负功。
- 分级存储与数据移动:数据中心跨网络搬运的能耗(交换机、光模块,即PHY 功耗的巨型版)可观,计算向数据靠拢(存内处理、本地推理)常比搬数据划算。
- 碳/电指标联动调度:在电网低碳时段跑训练,使能效指标扩展到碳强度。
七、和芯片设计的闭环
数据中心的需求会沿供应链倒推到芯片:
- TCO 模型要求供应商给真实典型负载下的每焦耳性能,而不是峰值 TOPS——这要求硅前用真实软件活动率做 DPA(见 DPA与仿真器功耗);
- 功率封顶要求 DVFS 档位细、响应快、曲线可预测,推动电压调节(AVS/SVI,见 PMIC)和每核域设计;
- 高温角下漏电与 IR-drop 签核更严(多角联合签核见待写篇《多角多模签核》);
- 加速器间的高速 Die-to-Die/UCIe 互连本质上是在封装内重做「低摆幅短互连」的省电文章(见低功耗趋势的 Chiplet 讨论)。
一个拆解算例:某加速卡硅芯计算功耗 500W。板级 VR 效率 0.88、PSU 0.95、PUE 1.15 时,墙上年度成本为 500÷0.88÷0.95×1.15≈689W 连续,一年约 6,035 度;若硅芯通过架构+DVFS 降到 400W,墙上取电同比降到约 551W——芯片上省下的 100W 在账单上是 138W,这就是云厂商深度参与芯片能效定义的根本动力。
八、服务器整机功耗构成:一个典型拆解
以一台双路加速服务器为例(比例为教学示意,绝对值代际差异大):
| 部件 | 满载占比直觉 | 功耗特点 |
|---|---|---|
| CPU | 15%~25% | DVFS 响应快,功率封顶第一抓手 |
| GPU/加速卡 | 40%~60% | 最大头,含卡上 HBM 功耗;受温度强烈影响 |
| DRAM | 8%~15% | 容量越大刷新基数越高,随通道数增长 |
| 风扇/散热 | 5%~10% | 自身耗电随芯片功耗正反馈:芯片越热风扇越猛 |
| 网卡/光模块/SSD/主板杂项 | 5%~10% | 光模块是常耗件,空闲也有底噪 |
| PSU 损耗 | 已含在总入口 | 轻载效率塌,低利用率时占比上升 |
两个反直觉点:其一,内存和风扇在很多集群里被预算忽略,但合计可吞掉两成;其二,所有部件都随温度加价——进风温度提高一度,风扇功耗和漏电两头上涨,所以「免费的自然冷却」也要受芯片可靠性窗口约束。
九、从机房到芯片的功耗指标谱系
避免不同会议上各说各话,把指标层级一次理清:
- 设施级:PUE(总/IT)、WUE(水耗)、碳使用效率 CUE;
- 机柜/服务器级:kW/rack、整机 idle/typical/max 功率、PSU 效率曲线;
- 部件级:TDP(散热规划值,不等于真实功耗上限)、典型业务功率、功率封顶档;
- 任务级:J/request、J/inference、tokens/J、queries/watt——唯一直接和业务成本挂钩的一层;
- 硅签核级:典型/最大动态功耗、漏电(各 PVT 角)、瞬态峰值与 IR-drop 裕量(见电源网格)。
云厂商采购决策最终看的是任务级指标反推的 TCO,因此芯片宣传的峰值 TOPS 必须能翻译成「典型模型、典型批量、典型温度下的每焦耳产出」才有谈判价值。
十、液冷普及带来的设计侧变化
制冷方式不只影响机房账单,也在反向改变芯片封装和板级设计:冷板直接贴在散热器上意味着芯片顶部成为主散热路径,传统靠气流带走热量的表面贴电容、供电模块布局要重新评估;液冷供回水温度高于传统冷风时,芯片实际结温可能反而更高(换热介质温度抬升),漏电签核角要按新的稳态温度重定;机柜级三相配电和整机柜 PSU 取代分散小电源后,板级母线电压提高(如 12V→48/54V),板上 VR 级联方式改变,大电流母排与最后一级多相降压的布局成为电源完整性新课题(机理见 PMIC 篇与电源网格)。一句话:制冷和供配电方案已是芯片功耗约束的输入,而不是事后配套。
十一、冷数据与闲置:被忽视的规模浪费
集群里与计算功耗并列的另一项是「为持有数据而耗电」:温冷数据放在高速 SSD/DRAM 上要付刷新和空闲底噪,分层存储(热数据在高速介质、冷数据下沉到高密硬盘甚至光盘/磁带)能在几乎不损失业务的情况下显著降功耗;长期低利用率的实例和僵尸服务(代码还在跑、业务已下线)持续占用内存并阻止节点进入省电态,需要靠资产治理和负载整合清理。这类优化不涉及任何芯片技术,却常是数据中心最快兑现的省电收益——和芯片侧「先杀常驻漏电」(见功耗预算实战示例)是同一条经验在不同尺度上的重演:固定开销的治理永远优先于动态峰值的压榨。 此外供电侧也有可挖的固定损耗:老旧 UPS 常年轻载效率低下、机柜级 PSU 转换级数过多、备用电池浮充损耗,都是 PUE 治理中与 IT 负载无关却常年存在的「机房漏电」,治理思路与芯片上查 AON 域多余常耗件如出一辙。
- 误区:数据中心不在乎功耗,只在乎性能。 多年 TCO 里电费常超过设备购置,且供电配额直接限制扩容。
- 误区:PUE 到 1.1 就万事大吉。 PUE 只衡量非 IT 开销;IT 设备本身的每焦耳工作效率(芯片+内存+互连)是更大的另一项。
- 误区:利用率越高越省电。 越过热设计点后降频和漏电反扑会使每任务能耗反升,要按 J/任务而非 % 利用率管。
- 误区:关机最省所以激进休眠。 唤醒的冷启动、缓存重建和 SLA 延迟可能抵消收益,residency 要算账。
这一篇在知识体系里的位置
- 上游:芯片侧机制(DVFS、漏电温度、IR-Drop)在大尺度上原样成立并被放大。
- 本片:把视角从「毫安时」拉到「兆瓦与 TCO」,补齐低功耗的另一端。
- 下游:需求如何倒推架构趋势见低功耗趋势;电源链组件见 PMIC。
一句话收口:数据中心低功耗不是把手机那套放大,而是同一物理规律沿供电链和散热链被层层放大后的经济问题——芯片上的每一焦耳,在电表上都带着供电、冷却和容量规划三重乘数。
总结
数据中心里电费和散热已成为 TCO 首要构成:电从电网经变压器、UPS、PSU、板级 VR 到芯片逐级损耗,芯片省 1W 在墙上放大成约 1.3~1.5W,再叠加 PUE 冷却开销;管理焦点是每焦耳 token/推理、功率封顶与利用率陷阱,而芯片 DVFS 的快速可控响应因此从手机省电功能变成了机房按峰值规划容量的基础设施能力。