FPGA 入门 07:LUT 与 FF 深入——查找表怎么变成任意电路
更新时间:2026-09-12。本文是
fpga/入门层第 09 篇的深入版。架构全貌见 FPGA 架构基础,两大可综合范式见 组合与时序逻辑,存储见进阶 BRAM 与存储设计。读完这篇,你应当能回答:为什么一块"查表的存储器"能实现任意逻辑电路?6 输入 LUT 为什么还要能拆成两个 5 输入?为什么 FPGA 既能跑随机逻辑又能顺手做加法 / 小 RAM / 延迟线?以及——为什么同样能跑,有的设计能上 300 MHz、有的连 50 MHz 都收敛不了。
一、先立观念:FPGA 里没有"与门工厂",只有查表 + 连线
很多人第一次学 FPGA 会有一个隐含误解:以为写了 a & b,工具就去芯片里"造"一个与门;写了加法器,就"拼"出一排全加器。这是 ASIC 的思路,不是 FPGA 的思路。
FPGA 出厂时,内部逻辑资源的晶体管结构已经固定。你买到的是一片铺满了"逻辑块 + 可编程连线 + 可编程开关"的硅片,配置信息(比特流)只决定两件事:
- 每一小块存储里写什么数;
- 每个可编程开关接通还是断开。
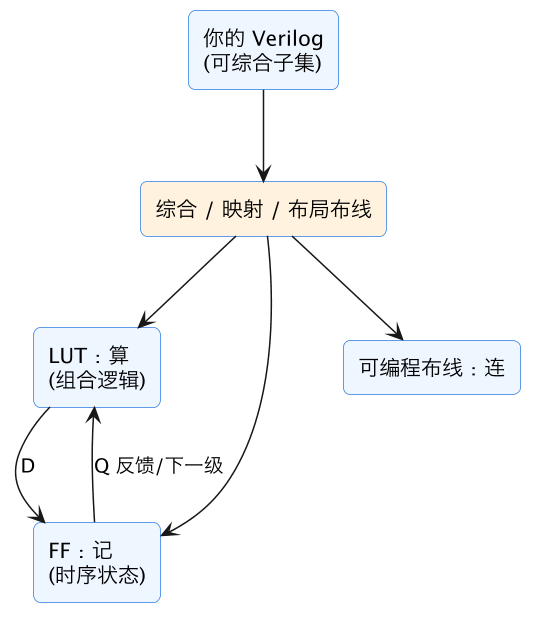
仅此而已。所以"用 FPGA 实现一个电路",本质是把你的布尔函数翻译成一堆存储位 + 一张连接关系表。承担"算"的最小单元,就是这一篇的主角 LUT(Look-Up Table,查找表);承担"记住状态"的,是它旁边的 FF(Flip-Flop,触发器);负责"连"的,是遍布芯片的布线矩阵。
记住这条主线,后面所有结论都是它的推论:
LUT 负责"算"(组合逻辑),FF 负责"记"(时序状态),布线负责"连"。你的每一行可综合 Verilog,最终都被翻译成这三样东西的占用方式。
二、LUT 就是一张写满答案的小表
2.1 物理本质:一小块 SRAM
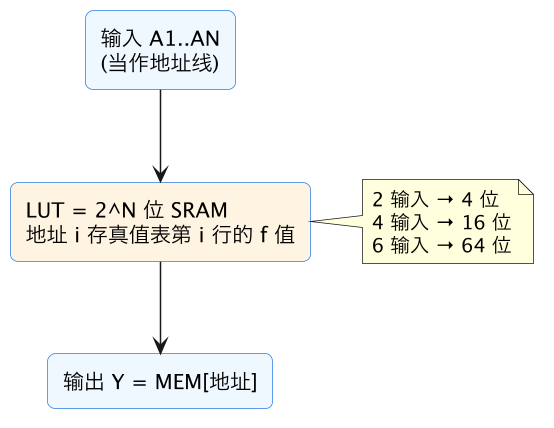
LUT 物理上极其朴素——一小块 SRAM 存储器 + 一组选择结构。一个 N 输入 LUT,包含 2^N 个 1 位存储单元:
- N 个输入信号,直接当作这小块 SRAM 的 N 根地址线;
- 地址选中的那个存储单元,其存储的 0 或 1 被送到输出。
任意一个 N 输入布尔函数 f(x₁,…,x_N) 都对应一张 2^N 行的真值表。你把真值表输出那一列逐行填进 LUT 的存储位,每来一组输入就查到那一行的答案。只要输入数不超过 N,无论与、或、异或、多数表决还是毫无规律的乱码函数,对 LUT 都成本相同——都是查一次表,延迟也几乎相同。这正是 FPGA 灵活的根源:它不关心函数"长什么样",只关心"几个输入"。
2.2 动手:用 4 位存储实现一个与门
2 输入与门 Y = A & B 的真值表共 4 行,填进一个 2 输入 LUT(4 位存储):
| 地址(AB) | 函数值 Y | LUT 存储位 |
|---|---|---|
| 00 | 0 | MEM[0]=0 |
| 01 | 0 | MEM[1]=0 |
| 10 | 0 | MEM[2]=0 |
| 11 | 1 | MEM[3]=1 |
配置后只有 AB=11 时输出 1,其余为 0——行为与与门分毫不差。想换成异或门?不用改任何硬件,只需把存储位改成 0110(地址 01、10 存 1)。同一个物理 LUT,改几个配置比特就是另一种门。再比如 Y = A^B | (A & ~C) 这种你懒得化简的函数,只要输入数 ≤ N,照样一张表平铺直叙地装下,无需手工化简、无需门级搭建。
对比 ASIC:ASIC 实现一个与门约需 6 个晶体管(CMOS 与非 + 反相),而一个 6 输入 LUT 要用上百个晶体管(64 个 SRAM 单元 + 一棵 MUX 选择树)。FPGA 用面积和速度上的冗余换来出厂后仍可重定义函数的灵活性——这也是 FPGA 单位逻辑比 ASIC 慢、单位功能功耗更高的根本原因之一。
2.3 内部其实是一棵 MUX 选择树
"查表"在晶体管层面如何实现?经典结构是二选一多路器(MUX)级联成的选择树,SRAM 单元挂在叶子上。以 2 输入 LUT 为例,4 个存储位 I0~I3 存真值表,输入 A、B 作选择端:B 先从每对里二选一,A 再从两对结果里二选一,最终输出的恰好是被 AB 选中的那个 I。
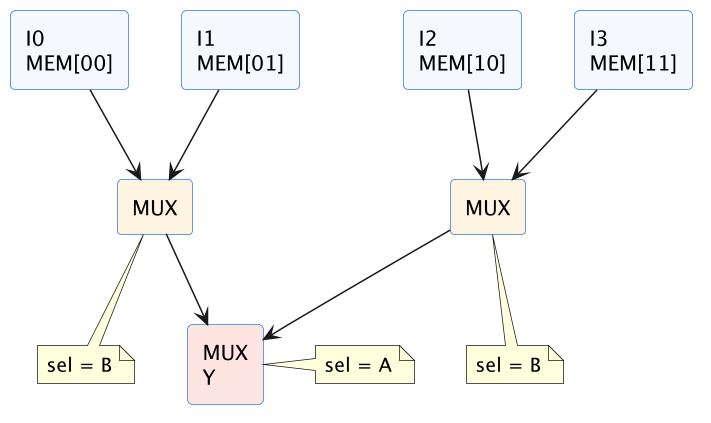
推广到 N 输入,这是一棵 N 层、共 2^N−1 个二选一 MUX 的满二叉树。输入每增加一个,存储位和选择器都翻倍;信号从叶子穿到根要经过 N 个串联 MUX,这正是单次 LUT 延迟的物理来源,也解释了为什么函数从 5 输入变 6 输入不会变慢太多(只多穿一层 MUX),而拆成两级 LUT 却要额外付出一整次 LUT + 布线的延迟。
三、现代 FPGA 为什么是 6 输入 LUT,还能"一分为二"
历史上 FPGA 用过 3 输入、4 输入 LUT(Xilinx 4-LUT 时代、Intel 长期 4-LUT),现代主流架构(Xilinx 7 系 / UltraScale / Versal、Intel Agilex 等)普遍收敛到 6 输入 LUT。这不是拍脑袋:LUT 太小则实现常见函数要串联多级、慢且费布线;LUT 太大则 2^N 存储位指数膨胀、利用率低。6 是面积、延迟、利用率之间的工程甜点。
更关键的是它的双输出拆分结构。一个 6-LUT 有 64 个存储位、6 根地址线 A1~A6,以及两个输出 O5 与 O6:
- 用作一个 6 输入函数:A6 作最高地址位,在两张 32 位半表之间做最终选择,结果从 O6 输出,实现任意 6 输入逻辑(O5 此场景不用)。
- 拆成两个 5 输入函数:当两个函数共享 A1~A5 这 5 个地址、但相互独立时,第 6 位 A6 不再当地址,两张 32 位半表各存一个独立函数,分别从 O5、O6 输出。于是同一个物理 LUT 同时干两件 5 输入的活。
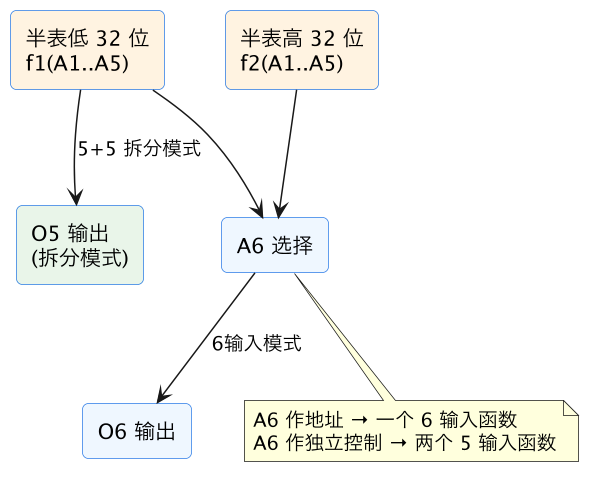
为什么这个拆分对你很重要?真实设计中绝大多数组合函数只有 4~5 个输入(一个 if 的条件、一个简单 ALU 选择)。若 6-LUT 只能整体使用,大量面积会被浪费。正因为能拆成两个 5-LUT,综合器常把两个互不相干的小逻辑塞进同一个物理 LUT——这就是为什么你在利用率报告里看到的 LUT 数,往往比"数出来的逻辑块"少。读报告时要同时看两个口径:LUT(被占用的物理 LUT,含拆分)与LUT 折合 / LUT as Logic;若某函数是 6~8 个输入,则会占 2 个甚至更多 LUT 级联。
各家命名与粒度略有差别:Xilinx 一个 slice 含 4(7 系)或 8(UltraScale)个 6-LUT + 等数量 FF;Intel 的 ALM(Adaptive Logic Module)可灵活实现 6 输入或两个更小函数,并有独立加法链。概念一致:一张可重构的小表 + 一个紧邻的触发器 + 专用算术/进位资源。
四、CLB、slice 与 LUT/FF 的成对关系
单个 LUT 不是独立封装的,它们被组织成层级结构。以 Xilinx 为例(Intel 对应 LAB/ALM,思想相同):
- CLB(Configurable Logic Block,可配置逻辑块):逻辑阵列里的一个"格子",包含 2 个 slice + 局部连线;
- slice:一个 slice 含若干 LUT、FF、进位链、多路器(7 系每 slice 4 个 6-LUT + 8 个 FF,UltraScale 每 slice 8 LUT + 16 FF)。slice 还分 SLICEL(只做逻辑/算术)与 SLICEM(LUT 可改作分布式 RAM / SRL);
- 每个 LUT 的输出旁都有一个专用 FF,且输出可选择直通(组合)或经 FF 寄存后离开 slice。
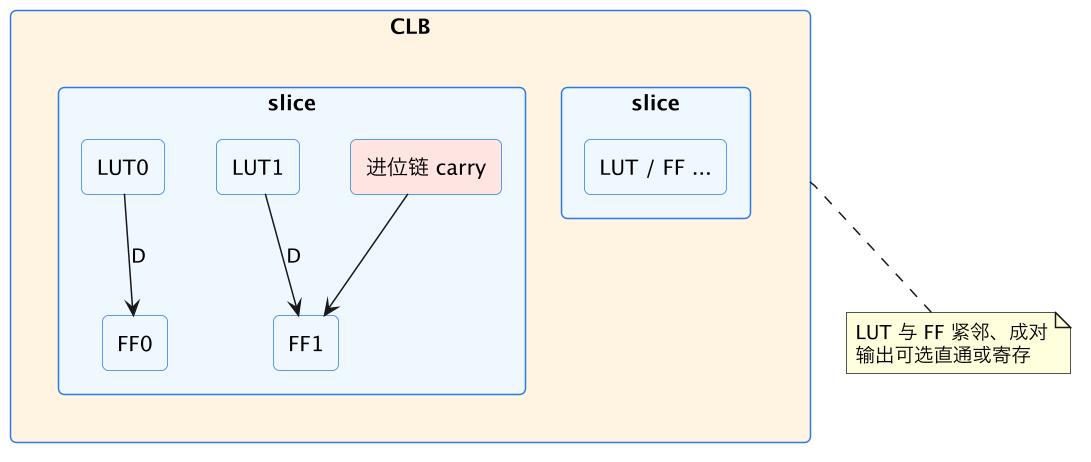
理解这套布局有两个工程意义:
- LUT→FF 是"零成本邻居"。当一段组合逻辑后面紧跟一个寄存器(最常见的时序写法),LUT 输出直接进同一个 slice 的 FF,布线极短、延迟极小。所以"组合 + 寄存"的规整数据通路天然跑得快;反而是纯组合、扇出巨大、需要跨很多 CLB的信号最容易成为时序瓶颈。
- 资源是分区位的。一个 slice 里 LUT 与 FF 数量固定,若你的设计 LUT 用满但 FF 大量空闲(深组合逻辑),或 FF 用满而 LUT 空闲(宽移位/宽寄存阵列),都会卡在某一种资源上。利用率报告要分别看 LUT、FF、BRAM、DSP、IO 各自水位,而不是只看一个总数。
五、FF 深入:时钟沿到底锁存了什么
5.1 D 触发器的行为契约
slice 里的 FF 本质是一个边沿触发的 D 触发器,行为可以用一句话和一张表概括:在时钟有效沿那一瞬间,把 D 端的值抓到 Q 端并保持;两个沿之间,无论 D 怎么变,Q 都纹丝不动。
| 时刻 | D 端 | FF 动作 | Q 端 |
|---|---|---|---|
| 非时钟沿 | 随便变 | 不响应 | 保持旧值 |
| 时钟上升沿 | 已稳定的 0/1 | 采样 D | Q ← D |
| 沿之后 | 可变化 | 已锁存 | 维持采样值到下个沿 |
这正是"时序逻辑"与"组合逻辑"的分野:组合输出立刻随输入变化(LUT 查表延迟后),时序输出只在沿上更新。FF 还带三根常用控制端:
- CE(Clock Enable,时钟使能):CE=0 时这个沿"跳过",Q 保持。对应
if(en) q<=d;,实现上是一个本地小使能,不必额外 AND 时钟; - SR/置位复位(set/reset):把 Q 拉到初始值。异步复位(
always @(posedge clk or posedge rst))走专用复位脚、可随时优先动作;同步复位只在时钟沿生效,通常综合成对 D 数据的选择。能用同步复位优先同步,复位策略要全设计统一(异步复位、同步释放是常见稳妥做法); - 初始值:FPGA 的 FF 上电值由配置比特决定,
initial q=0会成为上电初值——这是 FPGA 相对 ASIC 的一个便利,但跨芯片移植别依赖它做功能复位。
5.2 LUT 算、FF 记:把计数器拆开看
一个最能说明"算一拍、存一拍"的例子是带使能的累加计数器:
reg [7:0] cnt;
always @(posedge clk) begin
  if (rst)     cnt <= 8'd0;   // 同步复位
  else if (en) cnt <= cnt + 1'b1; // 下一拍 = 这一拍 + 1
end综合后它变成一条环形数据通路:8 个 FF 保存当前 cnt;其 Q 端接回加法器(LUT + 进位链算出 cnt+1 与复位/使能选择);加法结果接到这 8 个 FF 的 D 端;下个时钟沿,FF 统一把"算好的新值"锁存为新的 cnt。如此周而复始。
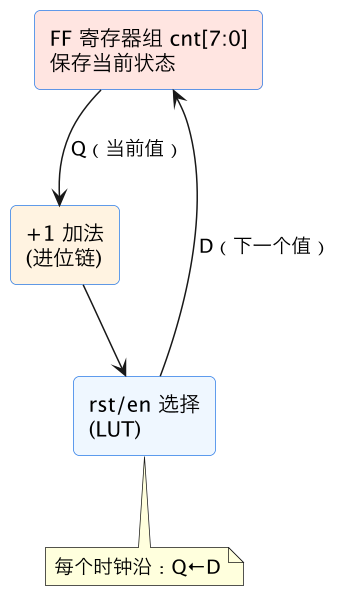
关键直觉:FF 保存的是"状态",LUT/进位链计算的是"下一状态函数"。任何同步时序电路——计数器、状态机、CPU 流水线寄存器——都能归纳为这张图:寄存器 + 组合反馈。你写的 always @(posedge clk) 里,左边 <= 的每个 reg 是状态(FF),右边表达式是下一状态逻辑(LUT/进位链/DSP)。
5.3 三种"用不用 FF"的输出形态
同一个 LUT 的结果,在硬件上有三种去向,综合器根据你的代码自动选:
- 只用组合输出(
assign y = ...或always @*):LUT 结果绕过 FF 直接出 slice,路径上没有时钟沿; - 只用寄存输出(
always @(posedge clk) q<=...):LUT 结果进 FF,Q 对外; - 两者都要:同一份组合逻辑既想立刻看、又想寄存一份——可由 LUT 同时驱动旁路输出和本 slice FF,不必重复算两次。
此外要区分 FF 与锁存器(latch):latch 是电平敏感的(时钟高电平期间透明、低电平保持),由不完整的 if/case 在 always @* 里意外推断,占的是"LUT + 反馈保持"而非干净 DFF,时序分析困难,初学者几乎总应避免(确保组合块所有分支都给所有变量赋值)。
六、LUT 的三大"副业":进位链、分布式 RAM、SRL
同一块 SRAM 存储体,配合 slice 里的专用硬件,可以不当组合逻辑,而改作算术、存储或延迟。理解这三种"副业",你才能看懂综合报告里那些不按"一个表达式一个 LUT"出牌的资源数字。
6.1 进位链:让加法又快又省
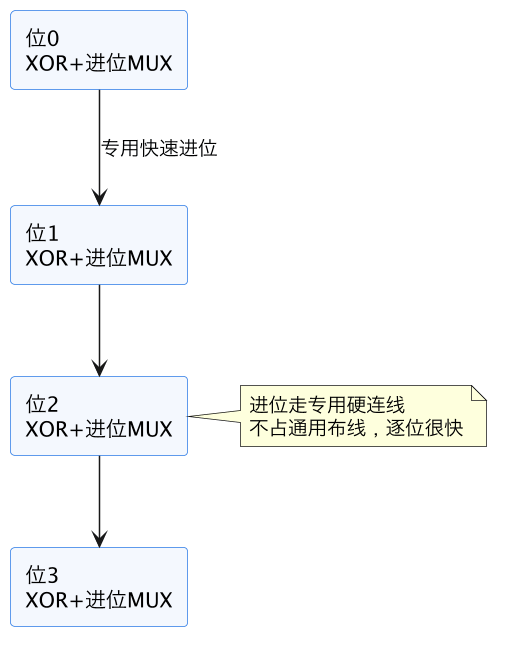
若用普通 LUT 逐位拼加法器,进位要一位一位地穿过多级 LUT,又慢又费。FPGA 在 slice 内部铺了一条专用的纵向进位链(carry chain),由专用进位 MUX + 异或门构成,进位信号沿这条"快车道"逐位传播,不占用通用布线、延迟远低于 LUT 级联。所以:
a + b、a - b、a < b、a == b、自增自减计数,综合器都会优先映射到进位链;- 你完全不需要、也不应该自己用门去搭加法器——手写门级通常比工具推断的进位链更差;
- 进位链是纵向相邻 slice 专用资源,因此位宽很宽的加法会在物理上排成一条竖列,这也是宽进位可能成为时序路径的原因(可分段/流水)。
6.2 分布式 RAM:把 LUT 存储体当真正的可写存储器
SLICEM 类型 slice 的 LUT 存储位支持运行时写入,于是单个/多个 LUT 可拼成一小块单端口/双端口 RAM 或 ROM,称为分布式 RAM(distributed RAM)。它和 BRAM 的取舍是经典考点:
| 维度 | 分布式 RAM(LUT 拼) | BRAM(专用块) |
|---|---|---|
| 容量 | 小(几十~几千位) | 大(18Kb/36Kb 一块) |
| 位置 | 散布在逻辑阵列里,贴着用它的逻辑 | 固定的存储列,需布线过去 |
| 位宽/深度 | 灵活,小表不浪费 | 有最小粒度,小表浪费 |
| 时序 | 异步读为主、浅 | 同步、可打拍、适合高速深存储 |
| 典型用途 | 小 FIFO、小查找表、深 16/32 的寄存器堆 | 数据缓冲、帧缓存、大 FIFO |
推断方式:小规模 reg [..] mem [0..N] 且按地址读写时,综合器常自动选分布式;也可用属性强制:
(* ram_style = "distributed" *) reg [7:0] lut_ram [0:63];
(* ram_style = "block" *)       reg [7:0] big_ram [0:2047];
6.3 SRL:一个 LUT 当 32 级移位寄存器
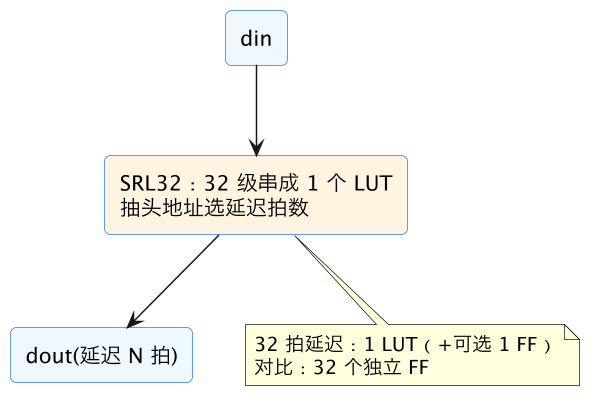
更巧妙的是 SRL(Shift Register LUT):把一个 6-LUT 的 32 个存储位串成一条移位链,配合地址选择从任意一级抽头输出,一个 LUT 就实现最长 32 拍的可变延迟线 / 移位寄存器(UltraScale 还可级联成 SRL64 等更长结构)。对比一下:
- 朴素实现:32 级
q[i+1] <= q[i];若每级都用 FF,要 32 个触发器; - SRL 实现:同样 32 拍延迟,只用 1 个 LUT(末级可再挂 1 个 FF 做时序对齐)。
因此写固定深度的流水线延迟、同步对齐链、滤波器抽头缓冲时,综合器常自动推断 SRL,报告里 FF 数会远小于"级数 × 位宽"。需要注意:SRL 内部各级不能并行直接访问(只能按地址抽头)、复位不会把整链清零(SRL 没有逐位复位),所以需要每级可读/可清零的移位寄存器仍得用真 FF。可用 (* srl_style = "register" *) 或 SHREG_EXTRACT="NO" 阻止推断。
七、和资源报告对账:一段代码到底占了什么
把前面的内容收成一张"Verilog 构造 → 物理资源"对照表,看综合 Utilization 报告时就能一一对应:
| 你写的代码 | 综合成的资源 | 备注 |
|---|---|---|
assign / always @* 里的与或非、选择 | LUT(as Logic) | 5 输入以内常两个函数共享一个 6-LUT |
时钟沿 always @(posedge clk) 里的 reg | FF | 位宽几位就几个;带 en 用 CE |
+ -、比较、自增减 | LUT + 进位链 | 别自己搭门 |
| 乘除、宽乘加 | DSP48/DSP58 块 | 简单/小乘法有时落 LUT |
| 大数组、深 FIFO、帧缓存 | BRAM / URAM | 同步读写推断 |
| 小查找表、小寄存器堆 | 分布式 RAM(LUT) | ram_style 可控 |
| 固定深度逐级延迟链 | SRL(LUT) | 省 FF,但无逐位复位 |
| 三态/双向、IO 寄存器 | IOB / 专用 IO 寄存器 | 可进 IOB 提时序 |
不完整组合 if/case | 意外 latch(应避免) | 占 LUT+反馈 |
读图要点:①LUT、FF、BRAM、DSP、IO 分别看水位,设计往往先卡在某一类;②同一份代码在不同器件/约束下推断结果可能不同,以综合日志的推断提示和 schematic 为准;③想验证理解,可对一个小模块跑综合后打开 Utilization 与 Schematic,亲手把代码里的信号在网表里找到对应 LUT/FF——这是建立直觉最快的方法。
八、为什么逻辑级数决定最高频率
LUT/FF 的微观结构,最终都落到一个天天打交道的指标:这条路径一个时钟周期能不能走完。
8.1 一条时序路径的时间预算
数据从一个 FF 的 Q 出发,穿过若干级 LUT 与布线,到达下一个 FF 的 D,必须在下一个时钟沿到来前、并提前一个建立时间就稳定:
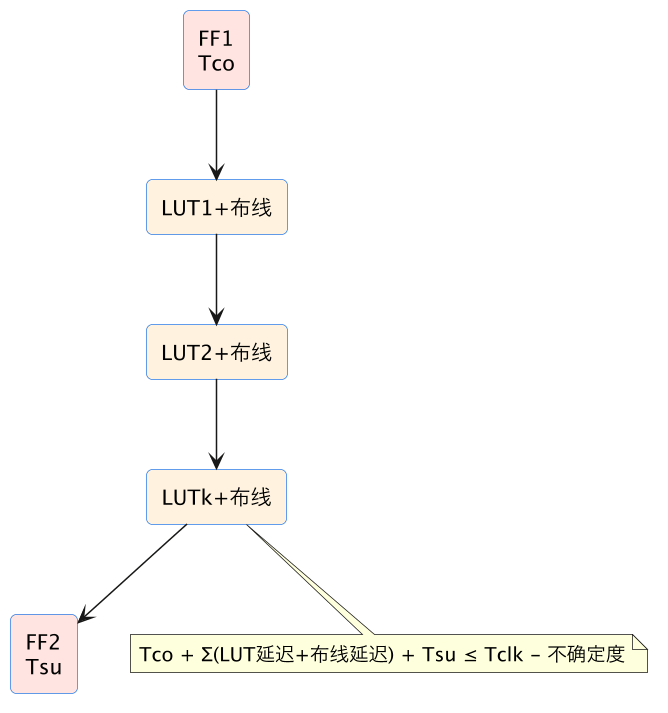
$$T_{co} + \sum_{i=1}^{k}(t_{LUT,i} + t_{route,i}) + T_{su} ;\le; T_{clk} - T_{uncertainty}$$
式中 k 就是这条路径的逻辑级数(logic levels)。LUT 每深一级加一份查表延迟;级数越多、布线越绕、驱动扇出越大,左边越大。周期 Tclk 必须容下它,于是最高频率被最长(最坏)的那条路径封顶,这就是关键路径(critical path)。
8.2 三种最有效的提速手段
- 插流水线(pipelining):把一长串组合逻辑切成几段,段间加 FF,每拍只穿几级 LUT。频率提高,代价是总延迟变多几拍、多用 FF、下游要配合多拍结果。
- 重定时(retiming):不改功能,让综合器自动把寄存器在组合逻辑间"挪动"到更均衡的位置,等效平衡每级深度。
- 降低单级延迟 / 扇出:高扇出信号(复位、使能、大 mux 选择)一个 LUT 驱动成百负载,布线延迟暴涨。可通过逻辑复制(max_fanout)、减少超大 mux 输入数、让加法走进位链、常量提前化简来缓解。
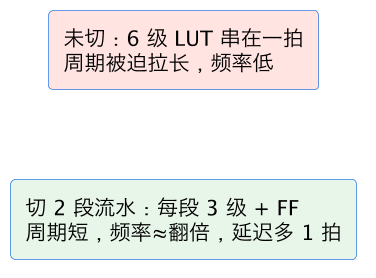
一个常被忽略的点:决定频率的是最长路径,不是平均深度。一百条短路径加一条极深路径,频率仍由那一条决定。优化不是"整体少用 LUT",而是找到时序报告里 slack 最差的那几条路径,精确砍它们的级数/扇出/布线。这也是面积优化(少占 LUT)与速度优化(降关键路径延迟)常方向不同、甚至相互矛盾的原因。
8.3 学会看两个报告位置
- 综合后 Utilization / Schematic:看模块大致用了几级 LUT、有没有意外推断成大片逻辑或 latch;
- 实现后 Timing Summary / 路径报告:看 WNS(Worst Negative Slack,最坏建立裕量)与具体路径的 Logic Levels、Net Delay。WNS 为负即未收敛;点开最差路径,顺着"FF→LUT…→FF"读,就知道该在哪一级插拍或复制。
九、位宽、符号与运算的「静默错误」:比语法错更难抓
仿真能过、综合不报错、上板结果却偶尔不对——这类最折磨人的 bug,很多出自位宽和符号处理。它们不触发任何编译错误,因为从语言角度看代码完全合法,只是运算结果不是你以为的那个。
先说位宽截断与扩位。Verilog 的表达式位宽由「上下文最大位宽」决定,规则微妙。一个典型错误是用不够宽的寄存器接累加结果:8 路 8 位数据相加,最大和需要 11 位,却仍赋给 8 位 reg,高位被静默丢弃,仿真在小数据时正常、数据一大就错且没有任何告警。反过来,比较时位宽不一致也会埋雷:把一个 4 位计数器和 15 比较没问题,和 16 比较时右边常量若被当成 4 位就永远不可能相等。稳妥习惯是:显式按「最坏值」定宽,累加器至少留出求和上溢的位数,常量写全位宽(如 8'd15),不要依赖隐式推断。宁可多留一位,也别让进位消失在黑箱里。
再说无符号与有符号的混算。Verilog-2001 之前所有 reg 默认无符号;一旦你把某些变量声明成 signed,却在同一个表达式里混入无符号变量、整数或位选择结果,整个表达式会被隐式提升为无符号,减法和比较立刻出错。比如一个有符号的差值和一个普通无符号计数器比较,你以为在比「负三小于五」,综合/仿真却把负三当成一个巨大的正数。常见对策是:全模块统一符号策略,跨符号边界时显式 $signed()/$unsigned() 转换并补足符号位;做有符号乘法时两个操作数和结果位宽要按「符号位扩展」规划(m 位乘 n 位有符号结果常取 m+n 位)。DSP 块也区分有符号/无符号输入,符号处理错了,落到的硬件结果同样偏。
第三类是运算顺序与括号。移位、拼接、条件运算符的优先级和直觉不完全一致,a + b >> 2 是先加还是先移?(实际加法优先级高于移位,但这类代码读起来极不可靠。)流水线里最常见的静默错误是「先截断后舍入」与「先累加后取高位」的差别:在错误的层级丢掉低位,量化噪声和增益全变。给所有非平凡表达式加括号、把「在哪一级取哪几位」写成带注释的显式切片,既是防错也是给半年后的自己留路。
第四类与寄存器与直通的时序差有关:同一个信号,这一拍从某级寄存器输出、下一处又直接用了它未寄存的组合版本,仿真不明显,上板却产生错位一拍的对齐问题——尤其在数据有效信号和数据本身要「同拍对齐」的流水接口里。原则是让一起使用的信号经过相同的流水级数,valid 随 data 一起打拍。这类问题在波形上表现为整体差一拍,定位时沿着「数据走了几级寄存器、控制走了几级」逐节数即可。
把这些和前文的阻塞/非阻塞、锁存器问题连起来看,会发现 HDL 的坑几乎都来自同一个反差:软件里算术就是算术、变量就是变量,而硬件里每根线都有确定的位宽、每个值都有 0/1 的物理表示、每次运算都对应真实的加法器/乘法器及其位宽。建立「位宽够不够、符号是什么、经过几级寄存器」这三连问的条件反射,能消灭绝大多数「没有报错但结果错」的疑难问题,也会让你写出的 RTL 在综合报告里更可预测。
十、从 LUT/FF 视角读综合报告:让利用率数字说话
学会了写出能综合的电路,下一步是读懂综合器回赠的那份资源报告——它是「你的代码到底变成了什么硬件」的对账单。这一节教你用 LUT/FF/BRAM/DSP 的语言反推代码质量。
先看总量与利用率。报告里通常有 Slice LUT、Slice Reg、Block RAM Tile、DSP48 等行,以及占用可用资源的百分比。三个直觉要建立:其一,LUT 和 FF 是两本独立的账,一个模块可能 LUT 富余而 FF 紧张,反之亦然,优化方向完全不同;其二,占用率不是越低越好,也不能太高——长期工程建议给布局布线留 20%~30% 余量,逼近 90% 后布线拥塞会让时序急剧恶化、编译时间暴涨;其三,不同规模器件上同一个设计的百分比意义不同,跨器件比较要看绝对数量。
再看LUT 数字里藏着的信息。如果你写的组合逻辑函数大多只有几个输入,LUT 数大致反映逻辑复杂度;但当 LUT 数远超预期,常见原因有:宽比较器/大 MUX(一个几十选一的选择器吃掉大量 LUT)、用组合逻辑实现了本该进 BRAM 的大查找表、意外锁存器、或者高扇出控制逻辑被复制。报告若单列「LUT as Logic」「LUT as Memory」,后者非零说明有分布式 RAM/SRL 被推断——这可能是你有意的小 FIFO,也可能是数组写法不当导致存储「散落」在逻辑资源里。看到 LUT as Memory 很大而你本打算用 BRAM,就要回去检查数组大小和同步读写写法。
FF 数量同样能反推。一个 N 位寄存器应贡献 N 个 FF;计数器、流水线、状态寄存器都按位累加。如果 FF 数明显多于你预期,检查:是否把本该是组合连线的信号寄存了、是否用了独热码之外还多留了冗余寄存器、移位寄存器是否没用上 SRL(逐级 shift <= {shift[...], din} 的规范写法本应被压成一个 SRL LUT,若它占了几十个 FF,说明写法或约束没让工具识别)。反过来 FF 数远少于预期也别高兴太早:可能是信号被常量传播优化掉了(逻辑确实不需要),也可能是你的复位/使能写错导致整段寄存器没推断出来——要结合仿真确认不是「电路没了」。
BRAM 和 DSP 是最能体现「有没有用上专用硬块」的指标。一个本应是 1024×16 的缓冲,如果 BRAM 行为 0、LUT 暴涨,说明它被综合成分布式 RAM 甚至 FF 阵列,容量一大必然不可接受;一个 FIR/乘加模块若 DSP 数为 0、LUT 巨大,说明乘法被软逻辑实现,频率和资源都会很差。让存储进 BRAM、乘法进 DSP,通常靠规范的同步读写模板、合适的位宽和(必要时)综合属性来引导。每次综合后花两分钟核对「该进块的有没有进块」,是性价比极高的习惯。
最后是用报告驱动优化迭代。正确姿势不是凭感觉改代码,而是:跑综合→读资源和(实现后的)时序报告→定位最差路径或异常资源→针对性改一处→重新综合对比数字。比如关键路径逻辑级数深,就插流水线,预期是频率上升、FF 略增;高扇出导致布线延迟,就复制驱动,预期是 LUT 略增、拥塞下降。把每次改动和报告数字的变化对应起来,你对「代码→硬件」的映射感会迅速变敏锐。读到这个程度,综合报告就不再是一堆令人发怵的百分比,而是你和工具之间关于「这版电路长什么样、健康不健康」的一份清晰对话——这也为后续时序收敛、面积/速度权衡的进阶主题打下了地基。
十一、常见坑对照
| 坑 | 后果 | 正确理解 / 做法 |
|---|---|---|
| 以为代码在"顺序执行" | 软件思维写硬件 | 代码描述 LUT/FF 的连接,always 不是函数 |
| 组合逻辑写很长一串 | 关键路径深、频率上不去 | 中间插寄存器切流水线 / retiming |
always @* 里 if/case 不完整 | 意外推断 latch | 补 else/default,所有分支给所有输出赋值 |
| 小查找表声明成大数组 | 浪费 BRAM 或推断不符预期 | 小表用分布式 RAM,必要时 ram_style 指定 |
| 以为 FF 输出随时随输入变 | 时序理解错误 | 只在时钟沿采样 D,两沿之间 Q 保持 |
| 手写门级加法器 | 比工具差、慢、费 LUT | 直接写 +/-/比较,让工具走进位链/DSP |
| 32 级延迟却以为占 32 个 FF | 资源对账对不上 | 多被推断成 1 个 SRL;需逐位访问/复位才用 FF |
| 只看资源总量不分类看 | 卡在某类资源还不自知 | LUT/FF/BRAM/DSP/IO 分别看水位 |
| 复位策略五花八门 | 复位树乱、时序差、难移植 | 全设计统一,优先同步复位或异步复位同步释放 |
| 优化"平均逻辑" | 频率没改善 | 只砍 WNS 最差的关键路径 |
相关与延伸
全貌:FPGA 架构基础;范式:组合与时序逻辑;时序直觉:时序报告入门。 深入:进阶 BRAM 与存储设计、流水线与资源优化;底层器件物理见芯片侧 CMOS 逻辑门与晶体管、锁存器与触发器。
一句话总结
LUT 物理上就是一小块 SRAM(N 输入 = 2^N 位存储,内部是一棵 N 层 MUX 选择树):输入当地址、地址里存的值当输出,把真值表写进去就能实现任意 N 输入布尔函数;现代 FPGA 用 6 输入 LUT,既可整体实现一个 6 输入函数(O6),也可拆成两个共享地址的 5 输入函数(O5/O6)以提高利用率。FF 是紧邻 LUT 的 D 触发器,只在时钟沿把 D 锁到 Q——LUT 负责“算”、FF 负责“记”,计数器就是 LUT/进位链算 q+1、FF 在沿上存回 q。 LUT 还有三大副业:配合专用进位链做加法/比较、用 SLICEM 存储体拼分布式 RAM(小存储)、把存储位串成 SRL(一个 LUT 顶 32 级延迟线)。工程主线是时间预算 Tco + 各级(LUT+布线) + Tsu ≤ Tclk:一条路径穿的 LUT 级数越深、扇出越大,最高频率越低,用插流水线、retiming、复制高扇出驱动来砍关键路径,并以实现后时序报告的 WNS 与 Logic Levels 精确定位——面积看分类资源水位,速度看最坏那条路径。
上一篇:09 组合与时序逻辑 | 下一篇:11 FPGA vs CPU/GPU/ASIC/MCU | FPGA 系列目录