功耗模型是什么:EDA 工具凭什么算出一颗芯片耗电多少
更新时间:2026-09-15。本文是「集成电路大类 · 低功耗设计与验证」入门层系统篇第 15 篇。很多人第一次看功耗报告都会有个疑问:EDA 工具又没有真的给芯片通电,它凭什么算出某个模块耗了几毫瓦?答案是它手里有一本「耗电字典」——晶圆厂给的 Liberty 工艺库(
.lib)。理解这本字典怎么编、工具怎么查,才能看懂功耗报告里 internal/switching/leakage 三列的数字究竟可不可信。公式底牌见第 01 篇,漏电项的物理来源见第 14 篇,系统地图见低功耗导读。
本文要回答的问题
- 工具不通电,功耗数字是算出来的还是拍出来的?
.lib(Liberty)到底装了什么,为什么换个电压温度要换整套库?- 报告里 internal / switching / leakage 三列,各自的数据从哪张表来?
- 为什么开关功耗库里查不到、要工具结合翻转率现算?
- NLDM、CCS、特征化(characterization)这些词在说什么?
一、工具的「耗电字典」:Liberty 工艺库
功耗分析的本质是查表 + 算术,不是物理仿真每个电子。晶圆厂(或库供应商)在流片前,先用 SPICE 对每一个标准单元(AND2、DFF、ICG……)在大量输入条件下做晶体管级仿真,把结果提炼成一张人类可读的文本表,这就是 Liberty(.lib)库;工具用的是其编译二进制版 .db。
一条典型的单元功耗表大致长这样(简化示意):
cell (AND2_X1) {
  capacitance : 0.7 ;                 # 输入引脚等效电容 fF
  leakage_power () { value : 7.2 ; }  # 单元漏电 nW(状态相关时分子状态列)
  pin (Y) {
    internal_power () {
      related_pin : "A" ;
      rise_power (transition7, load7) {
        index_1 ("0.02,0.1,...,1.5");  # 输入转换时间 ns
        index_2 ("1,5,...,100");       # 输出负载电容 fF
        values ("0.18,0.21, ...",     # 内部功耗 μW 二维查表
                " ... ");
      }
    }
  }
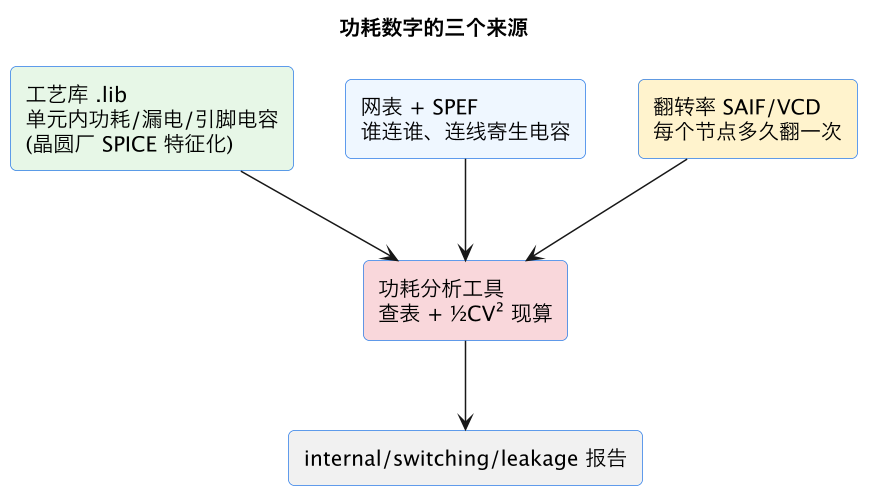
}关键点:库只描述「这一个单元」在不同条件下的耗电,不含任何关于你这颗芯片的信息。 你的芯片信息在网表(谁连谁)、SPEF(连线寄生电容)和翻转率(信号多久翻一次)里。工具把两边拼起来,才得到整芯片功耗。
二、三列功耗,三种数据来源
第 10 篇教你怎么读三列,本篇补上它们的「数据血统」:
| 报告列 | 物理内容 | 数字怎么来 | 库里有没有现成数 |
|---|---|---|---|
| internal(内部功耗) | 单元内部电容充放电 + 瞬间贯通的短路功耗 | 查二维表:按输入转换时间、输出负载查 internal_power | 有,查表 |
| switching(开关功耗) | 单元外部负载(引脚 + 连线)电容的充放电 | 工具用 ½·C_load·V² 乘翻转率现算,再求和 | 没有,库只给电容 |
| leakage(漏电功耗) | 通电但不翻转时的亚阈值/栅漏电等 | 查 cell_leakage,按单元当前状态加权 | 有,查表(状态相关) |
这张表解释了一个常见困惑:为什么同样的网表换一版激励(波形),internal 和 switching 变了、leakage 基本不动? 因为前两者含翻转率因子,信号动得越多越大;漏电只取决于「通着电、处在什么静态状态」,与翻不翻转无关(物理机理见动态 vs 静态)。
internal power 查的是哪两维
单元翻转一次的内部能耗不是常数:输入边沿越慢(transition 大),PMOS/NMOS 同时导通的短路区间越长;输出带的负载越重,内部级要驱动的东西越多。所以库里用输入转换时间 × 输出负载电容两张索引做二维查表,和时序库的 delay 表结构一模一样(同一套特征化顺便产出)。
三、可核验算例:一个 AND2 的三笔账
设工艺 0.7V、AND2_X1 输出负载 C_load = 20 fF,该节点时钟 100MHz、每周期平均翻转 0.1 次(toggle rate = 10MHz 等价 0.1 次/周期),库给 internal 表在当前 transition/load 下查到单次翻转内部能耗 E_int = 0.20 fJ(μW 列在 100MHz 参考下换算),漏电 I_leak = 10 pA。
- 开关功耗(外部负载):每次翻转对负载电容充放电能耗
½·C·V²½ × 20e-15 × 0.7² = 4.9e-15 J = 4.9 fJ; 每秒翻转0.1 × 100e6 = 1e7次:P_sw = 4.9e-15 × 1e7 ≈ 49 nW。 - 内部功耗:
P_int = E_int × 翻转次数/秒 = 0.20e-15 × 1e7 = 2 nW(此例负载小,内部项偏小;大驱动单元内部项常与开关项同量级)。 - 漏电功耗:
P_leak = V × I_leak = 0.7 × 10e-12 = 7 pW。
单看一个门是纳瓦,但乘以「门数 × 百万」并换成更大的单元和更重负载,就是毫瓦、瓦级。注意三个量的脾气完全不同:P_sw 与翻转率成正比、与 V² 成正比(这就是降频降压的依据);P_int 也随翻转率走;P_leak 与翻转率无关、通电就在,且随 PVT 角剧烈变化。
四、PVT:为什么「一个数字」必须配一整套角
.lib 里的所有数都是在某个特定 PVT(Process/Voltage/Temperature) 条件下特征化出来的:
- Process(工艺角):快角 FF(晶体管快、漏电大)、慢角 SS(慢、漏电小但难收敛时序)、典型 TT;
- Voltage:标称 0.7V 就有 0.7V 的库,低压/超驱各有对应库;
- Temperature:-40/25/85/125°C 各一套。
不同 PVT 下延迟、内部功耗、漏电差别极大(漏电在高温慢角可能数倍于常温,见漏电与工艺)。所以功耗签收和时序一样做 MMMC(多模多角):典型角估「一般耗电」,高温快角估「漏电上限」,低压角确认低压功能模式功耗。报告里一个功耗数若不标 PVT 角,等于没说清。
五、NLDM 与 CCS:库模型的两代精度
早期库用 NLDM(非线性延迟模型):延迟和内部功耗只对输入转换时间、输出负载做二维查表,用得最广、足够快。进入深亚微米后,输入波形不再是干净斜坡、互连电阻影响显著,二维表不够准,于是出现更精细的 CCS(复合电流源模型) / ECSM:用一段随时间变化的驱动电流波形刻画单元,能算更复杂的噪声、多输入同时翻转和互连效应。入门阶段记住一句即可:NLDM 是查表、快且普及;CCS/ECSM 是电流波形、更准更慢,先进节点签收常用。 两者都来自同一道 SPICE 特征化,只是信息粒度不同。
六、没有库 / 早期阶段怎么办
- 架构阶段(无网表无库):用电子表格按「门数 × 每门平均电容 × 估计翻转率 × V²」做数量级估算,或用历史芯片的功耗密度(mW/mm² 或 mW/MHz)类比。用于方案取舍,误差常 ±30%~50%,绝不签收。
- 综合早期、布局未定时:工具用 wire-load model 按扇出粗估连线电容,P&R完成后用真实 SPEF 替换,数字会明显变化。
- 门级签收:门级网表 + 真实 SPEF + 真实 SAIF + 对应 PVT 的 .lib,四者齐备才算签核级。这条「什么阶段配什么精度」的纪律,和功耗分析两条线、DPA 分级结论是一致的。
七、读库读报告的几个坑
- 单位坑:库里电容常见 fF/pF、功耗常见 nW/μW,时间 ns/μs,混用单位能差三个数量级;先看库头部的
voltage_unit、time_unit、capacitive_load_unit。 - 角坑:拿 FF 高温角的漏电当典型功耗写进续航预算,会把待机估穿。
- 占空比坑:库给的内部功耗多按「参考翻转率」或单次能耗列,实际要乘真实翻转率(见第 16 篇)。
- 状态坑:多输入门、传输门、保持态寄存器的漏电与内部功耗随输入状态变化,工具按状态加权,手工估算别只取一个状态。
- 库版本坑:
.lib、网表、SPEF、SAIF 必须来自同一版本设计,错配是 DPA 对账偏差的第一来源(见 DPA 可信度报告)。
八、从 .lib 到签收:一次完整计算的内部步骤
把本篇拼起来,工具读库算一个模块功耗时内部大致按下列步骤走,理解这条流水线有助于定位「数为什么不对」:
- 读设计与库:载入门级网表、对应 PVT 角的
.lib/.db、寄生 SPEF、电源域/UPF 信息; - 建负载电容:每个网络的总电容 = 驱动它的引脚电容之和(查库
capacitance)+ 连线电容(SPEF,早期用 wire-load); - 反标翻转率:把 SAIF/VCD 统计的每节点翻转次数与 0/1 时间反标到网络,没覆盖的节点按默认翻转率和默认信号概率填,并记录覆盖率;
- 逐单元累加:每个门贡献「查 internal 表(按 transition/load)+ ½C_loadV²×翻转率的 switching + 查 leakage(按状态)」三项;
- 沿层次汇总:自底向上把单元数累加成分模块、分时钟域、分单元类别(时序逻辑/组合逻辑/存储/时钟树/电源管理单元)的报告;
- 多角重复:换一个 PVT 角的库与电压,整套流程重跑一遍,得到典型/高温/低压多组结果。
数字异常时按这条流水线反向排查最有效:先查是不是角/库拿错(量级整体偏差),再查翻转率覆盖率(某模块异常低常因 SAIF 没反标上、用了默认值),再查负载电容(某网络 switching 异常高常因 SPEF 缺失、被 wire-load 高估),最后才怀疑单元内部表。这套「库—寄生—活动率」三输入的定位法,和 DPA 对账里把偏差归因到版本/激励/模型的思路完全一致。
九、一个常被忽略的区分:功耗(power)与能量(energy)在库里的单位
读 .lib 时最容易踩的坑,是把「功率」和「每次翻转能量」混为一谈,因为库里两种写法都有:
- 老一些的库常在
internal_power表里直接给功率值(nW/μW),但这个值隐含了一个参考翻转率(库头部或表注里的when/频率约定)。实际使用时工具会按真实翻转率折算,若你手工拿这个数直接乘以「个数」而不乘占空比,会把动态功耗高估。 - 更严谨的特征化以**单次跳变能量(energy per transition,常用 pJ/fJ)**给出:内部功耗 = 单次能量 × 每秒跳变次数。这与开关功耗的
½CV²(本身就是每次翻转能量)口径统一,组合时不会漏掉频率因子。
因此手工估功耗时,最不容易错的写法是统一走「每次事件能量 × 事件发生率」:对每个节点/单元,先求它在一个时钟周期里翻多少次(来自 翻转率),乘单次能量得每周期能耗,再乘频率得功率;漏电则相反,它没有事件、直接是「通电就有的功率」,只乘通电时间。这条纪律能同时避免漏乘频率、重复计频率两类错误,也解释了为什么报告把 dynamic(按事件)和 leakage(按时间)分两栏列——它们的量纲来源本就不同(能量 vs 功率的辨析见能量与功率)。做功耗预算表(后续功耗预算实战示例篇)时,建议每个模块都同时登记「活跃功率×活跃时长 + 睡眠漏电×睡眠时长」两笔,而不是只填一个工作点功率——因为电池关心的是一段时间的总焦耳数,单一峰值或单一平均值都会误导设计。最后提醒:库随版本和工艺代更新,换库后应重跑基线设计做回归对账,同一场景功耗若发生跳变,先确认库的特征化条件(电压、温度、参考翻转率、内部功耗口径)是否改变,再去怀疑设计本身。
这一篇在知识体系里的位置
- 公式与三笔功耗的物理来源 → 第 01 篇《功耗从哪来》、第 02 篇《动态 vs 静态》;
- 报告三列怎么读、热点怎么排 → 第 10 篇《功耗报告怎么读》;
- switching 项缺的那个翻转率输入 → 第 16 篇《翻转率是什么》、VCD 与 SAIF;
- 漏电项的 PVT 暴涨与多阈值 → 第 14 篇《漏电与工艺》;
- 库格式与 SDF/UPF 的配套关系 → UPF/.lib/SDF 配套格式。
总结
一句话总结:EDA 工具并不通电,它算出功耗靠的是「晶圆厂给的 Liberty(.lib/.db)耗电字典 + 你的网表/SPEF + 真实翻转率」三样东西做查表和算术——工艺库通过对每个标准单元做大量 SPICE 特征化,把特定 PVT(工艺角/电压/温度)下的单元内部功耗(含内部电容充放电与短路贯通,按输入转换时间×输出负载二维查表)、状态相关的漏电功耗和引脚电容预先列好,工具据此直接查出报告的 internal 和 leakage 两列,而 switching(外部负载电容)这一列库里并不给现成数字,只给电容,必须由工具用 ½·C_load·V² 乘上从 SAIF/VCD 反标来的真实翻转率逐节点现算,这解释了为什么换激励后 internal/switching 会变而 leakage 基本不动(前两者含翻转率因子、漏电只与通电状态和 PVT 有关);库模型分普及快速的二维查表 NLDM 与用电流波形刻画、先进节点签收更准的 CCS/ECSM,且每个功耗数都绑定一个 PVT 角(高温快角漏电可数倍于常温典型角,签收要做多模多角 MMMC,不标角的功耗数没有意义),架构无库阶段只能按门数/功耗密度做 ±30%~50% 的数量级估算、综合早期用 wire-load 粗估线电容,直到门级网表+真实 SPEF+真实 SAIF+对应角 .lib 四者齐备才是签核级;读库读报告要严防单位(fF/nW/ns)、取错角、漏乘真实占空比、忽略状态相关漏电和库/网表/SPEF/SAIF 版本错配五类坑——本质上,功耗数字的可信度等于「库的精度 × 寄生的真实度 × 翻转率的代表性」,三者任一用假设填充,结论就只能是估算而不能签收。