寄生提取技术文件:ITF 到 TLU+ 的编译与工艺层映射
跑 StarRC 做寄生参数提取时,命令行里真正决定提取结果准不准的,不是那几个 corner 开关,而是背后那份寄生提取技术文件——Synopsys 体系里它先以 ITF(Interconnect Technology Format)的文本形态由 foundry 交付,再经编译变成 StarRC 直接消费的 TLU+ 查找表。SPEF 与 RC 提取 corner讲过提取结果怎么以 SPEF 落地、各 corner 怎么取;本篇往上游走一步,讲这份技术文件本身:ITF 里写了什么、编译到 TLU+ 经历了哪些环节、TLU+ 和新式 nxtgrd 的差别,以及工艺层映射出错时那些隐蔽又高发的事故。
本文要回答的问题
- ITF 文件里到底描述了哪些工艺信息,为什么 foundry 只给文本不给二进制?
- ITF 编译成 TLU+ 的流程长什么样,每个环节在算什么?
- TLU+ 与 nxtgrd 两种寄生模型库有什么本质差异,项目怎么选?
- 技术文件与版图层的映射(layer mapping)出错,会以什么症状暴露?
一、ITF:互连工艺的文本化描述
ITF 是 Synopsys 定义的互连工艺描述格式,核心思想是把「这层金属长什么样、电学上怎么表现」用结构化文本写清楚,让提取工具不用硬编码任何工艺参数。一份典型 ITF 包含几大类内容:
- 导体与介质定义:每层金属(
CONDUCTOR)的标称厚度、电阻率或方块电阻、与相邻介质的分界面高度;每层介质(DIELECTRIC)的介电常数、厚度、相对位置。这些值是电磁场求解的基础输入。 - 工艺偏差档:厚度、线宽、介电常数的 min/typ/max 扰动模型——这就是 cworst/cbest/rcworst/rcbest 等 RC corner 组合 的物理来源,corner 名在 ITF 里以
GLOBAL_TEMPERATURE与扰动表关联。 - 刻蚀与偏差表:线宽随间距变化的 etch bias 表(drawn width 到 silicon width 的修正),密度相关效应(如 CMP 造成的厚度随局部金属密度变化)的建模参数。
- via 与接触孔:各层 via 的电阻、尺寸、连接关系。
为什么 foundry 交付文本而不是编译好的库?一是文本可审:工艺整合工程师和 CAD 工程师能直接 diff 两版 ITF 看工艺改了什么;二是同一套工艺要为不同提取工具/不同精度档编译出不同模型库,源头必须保持中性。代价是:文本里写错一个数字,后面所有硅前签核都在用一个错误的工艺——所以 ITF 版本管理要纳入和 PDK 版本基线 同级的管控。
二、从 ITF 到 TLU+:编译在做什么
TLU+ 不是 ITF 的简单打包,而是一次「预计算」。直接把三维互连结构放进场求解器逐线求 RC,签核规模上算不动;TLU+ 的思路是:离线用场求解器(Raphael)把「线宽、间距、上下邻居介质环境」等参数组合成的海量代表性结构逐个解出单位长度 R、C(含耦合电容),整理成多维查找表,提取时 StarRC 只需查表加插值。
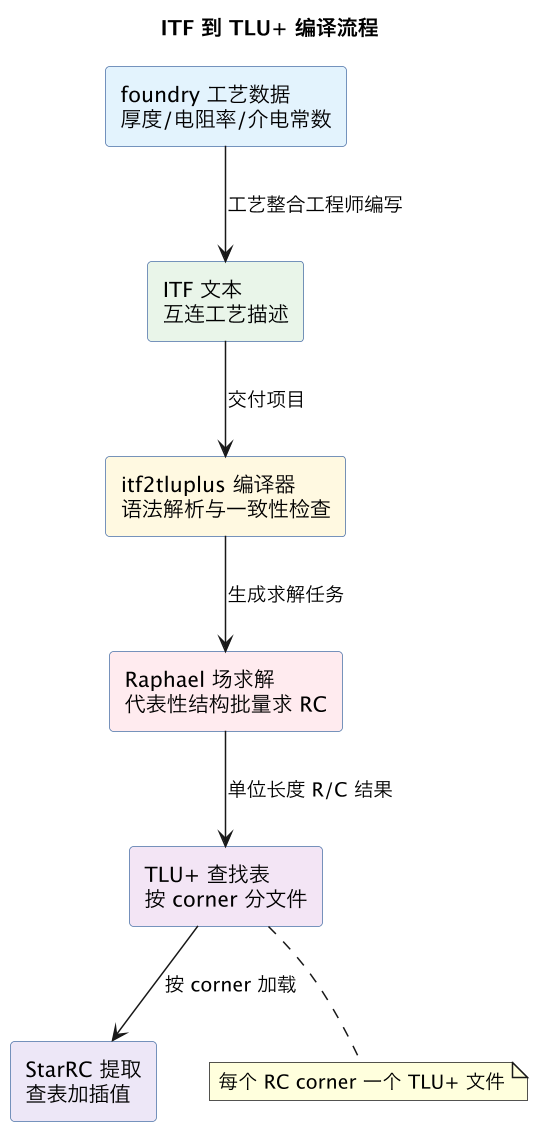
上图要抓住两点。第一,重活在中间:编译一次完整 TLU+ 集(全 corner)在先进节点上动辄几十到上百核时,所以项目里 TLU+ 是由 CAD 团队预编译好入库的,设计工程师只消费不编译;发现 ITF 勘误要重编时,周期以天计,这也是技术文件基线变更要提前排期的原因。第二,corner 在编译期就分叉了:cworst、cbest 等每个 corner 是独立的 TLU+ 文件,StarRC 运行时按 corner 名加载对应文件——corner 名、文件名、ITF 扰动表三者对不上,提取结果就张冠李戴,这类错误的排查方法见 SPEF 与 RC 提取 corner。
编译环节的产出还有一个常被忽略的副产品:一致性报告。itf2tluplus 会检查层定义是否闭合(每个导体上下介质是否拼出完整叠层)、电阻率与厚度是否落在物理合理区间、etch 表是否单调。这份报告要随 TLU+ 一起归档——签核评审时被问「这套寄生模型凭什么可信」,答案一半在 foundry 的 ITF 交付记录,另一半就在这份编译报告里。
三、TLU+ 与 nxtgrd:查表与更细粒度模型
先进节点上 TLU+ 的短板逐渐明显:线宽/间距之外的二级效应(轮廓形貌、多 patterning 的颜色依赖、更密的密度梯度建模)让「查表插值」的误差逼近签核预算。Synopsys 的答案是 nxtgrd 格式,两者对比:
| 维度 | TLU+ | nxtgrd |
|---|---|---|
| 模型形态 | 预计算多维查找表,运行时插值 | 更细粒度的参数化模型,保留更多工艺结构信息 |
| 文件载体 | 每 corner 一个 TLU+ 文件 | 每 corner 一个 nxtgrd 文件,仍由 ITF 编译产出 |
| 精度 | 成熟节点足够,先进节点边缘场景插值误差偏大 | 对先进节点形貌/二级效应建模更准 |
| 编译开销 | 相对低 | 更高,求解结构更多 |
| 适用 | 28nm 及以上成熟节点常见 | 16nm 以下先进节点主流 |
| 消费工具 | StarRC 与 ICC2 布线引擎共用 | 同左,接口替换 |
项目选择的依据很朴素:foundry 对该节点认证了哪种格式就用哪种。签核流程对寄生模型库的版本是强绑定的——S5 签核收敛的时序结论只在「这套 nxtgrd/TLU+ 加这个 StarRC 版本」的组合下成立,库升版等于签核结论部分作废,需要按 X3 ECO 变更传播的纪律评估重跑范围。
四、工艺层映射:技术文件与版图之间的桥
ITF/TLU+ 用的是工艺层名(如 M1、VIA2),版图 GDS 用的是 layer/datatype 数字对,两者之间靠 layer mapping 文件(StarRC 的 MAPPING_FILE,常与 LVS 抽取共用一份源)桥接。这层桥是寄生提取翻车的高发区,典型症状有三类:
- 某层静默丢失:mapping 漏了一条 GDS 层(比如某 RDL 层或 MIM 电容极板层),提取照常跑完,SPEF 也照常产出,但该层连线的寄生全部为零——时序乐观偏差,silicon 回来才对不上频率。判据是 StarRC 报告里各层的 net 数和总电容分布,某层计数异常低就要查 mapping。
- 层叠错位:mapping 把 GDS 层号对错到相邻金属层(M5 图形被当 M4 提),电阻率、介质环境全错,RC 偏差几个百分点,不会报错只会在 sign-off corner 对账时发现裕量异常。
- 多工具 mapping 不一致:LVS 用一套 mapping、StarRC 用另一套,LVS 过了但提取看到的层连接关系不同,表现为 LVS 器件识别干净而 SPEF 里出现莫名其妙的开路耦合网。
防控手段是把 mapping 文件视为技术文件族的一员:与 ITF/TLU+ 同基线、同版本库、同评审。任何 PDK 升版,mapping 与 TLU+ 必须同步对账——这和 X1 交接契约里「版本对一起交付」的要求是同一条纪律在寄生提取域的投影。另外,每次提取后抽查一条已知长度金属线的 SPEF 电阻与 ITF 标称方块电阻手算值对账,是最便宜的「mapping 体检」。
这一篇在知识体系里的位置
- 下游消费:SPEF 与 RC 提取 corner 讲提取结果与 corner 落地,RC corner 选择 讲各 corner 的物理含义——本篇讲的 ITF 扰动表正是那些 corner 的源头;
- 同族格式:寄生结果的交付格式见 SPEF/SDF 数据格式;
- 治理上下文:版本基线见 PDK 版本基线、X1 交接契约 与 S5 签核收敛;层连接的正确性验证见 LVS 器件识别。
总结
寄生提取技术文件是 StarRC 签核精度的根:foundry 以 ITF 文本交付互连工艺的导体/介质/偏差描述,经编译器解析与 Raphael 场求解预算出分 corner 的 TLU+ 查找表(先进节点升级为 nxtgrd),StarRC 提取时查表插值得到 RC;工程上要守住两条线——corner 名、ITF 扰动表、TLU+ 文件三者一致,以及 layer mapping 与版图层严格对齐——前者防张冠李戴,后者防静默丢层,两者都靠把技术文件族纳入与 PDK 同级的版本基线管控。