AHB Locked 锁定传输:HMASTLOCK 下的读改写原子性
更新时间:2026-09-25。本文是「集成电路大类 · 芯片设计 · 片上总线」序列里的一篇长尾篇。在 AMBA 总线入门 里我们知道 AHB 是多 master 共享总线,master 之间靠仲裁器轮换上总线;那么问题来了——如果某个 master 的操作必须「一口气做完、中间不许插队」怎么办?AHB 给出的答案就是 AHB Locked 锁定传输。它在实际系统里最常出现在 硬件信号量与自旋锁 的获取流程中。
本文要回答的问题
- HMASTLOCK 置起后,总线上的连续传输获得了什么保证?
- 仲裁器和 slave 分别看到 HMASTLOCK 后该怎么做?
- 同样是原子操作,AHB 锁定传输与 AXI 独占访问在粒度和实现成本上差在哪?
一、HMASTLOCK:把一串传输标成「不可分割」
AHB 的锁定传输由 master 的一根输出信号 HMASTLOCK 表达。它不是命令类型,不占 HTRANS 的编码,而是一个贯穿多个传输周期的标志位:master 从锁定序列的第一个地址相开始拉高 HMASTLOCK,直到序列最后一个数据相结束才拉低。
语义只有一句话:HMASTLOCK 为高期间,这组地址递增(或由 master 决定)的连续传输在总线上是原子的,仲裁器不得把总线授予任何其他 master。 注意这里的原子性边界是「总线」而非「内存系统」——AHB 协议保证的是不被总线仲裁打断,至于 slave 内部的访问顺序,由 slave 自己负责。
规约建议锁定序列保持短小,通常两到四个传输,覆盖一次读加一次写足矣。锁定时间过长会阻塞同等高优先级的 master,实时性差的系统里这是明显的中断延迟来源。
二、锁定传输时序:一次读改写
下图是最典型的锁定序列:master 对同一个信号量地址做读改写(Read-Modify-Write, RMW),先读回旧值,判断并修改后写回,三步在 HMASTLOCK 保护下完成。
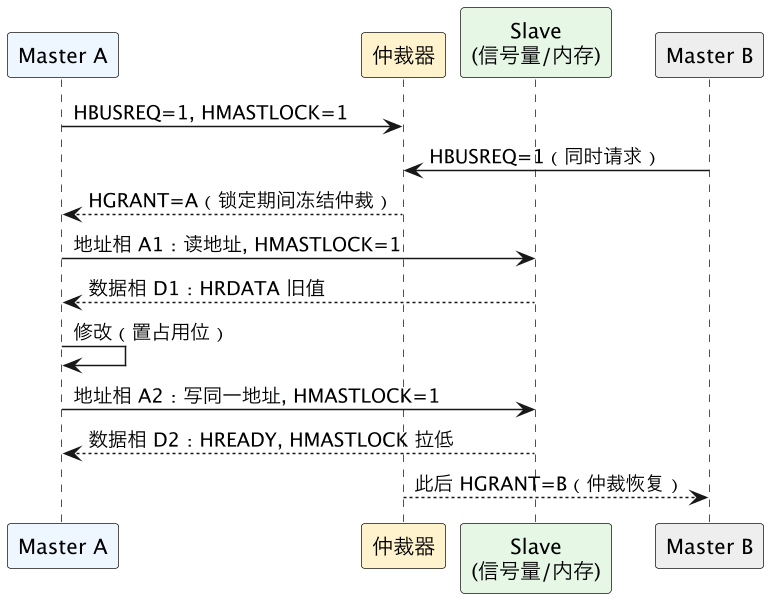
顺着图读:Master A 在发总线请求时就表明 HMASTLOCK=1;仲裁器一旦把总线授予 A,整个锁定窗口内仲裁结果被「冻结」,哪怕 Master B 同时请求也只能等待。AHB 的地址相与数据相流水线重叠,所以 A2 的地址相在 D1 的数据相周期就发出了,整个 RMW 实际只占三个总线周期左右。序列末尾 HMASTLOCK 拉低,仲裁器立刻恢复正常轮换,下一个周期即可授权给 B。波形上判断锁定窗口很简单:HMASTLOCK 高电平覆盖的 HCLK 区间,HGRANT 一定稳定指向同一个 master。
三、仲裁器与 slave 各自看到什么
锁定语义需要总线两端配合,分工是明确的。

仲裁器是锁定语义的真正承担者:它必须在 HMASTLOCK 为高时抑制一切授权切换,包括高优先级请求的抢占,也不允许在锁定序列中间插入 split/retry 导致的主人轮换。slave 一侧则轻量得多——AHB 规约并不强制 slave 对锁定传输做特殊响应,HREADY、HRESP 照常给出;但 slave 可以观察 HMASTLOCK,例如多端口外设用它来保证内部管理寄存器的读改写不被另一个端口夹断。换句话说,不切换主人是仲裁器的硬义务,利用锁定信息保护资源是 slave 的可选项。 写 AHB 仲裁器 时最常见的 bug 就是只在普通授权逻辑上加了 HMASTLOCK 判断,却漏了 locked 序列遇到 HTRANS=BUSY 时窗口要顺延,导致提前释放总线。
另一个容易混淆的点是命名:AHB 规范里 master 内部的请求信号叫 HLOCK(locked sequence request),它经寄存器打一拍、与地址对齐后出现在总线上才叫 HMASTLOCK。在 RTL 里顺着 HMASTLOCK 找不到源头,多半是因为 master 侧用的是 HLOCK 这个名字,二者是同一意图在不同流水级的称呼。验证时建议区分两条性质分别用 SVA 覆盖:HMASTLOCK 高电平窗口内 HGRANT 必须稳定指向同一 master;锁定序列不得跨越两次独立的总线请求,master 必须在锁定开始前已拿到授权,不能在序列中途重新请求。
四、典型用途:RMW、信号量与位带操作
锁定传输天然服务于「读—判—写」必须合拢的场景。多核或多 master SoC 中,CPU 获取信号量的经典流程是:锁定读信号量字,若为空闲则写入「已占用」再解锁;两个 CPU 同时尝试时,输掉仲裁的那个看到的是对方写回之后的值,不会出现两个 master 都以为自己拿到锁的情况。操作系统里的 test-and-set、内核位图的置位清位,落到 AHB 上多是这一类短锁定序列。AHB/APB 桥 一侧的外设一般不需要锁定,但桥在转发时必须保证锁定序列不被自身插入的 APB 访问打断。所谓位带(bit-banding)操作——对一个字里的某一位做原子置位或清位,本质也是一次 RMW,在没有专门位带硬件的简单系统里同样走锁定传输完成。
还要提醒一个实测中容易忽略的长度纪律:锁定序列不是越长越安全。总线被锁期间其他 master 的请求只能挂起,稍长的 RMW(比如先读整组寄存器、逐位计算再写回)会把中断响应、DMA 刷新这类实时流量全部挡在外面,表现为中断延迟出现周期性尖峰。工程上的做法是把临界区压到最短:锁内只做一次读和一次写,复杂计算全部挪到锁定窗口之外完成。如果某个外设的锁定序列设计上就超过四拍,应当在架构评审时单独说明对其他 master 实时性的影响,而不是默默占住总线。
五、与 AXI 独占访问对比
AXI 不提供总线级锁定(AXI4 已移除 locked 传输),改用独占访问(Exclusive Access)两段式完成同类事情:master 先发独占读,slave(或互联)记录 ARID 与地址;master 计算后发独占写,slave 检查这段时间内该地址有没有被别人写过,没被写过返回 EXOKAY 并真正写入,被写过返回 SLVERR、写入失败,master 重试整个流程。
| 对比维度 | AHB Locked(HMASTLOCK) | AXI Exclusive(EXOKAY) |
|---|---|---|
| 机制形态 | 一段式:总线仲裁冻结,连续做完 | 两段式:独占读 + 独占写,中间总线可让给别人 |
| 原子性保证者 | 仲裁器(不切换主人) | slave/互联内的独占监控器(地址比较) |
| 系统粒度 | 总线级,锁定期间整条总线被占 | 单地址级,不阻塞其他 master 的无关传输 |
| slave 实现成本 | 极低,可不感知;成本在仲裁器 | 需要独占监控表(ID+地址记录、超时清理) |
| 失败与重试 | 不会失败,等待者付出延迟代价 | 可能返回 SLVERR,master 软件重试 |
| 适用场景 | 单总线、少量 master、短 RMW | 高并发多 master、乱序互联、多核信号量 |
选型逻辑很清楚:AHB Locked 用「占用整条总线」换实现简单,适合 master 少、总线本来就串行的中小规模设计;AXI 独占访问用「slave 记住监控、失败重试」换并发度,不阻塞无关流量,是多核高带宽系统的唯一可行方案。互联层面的差异可结合 AXI crossbar 设计 和 AHB-Lite 多层总线矩阵 理解。
这一篇在知识体系里的位置
AHB 信号与流水线基础见 AMBA 总线入门;锁定操作保护的软件原语见 硬件信号量与自旋锁;另一端协议的原子机制在 AXI4 基础;验证这类时序时,建议用 SVA 性质检查锁定窗口内 HGRANT 的稳定性,方法见 SVA bind 与覆盖收集。
总结
AHB Locked 锁定传输靠 HMASTLOCK 把一段连续传输标记为总线级原子操作:仲裁器在整个锁定窗口内冻结 HGRANT、不切换总线主人,slave 正常响应并可选地利用该信号保护内部资源,典型用途是信号量获取中的读改写;与 AXI 独占读加独占写、由 slave 监控地址冲突并以 EXOKAY/SLVERR 两段式判决相比,AHB 方案以短时间独占整条总线为代价换取极低的实现成本,适合 master 少的单总线设计,AXI 方案不阻塞无关传输、支持高并发但要求 slave 内置独占监控,二者是「占总线」与「记地址」两种原子性哲学的分野。