FPGA 时钟区域与 BUFG:clock region 版图、四类时钟缓冲与全局时钟树
时钟是 FPGA 里扇出最大的信号:一个系统时钟往往同时挂着几万甚至十几万个触发器。晶振频率怎么倍出来由 PLL/MMCM 时钟向导负责,复位怎么配合时钟释放见 FPGA 时钟与复位,多时钟域怎么写约束见进阶篇时钟网络与时钟组约束。本篇补上讲得最少的一块物理常识:FPGA 时钟区域与 BUFG——芯片内部的时钟分发网络长什么样、资源为什么稀缺、时钟从 MMCM 到每个触发器走了一条什么路。
本文要回答的问题
- 如果时钟不走专用网络、直接用普通布线驱动几万个触发器,会发生什么?
- clock region(时钟区域)是什么?整颗芯片的时钟资源在版图上怎么分布?
- BUFG、BUFR、BUFIO、BUFH 各驱动多大范围,数量上限是什么量级?
- 一路时钟从 CC 引脚或 MMCM 出发,经过哪些物理段才到达 leaf 触发器?时序报告里的 insertion delay 和 clock skew 从哪来?
- 跨区域用时钟有哪些典型坑:局部时钟误布线、clock backbone 拥塞、BUFG 不够用,分别怎么识别和处理?
一、先想清楚:不要专用时钟网络会怎样
假设 FPGA 内部没有任何专用时钟资源,时钟和复位、使能一样走普通 fabric 连线。综合布线工具拿到一个挂了三万个触发器的网线,只能在通用布线矩阵里一根根绕:离源点近的触发器走三跳线,远处的走几十跳线,还要和数据线争抢同一批布线开关。
这样的网络有三个致命问题。第一,到达时间参差不齐。同一个上升沿,近处触发器和远处触发器收到的时刻可能差出几百 ps 到数 ns。先收到沿的触发器先采数据,新值被推进组合逻辑,后收到沿的触发器正好采到变化中的数据,保持时间违例直接发生,而且这种故障随布线结果波动、随温度电压漂移,板上表现为难以复现的偶发错误。第二,占空比和边沿质量失真:普通连线没有为沿速率做平衡设计,高频时钟经过长绕线后上升沿变缓、高低电平时间不再对称。第三,时序无法分析:时钟网络不在专用资源上,静态时序分析不把它识别为平衡树,skew 无法预期,约束写得再全也算不准。
左图是普通布线驱动时钟的示意:同一沿的到达时间随路径长度发散,skew 不可控;右图是专用时钟树的形态,树根统一缓冲后按平衡结构分发,每个触发器拿到的时钟几乎等延迟。专用网络换来了三样东西:低偏斜、可预测、高扇出低功耗——整棵树只在平衡节点上做必要的缓冲,而不是让一根线硬拖三万负载。代价则是:这套网络是芯片里划出来的定額资源,位置固定、数量有限。
二、clock region:芯片被切成固定高度的横向条带
要理解时钟资源为什么是"按份"配给的,先看芯片的时钟版图。Xilinx 7 系列及之后的器件,整片 FPGA 在垂直方向被划分成若干个 clock region(时钟区域):每个区域是一个固定高度的横向条带,横跨芯片整个宽度,内部包含固定行数的可配置逻辑块、Block RAM、DSP,以及属于本区域的一套区域时钟资源和 IO 时钟资源。条带之间上下堆叠,铺满整颗芯片。
时钟管理单元不在逻辑阵列里随机分布:CMT(Clock Management Tile,内含 MMCM/PLL)坐落在芯片两侧或中部的专用时钟列上,每隔几个条带放一个;专用时钟输入引脚(CC 引脚)成对分布在 IO bank 内,进来后有专用通道直达 CMT 和全局缓冲。全局时钟的主干是一条(各家架构里具体形态不同的)垂直时钟骨干 clock backbone / spine,全局缓冲挂在骨干上,时钟沿骨干纵向送到每个条带,条带内部再由水平时钟行分发给本区域的逻辑。
读这张版图抓住三点:其一,时钟资源是条带化的——区域缓冲、IO 缓冲按 region/bank 配给,不是全域池化的,这决定了"局部时钟不能随便跨条带";其二,全局骨干是共享通道,所有全局时钟都挤进这条纵向资源,这是后文拥塞问题的物理出处;其三,CMT 与 CC 引脚位置固定,一个高频时钟从哪对引脚进、喂哪个 CMT、上哪条骨干,布局布线阶段是有位置约束的,不是纯软件行为。7 系列与 UltraScale 在条带细节和网络形态上有差异(UltraScale 的全局与区域网格更统一、时钟注入点更灵活),但"横向分区、专用列、共享骨干"这套定性结构不变;具体到某颗器件有多少个条带、多少个 CMT,查该器件数据手册的时钟资源表。
三、BUFG/BUFR/BUFIO/BUFH:按作用域分工的四类缓冲
时钟缓冲的本质是"时钟树的驱动点"。FPGA 提供作用域不同的几类专用缓冲,让设计者按扇出范围选,避免一个局部时钟也占用全域资源:
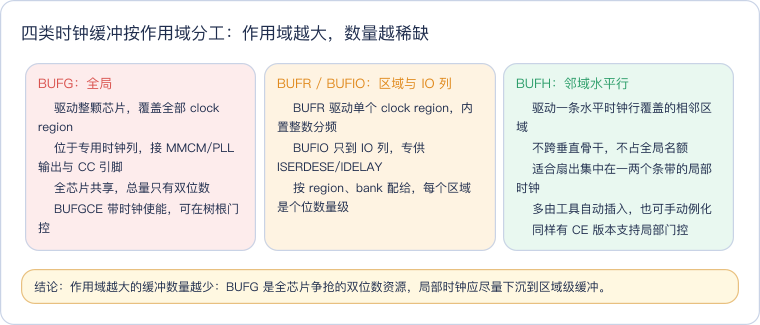
这张对照卡的主线是作用域与稀缺性成反比。再用一张表把工程选型时关心的维度补齐:
| 缓冲 | 驱动范围 | 能否分频 | 典型负载 | 数量量级(具体查数据手册) |
|---|---|---|---|---|
| BUFG / BUFGCE | 全芯片所有条带 | 否 | 系统主时钟、MMCM/PLL 输出、高扇出复位同步时钟 | 双位数,全芯片共享 |
| BUFH / BUFHCE | 一条水平时钟行覆盖的邻域 | 否 | 扇出集中的局部时钟、跨少量相邻区域 | 按行配给 |
| BUFR | 单个 clock region | 支持整数分频 | 源同步采集的区域时钟、ISERDESE 串并转换 | 每区域个位数 |
| BUFIO | IO 列(只能到 IO 逻辑,进不了内部 CLB) | 否 | SerDes 采样时钟、IDELAY 参考时钟 | 每 bank/区域个位数 |
| MMCM/PLL | 不直接驱动逻辑,是时钟源头 | 倍频/分频/移相 | 频率与相位合成、抖动滤波 | CMT 数量,随器件规模为个位数到十几个 |
两个容易混淆的点。第一,MMCM/PLL 与缓冲是前后两级,不是同类资源:MMCM 负责"造时钟"(频率、相位、占空比),输出必须经 BUFG(或区域级缓冲)才上分发网络,分工边界在 PLL/MMCM 时钟向导里有实例。第二,BUFGCE 的时钟使能不是"逻辑造时钟":CE 在树根做硬件门控,关断期间时钟网络停止翻转以省动态功耗,恢复时沿依然完整;而用计数器输出去翻一个门控信号当时钟,走的是普通布线,属于计数器与时钟使能里明确反对的写法——需要"慢动作"应该用时钟使能,而不是造新时钟。
四、一条时钟的完整路径:从 MMCM 到 leaf 触发器
把版图和缓冲串起来,跟踪一路最常见的时钟:板上晶振 → CC 引脚 → MMCM → BUFG → 触发器时钟引脚。
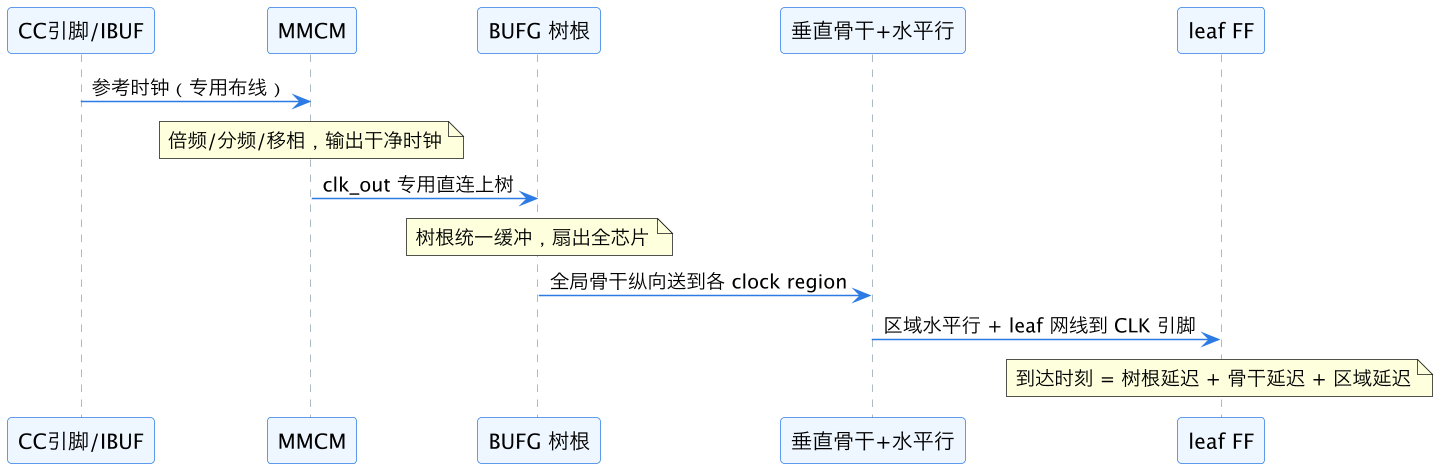
每一段物理走线都会贡献延迟,串起来就是时序报告里的两个关键量:
- clock insertion delay(时钟插入延迟):从时钟定义点(树根或时钟源)到某个触发器 CLK 引脚的总传播延迟。它是必然存在的——再好的平衡树也有物理延迟,量级由器件速度等级和网络段数决定。时序分析不靠"消除"它工作,而是假设同源触发器共享大部分路径(common path),把公共段抵消掉。
- clock skew(时钟偏斜):两个触发器 insertion delay 之差。平衡树让这条差值维持在很小的范围内,时序报告里对每个时钟域给出 skew 统计。MMCM 还能做所谓的 deskew:把片上时钟反馈回相位检测环路,进一步抵消树根到 MMCM 附近的公共延迟。
对照时序报告时,可以按下面的对应关系把数字和物理段挂钩:
| 报告里的字段 | 物理对应 |
|---|---|
| Source Clock Path 上半段(IBUF/MMCM 之后) | 专用通道 + MMCM 输出到 BUFG |
| Network Latency / insertion delay | BUFG 树根 + 垂直骨干 + 水平行 + leaf 网线 |
| Clock Skew(捕获沿减发射沿) | 两个触发器在树上的路径差,平衡度的直接读数 |
| Logic/Route Delay | 数据路径,与时钟路径对照判断建立/保持裕量 |
这也解释了为什么非专用时钟脚进来的时钟会被工具反复警告:它无法进入上图 MMCM 到 BUFG 的专用直连通道,只能先走通用布线绕到树根,这段绕行延迟大、随布局变化、不被 common path 抵消,相当于在时钟源点就注入了一笔不可预期的 skew。读报告的具体操作见时序报告入门与进阶的静态时序分析。
五、稀缺性的工程含义:BUFG 为什么要省着用
全局缓冲只有双位数,听起来不少,但一个复杂工程里排队上树的时钟很多:系统主时钟、MMCM 输出的几路频率时钟、收发器恢复时钟、外部随路时钟、高速接口时钟……每个都要占一个 BUFG,中小型器件很快会见顶。区域级资源同样不宽裕:每个 clock region 的 BUFR/BUFIO 是个位数配给,一个 bank 上挂几路源同步接口就要开始算账。
资源稀缺推出三条设计纪律。其一,时钟数量从架构阶段就做预算:同频同相的时钟合并成一个,跨模块传递的是同一根时钟而不是各自再缓冲一份。其二,能用时钟使能就不造新时钟:慢节拍逻辑挂在主时钟上用 CE 门控,零 BUFG 开销。其三,按作用域下沉:只在某个 IO 列服务 ISERDESE 的时钟走 BUFIO/BUFR(源同步接口的典型用法见 LVDS 源同步采集),扇出集中在相邻条带的走 BUFH,真正全域扇出的才配占 BUFG。
代际差异只定性说明:UltraScale 把全局与区域时钟网格做得更统一、允许更多注入点,缓解了部分布局约束,但"专用时钟资源按份配给、用满即止"的本质没有变。无论哪个系列,综合实现后都应打开 Clock Utilization 报告,逐一核对每个时钟走的是哪类缓冲、占用多少、余量多少——把时钟资源当成和 BRAM、DSP 一样要盘点的定额,具体数字一律以目标器件数据手册为准。
六、跨区域时钟的三个常见坑
第一个坑最经典:时钟从普通 IO 脚或内部逻辑进来,没打 BUFG。现象是工具出现 "Found ... combinatorial loop / clock accessed via non-clock routing" 之类警告,时钟走了普通布线,实现后时序报告里该时钟 skew 异常大、保持时间违例随机出现。处理:外部时钟必须约束到 CC 专用引脚;内部信号实在需要当时钟的极少数场合,例化 BUFG 显式上树并补生成时钟约束(这种下策的约束写法见时钟网络与时钟组约束)。
第二个坑是局部时钟用出圈。BUFR 只覆盖本 clock region,如果把它驱动的逻辑在约束或 floorplanning 里放到了别的条带,布线器要么报错,要么被迫把网络升级到全局路由——区域缓冲的节省全部作废,还可能挤占 BUFG 名额。BUFIO 更严格,物理上只能到 IO 列,拿它去驱动内部 CLB 触发器直接不可实现。
第三个坑是 clock backbone 拥塞。太多全局时钟同时流经骨干同一区段,或高扇出时钟集中在某几个条带,会出现时钟骨干利用率打满、实现时间暴涨、时钟路径绕行导致 skew 变大的现象。排查方向是减少全局时钟数量(合并、下沉区域级)、检查 CMT 与时钟引脚的配对位置、必要时用 Pblock 把重负载模块摊到不同条带。下面这张选型决策图概括了判断顺序:
图中蓝色是排查动作,绿色是全局路由的正常归宿,橙色是区域级缓冲的正确用法,红色是必须避免的普通布线时钟。跨时钟域本身(异步时钟之间的数据安全)是另一个话题,由同步器和异步 FIFO 解决,见 CDC 亚稳态;同步设计原则则给出了单时钟域内部的基本纪律。
七、在 Vivado 报告里核对时钟资源
工程做完,至少看三处。一是综合后的 Clock Utilization:每个时钟用了哪个缓冲、各区域 BUFG/BUFH/BUFR/BUFIO 占用与余量、时钟源头是 CC 引脚还是普通布线。二是实现后的时序报告:观察每个时钟的 insertion delay 是否落在器件的正常量级、clock skew 是否很小且平衡;skew 异常大的时钟先回去查它走的网络类型。三是 Device 视图:打开时钟网络高亮,肉眼确认时钟确实沿骨干和水平行分发、负载分布在预期条带,而不是一片绕线。报告字段的逐项读法见时序报告入门,违例收敛手法见静态时序分析。
这一篇在知识体系里的位置
本篇讲时钟分发的物理资源:clock region 版图、四类缓冲的作用域与定额、时钟树的物理路径与时序代价。它的上游是时钟与复位的入门纪律(时钟走专用脚、上树、等 locked)和 PLL/MMCM 时钟向导的频率合成——MMCM 造时钟,本篇讲造出来以后怎么送;下游是进阶的时钟网络与时钟组约束(多时钟规划、set_clock_groups)、静态时序分析(skew/insertion delay 怎么进入裕量计算)和 LVDS 源同步采集(BUFR/BUFIO 的主战场)。相关的设计纪律另见计数器与时钟使能与同步设计原则。
总结
FPGA 时钟区域与 BUFG 的核心认知是:时钟是全芯片扇出最大的信号,普通布线驱动它会让 skew 失控、保持时间违例偶发且不可分析,因此 FPGA 预置了一套固定位置、按份配给的专用时钟网络。芯片被切成固定高度的横向 clock region 条带,CMT 位于专用时钟列,全局时钟沿共享的 clock backbone 纵向送达各条带再水平分发;BUFG 驱动全芯片但全芯片只有双位数份额,BUFH 服务邻域水平行,BUFR 服务单个区域且可分频,BUFIO 只到 IO 列,作用域越小数量越宽松。一路时钟从 CC 引脚经 MMCM、BUFG、骨干、区域行到 leaf 触发器,每段走线构成 insertion delay,触发器之间的路径差就是 clock skew——平衡树让 skew 足够小,时序分析才成立。工程上三条纪律:外部时钟必须进 CC 脚、内部信号当时钟必须显式上 BUFG;时钟数量早做预算,同频同相合并、用时钟使能代替造时钟;局部时钟下沉到 BUFR/BUFIO/BUFH,不与全域时钟争抢 BUFG。具体器件的区域数、缓冲数与 CMT 数一律查数据手册,报告里用 Clock Utilization 和时钟网络高亮核对实际走线。