低功耗 RTL 入门:怎么写代码才能让综合器推断时钟门控、让数据不乱翻
更新时间:2026-09-15。本文是「集成电路大类 · 低功耗设计与验证」入门层系统篇第 34 篇。很多人以为低功耗是后端和电源架构师的事,其实架构定完预算后,芯片里最多、最琐碎的省电发生在 RTL 工程师的每一个 always 块里。时钟门控讲原理,翻转率讲 α 怎么进入功耗公式,这一篇讲落到 Verilog/SystemVerilog 代码上的具体写法:怎么让综合器高高兴兴地替你插门控,怎么让无效数据在半路就停下。系统地图见低功耗导读。
本文要回答的问题
- 同样功能的两段 RTL,为什么一个被综合出时钟门控、一个全是保持多路器?
- 使能信号到底该怎么写,时钟门控才不会自己长出毛刺?
- 模块空闲时,怎么从代码层面「冻结」数据通路?
- 状态机编码、总线编码和功耗有什么关系?
- 写完代码后,用什么报告确认省电真的发生了?
一、RTL 能控制什么:盯住 α 和「被唤醒的规模」
动态功耗 P=α·½CV²f 里,电压和频率是系统/架构旋钮,前端工程师手里最直接的是 α(翻转率):同样的逻辑,输入端每个周期都在乱翻,还是该翻才翻?再进一步是被唤醒的逻辑规模:一次无效操作是否惊动了乘法器、整条总线、整块 SRAM?
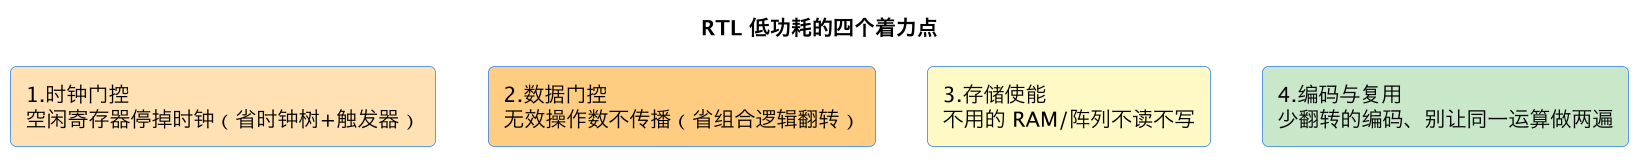
一个贯穿全篇的原则:功耗优化要让「空闲」在波形上可见。功能仿真里看不出差异的两种写法,在活动率波形上可能差几倍——所以每个手法最后都要回到「看使能波形、看翻转报告」确认。
二、时钟门控推断:写出让工具放心的使能风格
2.1 数据保持 ≠ 时钟门控
新人常写的「使能寄存器」:
// 风格 A:数据端多路保持——功能对,但不省时钟的电
always_ff @(posedge clk) begin
  if (rst_n) begin
    if (en) q <= d;
  end
end
综合结果是触发器前挂多路器:en=0 时 q 保持,但时钟仍每周期拍在触发器上,时钟引脚照翻,时钟树功耗一分不省。对几十位寄存器,就是几十个保持 MUX。
推荐的写法是保持「寄存器带统一使能」的规整模式,让综合工具识别成一组并收编到集成时钟门控单元(ICG):一个 ICG 给整组寄存器供门控时钟,en=0 时这一组的时钟全停:
// 风格 B:规整的同步使能,综合器对成组寄存器推断共享 ICG
always_ff @(posedge clk or negedge rst_n) begin
  if (!rst_n)      q <= '0;
  else if (en)     q <= d;   // en 是「本组真的要装载」的干净条件
end要点不是语法魔法(两段都可能被部分工具优化),而是:使能条件要规整、成组、来源一致。一堆各用零散门控条件的寄存器无法共享一个 ICG,工具只能各自插 MUX 或插一堆小 ICG,面积和时钟偏差都变差。实践中把「模块级接收使能」(如总线 valid/ready 的命中、FIFO 非空)作为统一 en 传给数据寄存器组,是最容易被大面积收编的模式。
2.2 使能信号的时序纪律:门控不能造毛刺
直接拿 en 与 clk 做 AND 是危险的:若 en 在时钟高电平期间变化,门控时钟会产生窄脉冲(glitch),触发器被误触发甚至进入亚稳态。标准 ICG 单元内部用一个低电平透明锁存在时钟为低时采样使能,保证门控沿干净。RTL 侧的纪律是:
- 使能用寄存后的信号(registered enable),不要用组合逻辑把一堆乱跳的条件现场拼出来;
- 使能至少满足对时钟的建立时间要求,工具会检查并可能加锁存;
- 避免门控条件本身来自另一个门控时钟域(跨门控域取使能要先在常开时钟上同步)。
复位的处理同样要想清楚:若 ICG 在睡眠时关了时钟,异步复位释放的同步电路必须在常开(或醒来后先跑的)时钟上,否则「睡着的块永远等不到复位释放」。
2.3 门控粒度的权衡
- 粒度过细(每组两三比特一个 ICG):ICG 面积和使能路径开销吃掉收益,时钟树插入困难。
- 粒度过粗(整个大模块一个 en):组内只要一个寄存器要动,全组时钟都得开,停钟机会变少。
- 经验:按功能子块/总线通道分组(一组 8~64 位很常见),使能由「这组本周期真的有事务」驱动。低功耗手段全景把这类自动可推断的门控归为「性价比最高的第一波优化」。
三、数据门控:让无效操作数在半路停下
时钟停了省时序单元,但组合逻辑在「输入还在变」时照样翻转(后续毛刺与无效翻转篇)。典型反例是一个流水线乘法器:上游 valid 已经没了,数据总线却带着旧值甚至噪声一路冲进乘法阵列,每个周期白算。
三种实用写法:
- 操作数有效才放行(operand isolation):在大功耗组合单元的输入端加使能与门/使能锁存,无效周期喂常量:
// valid 时才让操作数进入乘法器,否则喂 0,阵列不翻
logic [31:0] a_g, b_g;
assign a_g = valid ? a : 32'b0;
assign b_g = valid ? b : 32'b0;
assign prod = a_g * b_g; // 无效周期内部几乎不翻转- 状态机默认输出静态值:
default/else分支让总线在空闲态保持 0 或上一有效值,而不是放任未驱动/三态,悬空进入仿真的 X 到硅上就是乱翻。 - 早停传播:握手未命中(valid/ready 失败)时,下游整条流水保持而不是继续推进垃圾数据;地址解码未选中的从设备不翻转内部数据通路。
注意数据门控会增加使能逻辑(与门、多路器)和少量延迟,只对大电容、低活动率的节点划算——给一个与门做 operand isolation 反而更费。判断依据仍是翻转率报告:先看热点,再动手。
四、存储器:最容易被忽视的大头
一片大 SRAM 的位线预充、灵敏放大器在每次访问都全摆幅动作,其功耗往往占 SoC 的可观比例(下一篇存储器功耗直觉专门讲)。RTL 侧三件事:
- 显式使能:实例化存储器(或行为阵列让工具推断)时给出真实的
cs/we/oe,未选中周期确保 cs=0;不要让地址/片选由未寄存的组合信号毛刺驱动。 - 减少无谓读写:读改写先判断值是否真变;写全字而不是反复触发;循环缓冲区按字对齐避免跨行多次访问。
- 配合休眠模式:在系统睡眠时通过控制口把 SRAM 置于 retention/light-sleep(保留内容但停预充),RTL 的电源管理 FSM 要负责这些请求,与 UPF 的保持策略一致。
五、编码与微结构:换个表示法就少翻
- 总线翻转编码(直觉版):连续变化的数据(如 PC、地址)相邻值常常只差一点,用格雷码或「取反传输 + 指示位」可减少翻转根数;对片上长总线、无片外电容时收益有限,了解原理即可,别滥用(编解码本身耗电)。
- 状态机编码:简单 FSM 用二进制/格雷(少寄存器、转换时少翻转),并行多路控制用 one-hot(译码简单但寄存器多);低功耗上没有绝对赢家,工具的默认选择一般不差,自己改要看活动率。
- 操作数交换律:让活动频繁的操作数接电容更小的输入端(某些数据手册/库会建议);乘法器里高位优先停在 0 也有助减少内部翻转。
- 避免重复运算与窄位宽:明显无用的高位宽运算(用不到的精度、循环里不变量重复计算)既烧面积又烧电;
enable早停比算完再丢结果省得多。 - 访存局部性:数据在寄存器堆/SRAM 间的搬运本身很费;算法层面减少冗余读写(块处理、流式)比门级抠几个触发器有效得多,这就是低功耗手段全景说的「架构杠杆远大于门级杠杆」。
六、与 UPF/电源管理握手的 RTL 纪律
电源门控、隔离、保持主要在 UPF 里描述(见保持隔离、电平转换),但 RTL 必须「配合」:
- 可关模块要提供干净的静止点(quiescence):能在保存后停止总线事务、输出可预测,避免 AXI 上挂着未完成握手导致 PMU 不敢关电。
- 隔离值(0/1/保持)要在协议上合法——例如把 valid 隔离为 0,而不是让数据悬空。
- 电源请求/握手用常开域寄存器实现;跨域信号经同步器;唤醒脉冲在 AON 时钟域产生。
- 提供 residency、唤醒原因等观测寄存器(功耗异常排查篇会强调它们的排障价值)。
- 不要在 RTL 里用
initial、隐式 X 假设掩盖电源行为;power-aware 仿真会真的让断电信号变 X。
七、写完之后:用报告确认省电真的发生
代码风格只是手段,验收看数据:
- 综合后看 ICG 数量与覆盖率:多少比例的带使能触发器被 ICG 收编、还剩多少数据保持 MUX;检查工具报告的
ungated/endpoints。 - 看时钟网络功耗占比:在功耗报告(报告怎么读)里对比改动前后时钟树功耗。
- 跑真实向量看活动率:用带反标活动的功耗分析对比热点节点翻转次数(SAIF/VCD),不用默认翻转率自欺。
- 形式/lint 检查:时钟门控 lint(使能跨时钟域、复位可达性)、UPF 一致性检查。
- 必要时上 DPA 看「使能波形」:空闲时该组时钟是否真的拉平。
一个合格的低功耗 RTL 提交,建议在说明里附三件证据:门控覆盖率变化、关键模块活动率对比、面积/时序是否回退——省电不能以偷偷牺牲时序为代价(门控路径会进入时序收敛)。
常见误区
- 误区:到处手写
clk_gated = clk & en。 毛刺风险极高;写规整使能、让工具插库级 ICG 才是正道。 - 误区:信号翻转多就加门控。 时钟门控省的是时钟端和时序单元;组合数据乱翻要用数据门控/operand isolation,对症下药。
- 误区:复位整模块来「省电」。 同步复位会让全部触发器同时翻转一次(巨大峰值,见 IR-Drop),且重启耗能量可能远超省下的;用局部停钟/断电。
- 误区:门控越细越省。 ICG 面积、使能路径和时钟树复杂度有成本,按组折衷。
- 误区:低功耗全靠后端修。 活动率和静止点是 RTL 行为决定的,后端无法把「软件永远在轮询」优化掉。
八、综合前后:一次完整的低功耗 RTL 走查
把前面的手法串成一次可以照着做的走查(以一个 UART→DMA→缓冲的外设子系统为例):
- 结构:接收数据先入小 FIFO,攒够一行才 DMA 搬走;UART 波特率时钟、DMA 引擎、缓冲 SRAM 分属不同时钟组,RTL 给每组留统一的
enable。 - 时钟门控推断:三组寄存器都用规整的「if (group_en) q<=d」写法,
rx_group_en由「UART 使能且有接收活动」驱动,dma_en仅在 FIFO 达阈值到搬完之间为真。综合后核对:三组寄存器被三个 ICG 收编,无散落保持 MUX。 - 数据门控:DMA 源/目的地址和 FIFO 输出在
dma_en=0时锁常量,下游加法器(写指针递增、CRC)不随旧数据抖动。 - 存储器:缓冲 SRAM 的 cs 只在读写拍拉高,行空闲时进入 light retention;系统深睡前电源 FSM 显式下发 sleep 命令。
- 握手与静止点:DMA 完成后释放总线、idle 信号可被 PMU 轮询;UART 接收唤醒信号在常开域经去抖后送 AON。
- 验收:综合报告对比改动前后 ICG 覆盖率和时钟功耗;用真实「90% 时间无通信」的 testbench 出 SAIF,确认空闲窗口 UART 组时钟拉平、DMA 组零活动、SRAM 静态电流档正确。
- 时序复核:使能逻辑进入时钟路径,确认 ICG 使能建立时间在所有角满足,没有因门控引入新的时序违例。
这个走查的每一步都能用工具客观验证,也体现了本篇的核心态度:低功耗 RTL 不是「感觉很省」,而是每一处省电都在波形和报告里有证据。
九、常见编码坏味道对照表
| 坏味道 | 为什么费电 | 改写方向 |
|---|---|---|
| 寄存器更新条件用一堆零散组合项 | 无法共享 ICG,工具退回保持 MUX | 归一成组的、寄存后的 enable |
| 时钟路径上手工与操作 | 毛刺、亚稳态风险 | 交给库 ICG,只写数据侧使能 |
| 大运算器输入无 valid 门控 | 无效周期全阵列翻转 | operand isolation 喂常量 |
| always 块里默认不给所有输出赋值 | 推断锁存器、X 传播、仿真与硅不一致 | default 全赋值,总线空闲给静态值 |
| 轮询式等待(RTL 或配套固件) | 时钟/总线持续活动 | 中断/使能驱动,配合 WFI |
| 复位当清零手段频繁使用 | 全组同翻,电流尖峰 | 局部使能或电源门控 |
| 计数器、分频器自由运行 | 全局时钟上的恒定翻转负载 | 按需启停、使用脉冲使能而非新时钟 |
| 存储器 cs 恒接 1 | 每次无关访问都预充位线 | 真实片选,未中即关 |
十、给入门者的记忆锚点
- 你在 RTL 里控制的是 α 和「被惊动的逻辑规模」。
- 写规整的同步使能,让 ICG 成组出现;永远别手工和时钟。
- 无效数据要在进入大电容逻辑前停下,光停时钟不够。
- 存储、握手、隔离值都要为「睡着」设计,省电不是 wakeup 之后的事。
- 不交门控覆盖率和活动率证据的低功耗优化,等于没做。
这一篇在知识体系里的位置
- 上游:时钟门控原理、翻转率、低功耗手段全景给杠杆排序。
- 本片:把原理翻译成可综合的编码风格与验收动作。
- 下游:存储细节见下一篇存储器功耗直觉、时钟网络本身的代价见时钟树功耗直觉、毛刺机理见毛刺与无效翻转、系统级配合见 UPF/低功耗全流程、代码坏味道的硅后症状见功耗异常排查;通用 RTL 风格与综合语境可参考RTL 设计与逻辑综合。
一句话收口:低功耗 RTL 的本质是让「空闲」在波形上看得见——规整的使能让工具敢于停钟,有效的数据门控让无效操作不惊动大逻辑,存储器与电源握手自觉守规矩;最后用门控覆盖率和活动率报告证明它真的发生了。
总结
RTL 工程师能直接控制的是翻转率 α 和被惊动的逻辑规模:要写规整、成组、寄存后的同步使能让综合器把寄存器收编成库级 ICG(而不是数据保持 MUX,更不能手写 clk&en 造毛刺),用 operand isolation 在无效周期给大电容数据通路喂常量,显式控制存储器片选、用低翻转编码,并为电源门控提供干净静止点和隔离/保持握手。一切优化都必须用门控覆盖率、真实 SAIF 活动率和时序复核三类证据验收,而不是凭「感觉很省」。