IO 时序约束预算:芯片与外部世界之间的时序账怎么算
SDC 时序约束讲过 create_clock/create_generated_clock 给片内时钟立规矩,SDC 约束入门也把约束四件套(时钟、IO 延迟、路径例外、驱动负载)过了一遍。但绝大多数项目里,真正让人失眠的不是片内 reg-to-reg 路径,而是接口路径——数据从外部器件进芯片、从芯片出到外部器件的那一段。片内路径的账全在自己手里,接口路径的账却要跟板级走线、外部器件的数据手册、甚至别家 IP 的吞吐余量分着算。这篇就讲 IO 时序约束预算这门「分账」的手艺:set_input_delay/set_output_delay 的数值从哪来、预算百分比怎么定、没有内部时钟的接口怎么用虚拟时钟立约束、源同步(source-synchronous)接口的约束为什么和普通 SDR 不一样,以及预算被吃爆时的谈判与补救手段。
本文要回答的问题
- set_input_delay 和 set_output_delay 的数值到底在描述什么物理量?和板级走线、外部器件 Tco 是什么关系?
- IO 预算分配有没有公认的比例?30/70、50/50 这些口径各自在什么场景用?
- 接口时钟在片内根本不存在时,虚拟时钟(virtual clock)怎样让 STA 照常分析接口路径?
- 源同步接口(随路时钟)的约束写法和系统同步有什么本质区别?DDR 的双沿采样怎么处理?
- 外部器件把预算吃光了、或者第三方 IP 自己带的约束和顶层冲突,怎么办?
一、接口路径的特殊性:时钟的两头不在同一个屋里
片内 reg-to-reg 路径有一个好性质:发射触发器和捕获触发器由同一个时钟树驱动,STA 只需要把两端的时钟延迟都算出来、做个差,剩下的就是数据路径与周期比对。接口路径打破了这个前提——发射端在隔壁那颗 FPGA 里,时钟从它的 PLL 出来,走板上 8 厘米的走线,连带着这颗芯片的焊盘延迟一起,才到你的输入端口。这一大段片外延迟 STA 一无所知,必须由 SDC 显式告诉它。
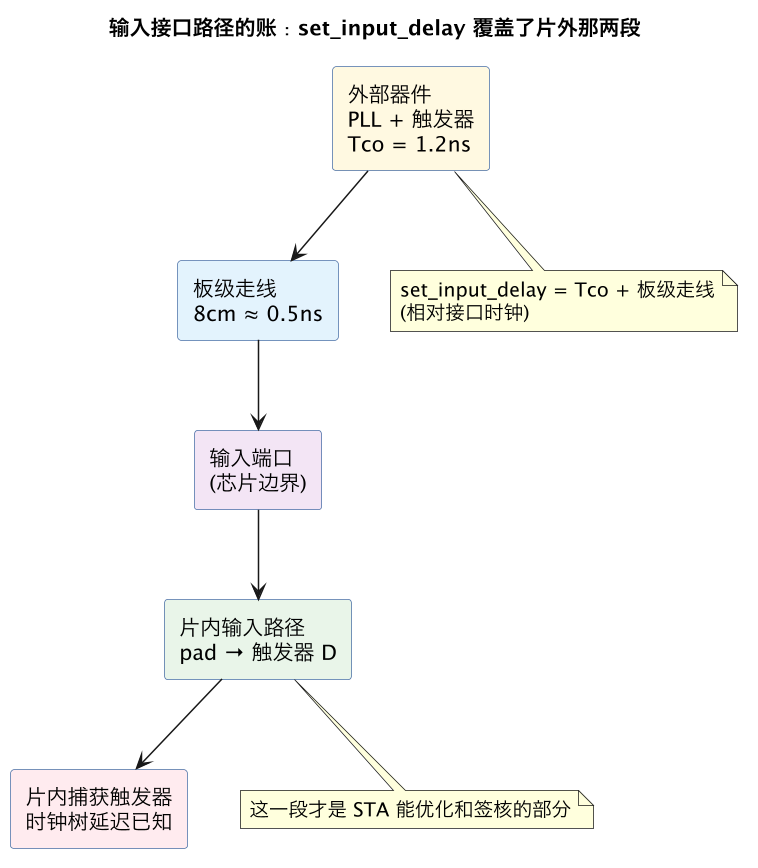
这张图把 set_input_delay 的物理含义说透了:它是从接口时钟的有效沿,到数据真正出现在输入端口之间的所有片外延迟之和,包含外部器件的时钟到输出(Tco)和板级走线飞行时间。SDC 写法是:
set_input_delay -clock CLK_IF -max 1.7 [get_ports {din[*]}]
set_input_delay -clock CLK_IF -min 0.4 [get_ports {din[*]}]
-max 喂 setup 分析(数据最晚多晚到),-min 喂 hold 分析(数据最早多早变)。输出方向对称:set_output_delay 描述的是数据离开芯片之后,到外部器件捕获沿还需要多少片外时间——外部器件的建立时间要求加上板级走线。方向反了,但记账逻辑完全一样。
set_output_delay -clock CLK_IF -max 0.9 [get_ports {dout[*]}]
set_output_delay -clock CLK_IF -min -0.3 [get_ports {dout[*]}]
注意 -min 可以是负数:外部器件 hold 时间为负或走线很快时,数据在捕获沿之后还能再变一点,负值如实反映这个事实。很多新手看到负数不敢写、强行钳到 0,等于白送外部器件一段 hold 余量,让自己的 hold 修复白做。
二、预算分配:接口周期这块饼怎么切
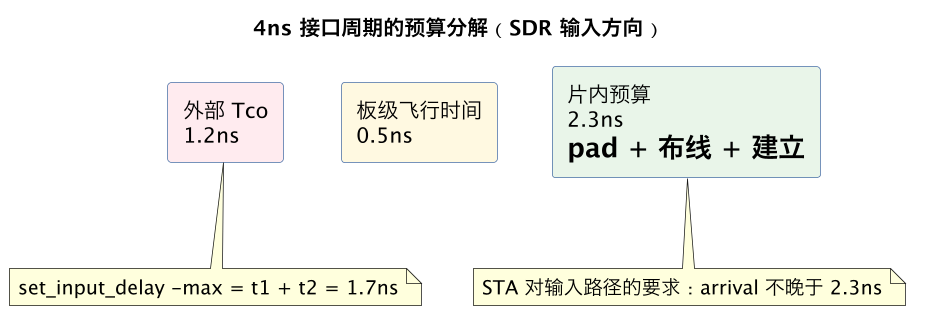
假设接口时钟周期 4ns(250MHz DDR 之前先按 SDR 讲),外部器件数据手册给 Tco(max)=1.2ns、板级走线 0.5ns,那么 set_input_delay(max)=1.7ns,留给片内输入路径的预算是 4−1.7=2.3ns。这个 2.3ns 就是「预算」——片内组合逻辑、pad 延迟、输入寄存器建立时间都要在里面消化。预算分配的核心问题是:片外和片内各分多少,谁说了算?
工程上有三档常见口径:
| 口径 | 片内分配 | 适用场景 | 风险 |
|---|---|---|---|
| 按数据手册实算 | 手册 Tco + 走线实测/仿真 | 接口对象固定、有完整 IBIS 模型 | 手册只给典型值时偏乐观 |
| 30/70 法则 | 片内 ≤30% 周期 | 通用数字接口、快速估约束 | 高速接口可能过于宽松或严苛 |
| 50/50 对半 | 片内 50% | 接口对象未定、先期估预算 | 实际器件进来后大概率重谈 |
三个容易踩的坑:
- 只用 -max 不写 -min:很多约束文件里输入路径只签 setup,hold 靠「片内插 buffer 总够」的信仰。先进节点下最小延迟路径被 OCV 收紧后,接口 hold 违例是流片后最高发的事故之一,
-min必须照数据手册的 Tco(min) 写; - 把 pad 延迟算进片内预算却忘了它存在:IO pad 自身的延迟在先进工艺下能到 0.3-0.5ns,PVT 角间变化巨大,预算表里必须单列一行,不能在「布线余量」里含糊掉;
- 多角下预算不自洽:cworst 角下片内延迟变长、片外器件的 Tco 也在变(手册给的是自己角下的数)。跨角核对时要用同一温度口径的 Tco,拿 25°C 典型值配 125°C 的 STA 签核角是自欺欺人,多 scenario 的配对纪律见 MMMC 角与模式管理。
输出方向的预算同理反着切:周期减去 set_output_delay(max) 之后,剩下的才是片内输出路径允许花掉的时间。
三、虚拟时钟:给「不存在的时钟」立约束
上面所有写法都有个前提:CLK_IF 这个时钟在片内真实存在、被 create_clock 定义过。但有一大票接口不满足这个前提——最典型的就是输出接口:数据从片内触发器发出,捕获它的时钟在外部器件里,片内根本没有这个时钟的任何引脚或网络。不给时钟就没法写 set_output_delay(-clock 参数要指向一个已定义时钟),不给约束 STA 就把这条路径当 unconstrained,签核报告里一片岁月静好,实际完全没查。
解法是虚拟时钟(virtual clock):定义一个没有源(不挂任何 port/pin)的时钟对象,它只作为 IO 延迟约束的参照系存在。
create_clock -name VCLK_OUT -period 4.0    # 无 source,即虚拟时钟
set_output_delay -clock VCLK_OUT -max 0.9 [get_ports {dout[*]}]
set_output_delay -clock VCLK_OUT -min -0.3 [get_ports {dout[*]}]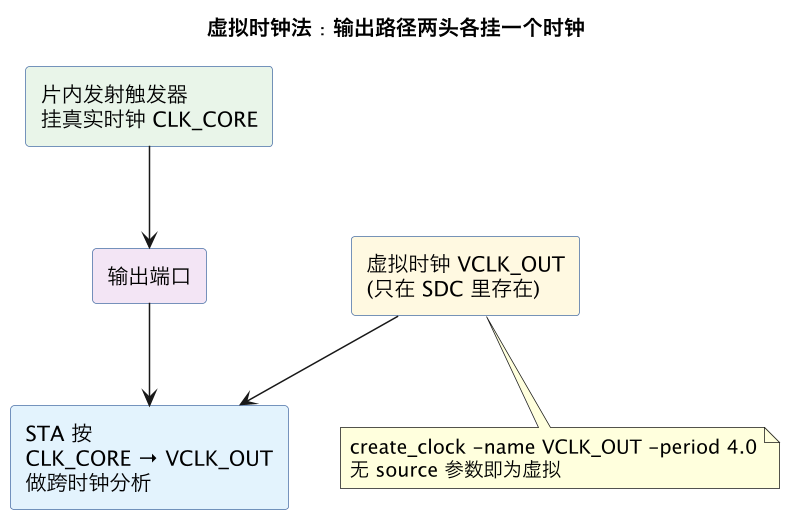
这张图的要点:虚拟时钟让 STA 把输出路径当成一条「CLK_CORE 发射、VCLK_OUT 捕获」的跨时钟路径来分析。只要两个时钟的周期、相位关系定义正确,setup/hold 检查、slack 报告、时序例外全部照常工作,和真实时钟没有任何区别。虚拟时钟还顺带解决三类问题:
- 输入接口的片外时钟不可见:外部器件时钟没引进片内时,同样用虚拟时钟代表它,set_input_delay 相对它记账;
- 异步接口的隔离:两片时钟域之间本来就要做 [CDC 检查],用不同名的虚拟时钟自然把接口路径从片内时钟组里隔出来,配合 set_clock_groups 管理;
- 多接口共用一个片内时钟但预算不同:给每个接口各建一个虚拟时钟,各自挂各自的 IO 延迟,互不干扰。
有一个纪律必须强调:虚拟时钟的周期和相位必须如实反映外部器件的时钟。外部是 250MHz 就写 4.0ns,写成 2.0ns 等于替外部器件「加速」,约束偏紧还好,写成 8.0ns 就是把没检查的路径伪装成合格。
四、源同步接口:时钟跟着数据一起上路
系统同步(system-synchronous)接口里,时钟由一个公共源分发给双方,走线长度差、器件延迟差全部计入预算,频率一高账就算不平——板级偏差轻松吃掉小半个周期。源同步(source-synchronous)接口换了个思路:发送方把时钟和数据一起发出来(随路时钟,forwarded clock),接收方用这根随路钟直接采样数据,时钟和数据走几乎相同的路径,片外偏差在两者间互相抵消,频率可以冲到数 Gbps。DDR、QDR、大量 SerDes 低速回采通路都是这个套路。源同步接口的采样原理讲过接收侧的 capture 结构,这里只讲约束写法。
源同步接口分两种数据对齐方式,约束思路完全不同:
| 对齐方式 | 时钟与数据关系 | 接收策略 | 约束关键词 |
|---|---|---|---|
| 边沿对齐(edge-aligned) | 时钟沿与数据沿同时到 | 片内 PLL 把时钟移相 90° 再采样 | 用 create_generated_clock 描述移相 |
| 中心对齐(center-aligned) | 时钟沿落在数据眼中央 | 直接采样 | set_input_delay 按眼图边沿写 |
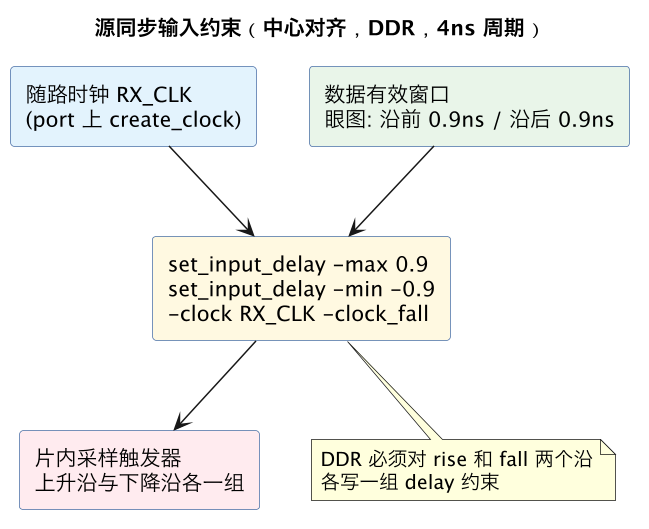
中心对齐的记账方式很直观:数据手册给出「数据相对时钟沿的偏移窗口」,setup 侧是数据最晚偏离窗口中心多少(正值),hold 侧是数据最早提前多少变化(对中心对齐接口通常写成负的 -min,因为数据在时钟沿之前就到了)。DDR 的要点是 -clock_fall 与 -add_delay 成对出现:上升沿采样的数据组和下降沿采样的数据组各有自己的有效窗口,漏写 fall 组等于只签了一半的数据位。
边沿对齐接口更绕一步:片内 PLL/延时线把随路钟移相 90°,这个移相必须用 create_generated_clock 在采样点显式建模,否则 STA 默认按时钟沿采时钟沿,约束全错。另一个常见漏项是源同步接口的片外偏差预算——虽然随路钟抵消了大部分偏差,但时钟走线和数据走线在板上的长度差(flight time skew)仍然存在,高速接口要用 set_input_delay 的 -max/-min 差值如实反映这个 skew,而不是把窗口写成理想对称。
五、预算被吃爆怎么办:谈判、重切与补救
实际项目里,预算表从来不是一次写死的。三种典型冲突和对应的出路:
其一,外部器件比预期慢。 比如电源芯片换成兼容型号后 Tco 从 1.2ns 涨到 2.0ns,片内预算从 2.3ns 被压到 1.5ns。出路按代价排序:先在片内把输入路径打平(输入寄存器挪进 IOB/紧靠 pad 的布局锁定,是 FPGA 和 ASIC 都有的标准做法);再和系统组谈——把走线缩短、驱动增强,把 0.5ns 的飞行时间压到 0.3ns;最后才是降频,这是所有人都不愿看到但最诚实的选项。
其二,第三方 IP 自带约束与顶层打架。 硬核 IP(DDR PHY、PCIe 控制器)通常自带一份 SDC,里面定义了自己的接口延迟假设。顶层集成时必须做一次约束对账:IP 的 set_input_delay 是相对哪个时钟写的、预算百分比和顶层口径是否一致、IP 内部是否已把接口路径寄存到边界。这类对账属于 X1 交接契约里点名的检查项,漏掉的典型症状是 IP 级签核全绿、顶层接口路径一片红。
其三,预算表没人维护。 约束文件里的 1.7ns 来自三年前的数据手册版本,器件换版后没人回来看 SDC。纪律只有一条:预算表作为一份显式文档(哪怕就是 SDC 文件头部的一段注释表),列出每个接口的 Tco 来源、走线假设、预算切分比例,器件选型或 PCB 改版时按表回归。STA 签核枢纽 S5 要求接口约束和 SPEF 寄生提取一样纳入版本冻结,道理相同——约束本身就是签核数据。
最后说一个容易被忽视的正向手段:set_max_delay/set_min_delay 兜底。对某些实在拿不到外部参数的低速接口(比如板级拨码开关、状态指示灯),与其拍脑袋写 IO 延迟,不如直接用 set_max_delay 把接口路径框在一个保守值内,并在约束注释里写明「外部参数未知,保守兜底」。显式的保守胜过隐含的乐观,STA 报告里至少能看到这条路径被检查过。
六、典型翻车点
| 事故 | 根因 | 拦截动作 |
|---|---|---|
| 接口路径 unconstrained | 输出接口没建虚拟时钟 | report_timing -unconstrained 必须为空 |
| 硅上 DDR 读写偶发错误 | 只签了 rise 沿,fall 沿没写约束 | DDR 约束 checklist:rise/fall 成对审计 |
| 顶层接口全红、IP 内全绿 | IP 自带 SDC 与顶层预算口径不一致 | 集成时做约束对账(X1 契约项) |
| hold 在 -40°C 成片失效 | 输入 -min 按典型 Tco 写,没按手册最小值 | min/max 两份都照数据手册极端值 |
| 约束偏紧虚报违例 | 虚拟时钟周期写得比外部实际快 | 预算表登记外部时钟频率并随选型回归 |
| pad 延迟漏算 | 预算表把 pad 混进「布线余量」 | pad 延迟单列一行,按 PVT 角取值 |
这一篇在知识体系里的位置
- 上游与基础:SDC 时序约束总览讲 create_clock 与约束加载顺序,SDC 约束入门讲四件套语法;本篇是它们在接口路径上的专项展开。
- 姊妹篇:源同步接口采样讲接收侧电路结构,本篇讲对应的约束写法。
- 下游:IO 约束作为 scenario 的一部分进入 MMMC 多角签核,由 PrimeTime 黄金 STA 在每个角下逐条检查;接口路径的片内段延迟来自 SPEF 寄生提取的反标,OCV 与寄生建模进一步收紧片内段悲观度。
- 契约与收敛:第三方 IP 的约束对账见 X1 交接契约,整链路的签核收敛逻辑见 S5 签核枢纽。
总结
IO 时序约束预算就是把接口周期这块饼在片外(外部器件 Tco、板级走线)与片内(pad、布线、寄存器建立)之间切清楚:set_input_delay/set_output_delay 照数据手册的 max/min 极端值记账、片内没有对应时钟就用虚拟时钟立参照系、源同步接口用随路钟加 rise/fall 成对约束如实描述数据眼窗口,再把预算表当作签核资产冻结维护——接口路径的账算不实,片内做得再干净,芯片到板子上照样翻车。