FPGA 原型验证专题 27:在电路仿真(ICE)与协同加速模式——两种上板模式的接线、时钟纪律与负载选择
更新时间:2026-09-13。本文是原型外围姊妹系列第二篇。34 FPGA 与仿真器互联 从拓扑上画过软件仿真器、仿真加速器(Emulator)、FPGA 原型三者如何用事务级桥(SCE-MI)连起来;26 事务处理器 SCE-MI 三类通道/transactor 实现 实现了跨速度鸿沟的事务处理器。本篇往下落一层:原型真正上板跑负载时,ICE 和协同加速这两种主力模式分别怎么接线、怎么配时钟、能跑什么、不能跑什么。
这一篇在体系里的位置
很多新人把"原型"理解成一种单一的东西:综合出比特流、烧到板上、连上线就跑。实际上同一个比特流底座,根据"外部世界有多少是真的、多少是主机里的模型",可以配成性质很不一样的两种运行模式:
- ICE(In-Circuit Emulation,在电路仿真/在电路模拟):原型板物理地插在真实系统里冒充芯片——接真实的 PHY、真实的 DDR、真实的 PCIe 端点、真实的调试器,甚至直接焊在目标板的芯片插座上。时钟来自真实世界或板上自由振荡器,FPGA 以它能达到的最高频率自由跑。
- 协同仿真加速(co-simulation / co-emulation acceleration):不接(或不全接)真实器件,没被建模的环境留在主机仿真器或 C 模型里,DUT 在 FPGA 上加速执行,两侧经 26 事务处理器 SCE-MI 三类通道/transactor 实现在事务级或周期边界同步。
理解这两种模式,是理解原型"什么时候可信、什么时候不可信"的前提(可信度的方法学在后续 E2 篇展开,本篇聚焦操作面)。
本文要回答的问题
- ICE 到底"在电路"里扮演什么角色?为什么它能跑真实软件和真实流量,却对时钟和速率适配极挑剔?
- 协同加速模式里主机侧和 FPGA 侧怎么分工、在什么边界同步?C/DPI、SystemVerilog BFM 怎么接进来?
- 两种模式的接线拓扑、时钟复位来源、速率适配各有什么硬约束?
- 同一套 DUT/比特流,怎么在两种模式间切换?切换的真实代价是什么?
- 混合模式(一部分接口真实、一部分建模)什么时候必要,怎么组织?
- 软件 bring-up、定向功能验证、长稳 soak、性能测量、活动采集分别该选哪种模式?
一、两种模式的本质区别:外部世界的"真实比例"
一句话区分:ICE 用真实世界当 testbench;协同加速用主机里的模型当 testbench,FPGA 只加速 DUT。
| 维度 | ICE 在电路仿真 | 协同仿真加速 |
|---|---|---|
| 测试环境 | 真实器件/PHY/仪表/目标板 | 主机内 C/SystemVerilog/DPI 模型 |
| DUT 时钟 | 自由跑(板上晶振/MMCM),尽量快 | 受同步边界约束,可锁步可近似自由 |
| 与主机耦合 | 弱:上电后基本自主运行 | 强:每个时间窗与主机交换事务 |
| 速度 | 最快(MHz 级),取决于降频/TDM | 中:受主机交换拖累,百 kHz~数 MHz |
| 时序真实性 | 高(真实对端、真实反压) | 取决于模型保真度 |
| 内部可见性 | 靠预先插桩/trace(见 D 篇) | 好:可借助仿真器侧信号与断点 |
| 典型负载 | 真实 OS/固件、真实流量、长稳、活动采集 | 早期 RTL 调试、定向用例、未就绪接口的环境补齐 |
| 前置条件 | 接口能以可接受速率连真实世界(速率适配) | 有可综合 transactor + 主机侧模型 |
关键推论:**ICE 快且真,但"瞎"且挑剔环境;协同加速慢一点、可见性好、能在接口还没成熟时就跑。**项目里两者不是二选一,而是随 RTL/接口成熟度接力——这一点和 06 原型验证系统全景与文档地图 三引擎接力的时间线一致,只是这里聚焦原型自身的两种配法。
二、ICE 模式:接线、时钟与"必须像真芯片"
2.1 典型接线
ICE 的物理形态是让原型在目标系统里"就是那颗芯片"。常见接法:
- 插座替代(bond-out / socket replacement):早期原型板直接通过封装适配器插在 ASIC 的目标板插座上(多见于较小芯片或老项目)。
- 线缆/子卡连接:大容量多 FPGA 原型通过接口板、速率适配子卡(daughter card)连到目标系统,FPGA IO 经电平转换、连接器接到目标板对应引脚(子卡生态见后续 C4 篇)。
- 独立工作台直连仪表/设备:不进整机,而是直接把真实 PCIe endpoint、真实以太网对端、真实 DDR 条、真实摄像头/显示屏接到原型子卡上,做分接口 bring-up。
无论哪种,DUT 看到的必须是电气和协议上真实的对端:真实的链路训练、真实的反压、真实的刷新与时序。这正是 ICE 价值的来源——软件和协议栈无法分辨(或极难分辨)自己跑在 FPGA 还是真芯片上。
2.2 时钟纪律:自由跑带来的三条铁律
ICE 模式下 DUT 时钟自由跑,由此产生三条不能违反的纪律:
- **时钟源要独立于主机。**一旦进入 ICE,DUT 时钟不能由主机软件门控或单步(那是 67 篇的锁步模式)。时钟来自板上晶振/MMCM 或从真实接口恢复,保证真实软件的看门狗、超时、定时器按预期推进。
- **降频必须对软件透明且均匀。**原型因 TDM/跨片降到 1~30 MHz(19 原型频率与时序收敛 TDM 降频/关键路径),相对真芯片是"均匀变慢"而非"时快时慢"。绝大多数软件依赖时钟周期计数(mtime/通用定时器)而非墙钟,均匀降频下它感知到的只是"世界变慢了",逻辑仍自洽;但若跨片 TDM 让某条路径延迟不均匀地抖动,依赖精细超时的驱动可能误判——这类点要在 bring-up 清单里单列。
- **真实接口必须经过速率适配。**真实协议跑在数百 MHz 到数十 Gbps,原型 IO 往往给不到。直连必然失败:对端器件按自己的速率发起链路训练,原型跟不上就是训练失败/误码。速率适配器(speed adapter,C1 篇主题)在中间做协议重建或降速桥接,把"慢而稳的原型侧"和"快而真的器件侧"隔离开。ICE 能不能成立,往往取决于关键接口有没有合格的速率适配方案。
2.3 ICE 能跑什么、不能跑什么
ICE 擅长:真实 OS/RTOS 启动与驱动(29 固件 shift-left RTL 冻结前 bring-up/驱动开发/30 Linux/RTOS 在原型上启动 启动链/降频补偿/时间换算展开)、真实网络/存储流量下的长稳 soak、真实使用场景的活动率与性能相对测量、需要真实 PHY 行为的协议互通测试。
ICE 不擅长/不能回答:绝对时序与 ASIC 时序签核(FPGA 时序与 ASIC 无关,见 06 原型验证系统全景与文档地图)、模拟/SerDes/DDR PHY 的工艺相关表现(原型里多为替换 IP 或外部真芯片,不代表目标工艺)、电源域/UPF 行为(被折叠为常上电)、功耗绝对值(只能给活动数据,见 25 真实激励驱动 ASIC 签核 SAIF 反标/边界)。
三、协同仿真加速模式:主机侧与 FPGA 侧怎么分工
当某些接口还没有真实器件可接、或环境在仿真器里已有成熟模型时,就用协同加速:把计算量最大、并行度最高的 DUT 放 FPGA,把尚未就绪、需要高可见性、或本质是软件的环境留在主机。
3.1 典型拓扑
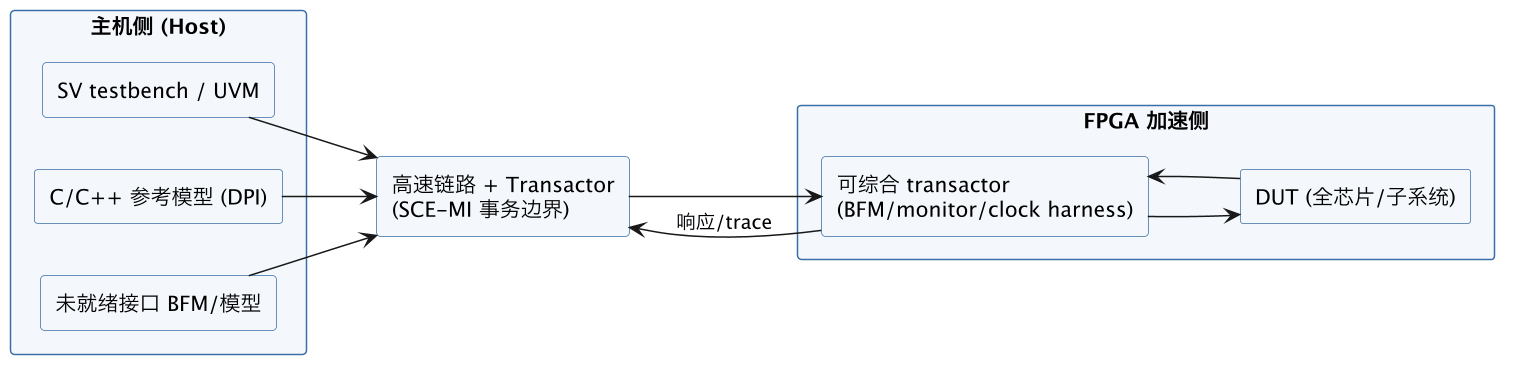
主机侧常见三类组件:
- SystemVerilog/UVM testbench:复用模块级已有的 sequence、driver、scoreboard,只把 DUT 这一"大块"卸载到 FPGA。
- C/C++ 参考模型(经 DPI/VPI):处理器核的 ISS、协议参考栈、软件激励,用 C 写比 RTL 快、比在 FPGA 里建模灵活。
- 未就绪接口的 BFM/行为模型:某个外设 RTL 还没交付,先用主机模型顶上,让其余部分提前联调——这是协同加速相对 ICE 的独特优势,不依赖真实世界齐备。
两侧的同步通过 26 事务处理器 SCE-MI 三类通道/transactor 实现的事务处理器完成,同步粒度有两种:
- 事务级(transaction-based / TBA):只在事务边界交换,FPGA 内 BFM 自主展开引脚时序,速度快,是主力模式;
- 周期级(cycle-based / 锁步):每个(或每 N 个)时钟沿两侧对齐,可见性最高、可严格复现,但速度最慢,只用于精确定位和对拍。
3.2 时钟与复位在加速模式下的特殊性
ICE 的时钟是"自由的物理时钟",加速模式的时钟往往是由时钟/复位 harness 生成、可被同步边界控制的逻辑时钟:
- 锁步时 harness 按主机的 advance 指令产生时钟,DUT 在两次同步之间推进固定周期;
- 事务级近似自由跑时,harness 内部自由振荡,但在跨边界需要一致性时(例如要采一致快照)插入 barrier;
- 多时钟设计要在 harness 里保持各时钟的频率比例(哪怕整体被降速),否则 CDC 行为、波特率分频、定时器比值全部失真。这是加速模式比 ICE 更容易踩的坑:ICE 时钟来自真实世界天然成比例,加速模式时钟是人造的,比例要自己保证。
3.3 加速模式的独特价值与代价
价值:早期可用(外设 RTL 没齐也能跑)、可见性好(主机侧可打断点、看任意仿真变量)、可严格复现(锁步 + 固定种子)、能直接复用 UVM 资产(同一套 sequence 跑仿真与加速)。
代价:速度比 ICE 低(同步开销);环境模型的保真度成为可信度天花板——主机 BFM 若把某个握手细节建模错了,DUT 在加速模式"通过"不代表真实世界通过;软件栈/长时负载在频繁同步下跑不动,因此操作系统启动、长稳 soak 最终必须转 ICE。
四、两种模式对照与混合模式
4.1 决策对照
| 你要做的事 | 推荐模式 | 原因 |
|---|---|---|
| RTL 早期、某接口未就绪的联调 | 协同加速 | 用主机模型补齐未就绪环境 |
| 精确定位某功能 bug、要复现 | 加速(锁步) | 可见性+确定性 |
| 复用 UVM sequence 跑子系统 | 加速(事务级) | testbench 资产直接复用 |
| 启动 Linux/RTOS、跑驱动 | ICE | 长交互、真实时序、自由时钟 |
| 真实网络/存储流量、协议互通 | ICE | 真实 PHY/端点行为 |
| 7×24 长稳 soak | ICE | 速度快、单位机时便宜 |
| 活动率/功耗激励采集 | ICE(时钟不停) | 停时钟会让活动率失真 |
| 架构性能相对测量 | ICE + 校正模型 | 需扣跨片/TDM,见 E3 篇 |
4.2 混合模式:真实与建模并存
真实项目很少是纯 ICE 或纯加速,更多是混合:DUT 的一部分接口走真实边缘(经速率适配接真器件),另一部分走 transactor 接主机模型。典型场景:
- 网络口接真实对端跑背景流量,但一个尚未流片的配套传感器用主机 C 模型经 transactor 注入;
- 真实 PCIe 端点在板,但配置/管理面用 UVM testbench 经加速通道下发;
- 处理器跑真实固件(ICE 风格),同时某类异常流量由主机 BFM 制造。
混合模式的工程要点:
- 公共时基:真实边缘(自由跑)与建模边缘(可能被 barrier 停顿)必须共享同一套时钟/时基编排,否则两类激励在 DUT 时间轴上对不齐(67 篇第四节)。
- 真实边缘不能被主机拖停:建模侧在做慢同步时,不能让真实接口的时钟跟着停——真实对端不会等你,停了就是链路掉线。需要把自由时钟域与被门控的同步域隔离。
- 保真度清单显式化:在报告里写清"哪些接口是真的、哪些是模型、模型版本是什么",结论使用方才知道哪些行为可信。
五、在两种模式间切换:工程现实
理想情况下同一比特流 + 可配置的时钟/接口 harness 支持两种模式,切换只是改配置和接线;现实中有几处实打实的代价:
- 综合选项可能不同:加速模式需要的 transactor/时钟控制/快照逻辑是额外可综合结构,可能影响资源与频率;有的团队为此出两版比特流(ICE 版省掉主机接口、加速版带上)。
- 时钟结构要可重配:同一套 MMCM/PLL/分频既要能接自由晶振,也要能接 harness 受控时钟,时钟 MUX 与复位树要在设计阶段就预留。
- 约束与时序收敛口径不同:ICE 关心真实 IO 时序,加速关心内部 DUT↔transactor 接口时序;跨片(13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频)与降频(19 原型频率与时序收敛 TDM 降频/关键路径)在两模式下的关键路径不同。
- 测试资产要双模式可移植:事务级 test program 写成与模式无关(67 篇第六节),切 ICE 时改由真实软件/器件产生等效流量,切加速时由主机产生。一开始就按这个原则写,切换成本低;写成绑定某模式,后期要重写。
成熟做法是把"模式"作为构建配置(build mode)纳入 20 比特流烧录与四方版本一致 manifest/门禁:比特流文件名里带 ice/accel,配套 harness、transactor、脚本版本一并锁定,避免"拿加速版比特流去接真实器件"这类低级但致命的错配。
六、落地检查清单
ICE 上电前:①目标接口速率适配方案就绪并验证过;②DUT 时钟来自自由源、降频均匀;③真实对端/仪表/线缆电平确认;④复位时序与真实系统一致;⑤看门狗/超时类时间预算按降频系数核对;⑥trace/采集预插桩(ICE 可见性差,事后补探针要重综合)。
加速联调前:①主机 BFM/C 模型版本与 RTL 对齐;②时钟 harness 保证多时钟频率比例;③选定同步粒度(事务级/锁步);④barrier/快照点设计好;⑤能复用的 UVM sequence 已移植;⑥模型保真度清单与局限写进验证计划。
混合模式:①真实边缘与建模边缘时基统一;②真实边缘不被主机同步拖停;③哪些真、哪些建模显式记录。
七、时钟/复位编排与时序预算:容易被忽略的工程细节
两种模式都依赖一个常被低估的基础设施——时钟与复位编排(clock/reset harness),它在平台准备期就要做好(06 原型验证系统全景与文档地图强调基础设施前置),否则每次 bring-up 都要临时接线。
**时钟来源矩阵。**一个多 FPGA 原型上通常同时存在:板上可编程晶振/晶振组、各 FPGA 的 MMCM/PLL、从高速接口恢复的 recovered clock、给子卡的 refclk、JTAG 的 TCK。harness 要回答:哪个时钟是 DUT 主时钟、哪些是派生时钟、频率比例是多少、ICE 时从哪来、加速时能否被门控。典型做法是用一个可软件配置的时钟控制块(clock control IP)统一管理,支持选源、分频、gate/ungate、占空比和相位查询,并把这些寄存器挂在调试总线上,调试器和 transactor 都能控制。
**复位树。**SoC 原本的复位树(POR、各子系统复位、调试复位)在多片展开后会被切碎:一部分在片内、一部分跨片。要保证:①一次"全局复位"能确定性地到达所有片上的所有复位域,且撤销顺序确定(时钟先稳后撤复位);②调试器能单独复位核而不动外设(69 篇的 reset-and-halt);③transactor/模型侧能感知复位、清空自己的 FIFO,避免复位前的旧事务在复位后灌进新现场。复位撤销不同步是"同一比特流、每次上电行为不一样"的主要根源之一。
**时序预算怎么估。**做模式规划时要给每条关键路径一个时序预算表:DUT 内延迟、跨片 TDM 延迟(13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频)、CDC/弹性 FIFO 延迟、适配桥缓冲延迟、真实 PHY/对端延迟。ICE 实时负载关心的是"总延迟会不会超过对端超时";加速模式关心的是"一次主机-硬件往返要多少个同步点"。这个预算表在项目早期估不准没关系,但要随每次分区结果更新,它是后来解释性能数据(E3 篇)和决定接口能不能直连的依据。
**一个常被忽略的点:模式切换时的时钟/复位一致性。**如果同一块板要在 ICE 与加速之间切换,务必确认切模式时所有 FPGA、子卡、时钟芯片一起重新初始化,而不是只改 FPGA 一侧。子卡 PHY 若仍保持上一种模式的训练状态,重新跑会出现"必须彻底断电才能恢复"的顽固状态——这类问题在 bring-up 后期会浪费大量时间。
与系列及现有篇目的链接
- 三引擎连接拓扑:34 FPGA 与仿真器互联
- 事务处理器实现(本篇的底座):26 事务处理器 SCE-MI 三类通道/transactor 实现
- 降频与时序:19 原型频率与时序收敛 TDM 降频/关键路径、跨片 13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频
- 版本纪律:20 比特流烧录与四方版本一致 manifest/门禁
- 速率适配(ICE 成立的关键):31 速率适配器 Speed Adapter 弹性FIFO/两种范式、73 DDR 接入、74 PCIe/SerDes 上原型
- 体系与能力边界:06 原型验证系统全景与文档地图、活动数据 25 真实激励驱动 ASIC 签核 SAIF 反标/边界
总结
一句话总结:同一个原型比特流按"外部世界有多真"配成两种主力模式——ICE 让原型物理冒充真芯片、时钟自由跑、直连经速率适配后的真实 PHY/DDR/PCIe/调试器,最快最真但可见性差且对速率适配极苛刻,专跑真实 OS/固件、真实流量、长稳 soak 与活动采集;协同加速把 DUT 放 FPGA、把未就绪接口和高可见性环境留在主机(SV/UVM、C/DPI、行为 BFM),经 transactor 在事务级(快、主力)或周期锁步(慢、可严格复现)同步,能在接口没齐时提前联调、直接复用 UVM、精确定位 bug,但速度受同步拖累、时钟频率比例必须由 harness 人为保证、模型保真度就是可信度天花板;真实项目多为混合模式,铁律是真实边缘绝不能被主机慢同步拖停、两类边缘要共用时基、哪些真哪些建模要显式记录;模式切换涉及综合选项、时钟 harness、约束口径和测试资产,最好从一开始就把 test program 写成与模式无关、把 ice/accel 作为构建模式锁进版本 manifest——先在加速模式把功能点亮、再转 ICE 跑真实软件与长稳,是一条被反复验证的节奏。