关联数组方法:exists/first/next 遍历、delete 与稀疏存储在 scoreboard 里的正确用法
更新时间:2026-10-02。SystemVerilog 的关联数组(associative array)是验证工程师手里最接近「哈希表」的内建数据结构:用任意类型的键索引,只存储实际写入过的元素,天然适合地址稀疏、键不连续的建模场景——比如 scoreboard 里按事务 ID 暂存在途请求、覆盖率采样里按地址段统计命中。站内的 队列与关联数组方法 从两种结构的对比视角做过总览,数据类型 packed 与 unpacked 讲了数组在内存里的布局基础。这一篇把镜头拉近,只聚焦一件事:关联数组的内建方法(methods)——
exists、first、next、last、prev、delete、num每个到底怎么工作,遍历有哪些顺序陷阱,以及稀疏存储特性在 scoreboard 里怎么真正省内存。关联数组方法看着简单,实际项目里至少一半的使用错误出在「把遍历当数组下标循环」和「以为 delete 整个数组是释放内存」这两处。
本文要回答的问题
- 关联数组的稀疏存储到底是什么意思,为什么它比普通数组省内存?
exists为什么不只是「查有没有」,它还是避免仿真器警告的规范动作?first/next/last/prev遍历顺序由什么决定,字符串键和整数键一样吗?delete带不带参数、num返回什么,清表和释放内存是一回事吗?- scoreboard 里用关联数组暂存在途事务的完整写法长什么样,有哪些必踩的坑?
一、稀疏存储:关联数组为什么不是「大下标数组」
先钉死语义。普通定长数组 int a[1024] 在 elaboration 时就分配 1024 个槽位,不管你写没写;动态数组 int a[] 用 new[n] 一次性分配 n 个槽位。关联数组 int a[longint] 完全不同:它只为你实际写入过的键分配存储。写 a[32'h1000] = 5; a[32'hFFFF_0000] = 7; 之后,数组里只有两个元素,不是 4G 个。这就是稀疏存储(sparse storage)——键空间可以巨大,物理存储只跟着「被碰过的键」走。
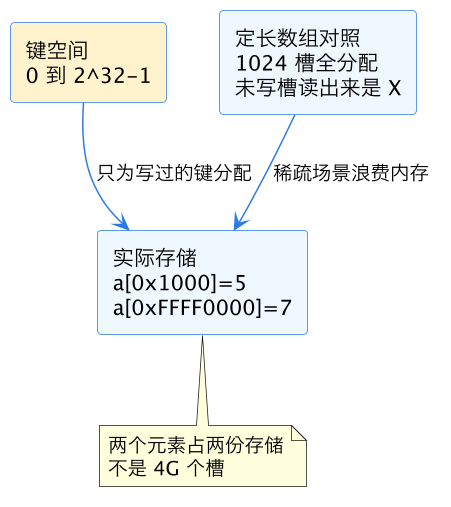
上图是理解全篇的地基:关联数组的键空间(左边黄色卡片)和物理存储(中间)是两回事。工程价值立刻显现——建模一个 32 位地址空间的外设寄存器镜像,用定长数组根本开不出来,用关联数组只花「实际访问过的地址数」份内存。代价也有:每次访问要走哈希查找,比定长数组的地址偏移慢;键的存储本身也要占空间(键和值一起存)。所以经验法则是:键连续且密集用定长/动态数组,键稀疏或键不是整数(字符串、类句柄、结构体)才上关联数组。
二、exists 与 num:查询类方法的两个面孔
读关联数组有一个反直觉行为:读一个不存在的键不会报错,而是返回该类型的默认值(int 返回 0,四态类型返回 X,类句柄返回 null)——而且部分仿真器会顺手发一条 warning。更要命的是,某些仿真器对这种「野读」还会真的把该键建出来(读后即存在),导致 num 悄悄变大。所以规范动作是:读之前先 exists。
int table[string];

if (table.exists("rd_count")) begin
  total += table["rd_count"];
end else begin
  table["rd_count"] = 1;   // 首次出现,自己建立
end
num 返回当前实际存储的元素个数,不是最大键值,也不是容量。它和 exists 搭配的典型用途是做容量门禁:scoreboard 里在途事务数超过阈值就报警,说明 DUT 可能丢响应或者你的 reference model 漏配对。注意 num 是方法不是变量,写 a.num 不带括号在多数仿真器里能过,但带括号 a.num() 才是 IEEE 1800 标准写法,移植性更好。
三、first / next / last / prev:遍历四件套的顺序陷阱
关联数组没有「下标从 0 到 n-1」的概念,遍历必须靠四个方法接力:first(ref key) 把最小键放进 key 并返回 1(空表返回 0),next(ref key) 把比当前 key 大的下一个键放进 key,依此类推;last 和 prev 是反向版。标准写法是:
longint idx;
if (pend.exists(idx)) begin  // 错!exists 不是遍历起点
end

// 正确:
if (pend.first(idx)) begin
  do begin
    $display("key=%0h val=%0h", idx, pend[idx]);
  end while (pend.next(idx));
end第一个陷阱是顺序。first/next 的「下一个」按什么排?整数键按数值升序,这符合直觉;字符串键按字典序(lexicographic order),即逐字符比较 ASCII——所以 "10" 排在 "9" 前面。项目里真实踩过的事故:用字符串存的十进制序号 "1", "2", ..., "10" 遍历出来顺序是 1, 10, 2, 3...,下游按遍历顺序比对日志直接错位。教训:需要保序的整数场景就用整数键,不要用字符串。
第二个陷阱是遍历时修改。在 do...while(pend.next(idx)) 循环体里 pend.delete(idx) 删除当前元素是安全的(索引键已经拷贝在 idx 里),但往表里插入新键是未定义行为——新键可能排在当前位置之前也可能之后,遍历可能漏访或重复。纪律:遍历期间只读或删当前项,要插入就先记到临时队列,循环结束后统一补。
第三个陷阱是把 first 当「找键为 0 的元素」。first 跟键值无关,它找的是排序意义上最小的键。键为负数的表里 first 返回的是最小负数,不是 0。
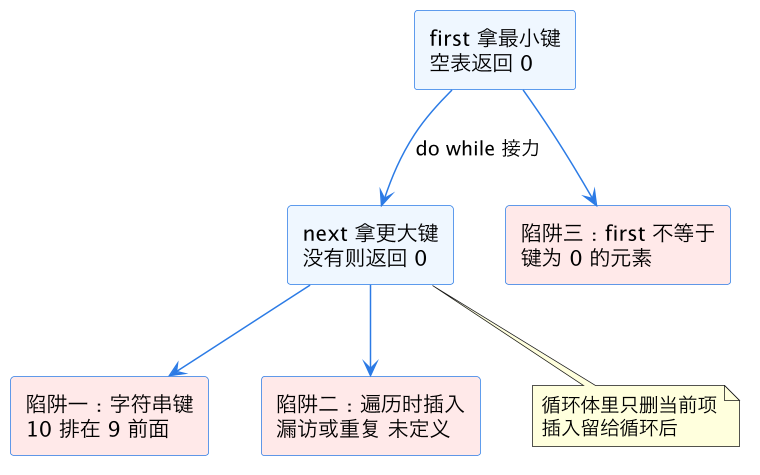
上图把遍历的接力关系和三个陷阱画在一起:左边两个蓝框是正常路径(first 起步、next 接力),右边红框是三个高频事故点。团队代码评审时拿这张图对照,能挡掉关联数组八成的使用错误。
四、delete:删一个、清全表,与内存释放的真相
delete 有两种形态:a.delete(key) 删指定键(键不存在则安静什么都不做,不报错),a.delete() 无参清空全表。两种都不返回状态。要确认删除成功,删除后自己再查 exists。
最大的认知误区是:以为 delete() 清空全表就把内存还给仿真器了。真相分两层。逻辑层面,清空后 num 归零、exists 全返回 0,这是标准保证的。物理层面,仿真器是否立即释放底层哈希表内存是实现相关的——多数仿真器只是标记元素无效,存储池留着复用。所以「每拍 delete 全表再重建」的写法在长仿真里不会内存爆炸,但也别指望它帮仿真器省内存。真正的内存治理靠 内存管理与垃圾回收 里讲的句柄生命周期控制,关联数组只是其中一环。
还有一类结构要单独说:值为类句柄的关联数组。txn_t q[id_t] 里 q.delete(id) 只删掉「键到句柄」的映射,对象本身只要还有别处引用就活着。这和 对象深拷贝与浅拷贝 讲的是同一套句柄语义——删映射不等于析构对象。
五、实战:scoreboard 在途事务表的标准写法
把前面所有方法串起来的最佳场景是 scoreboard 的在途事务(in-flight transaction)配对:DUT 请求发出时按 ID 入表,响应回来时按键取出比对,比对完删除。骨架代码:
class in_flight_sb;
  txn_t pend [id_t];           // 稀疏存储:只在途的 ID 占存储
  int   max_inflight = 64;

  function void on_request(txn_t t);
    if (pend.num() >= max_inflight)
      `uvm_error("SB", "in-flight overflow, DUT may drop responses")
    if (pend.exists(t.id))     // 规范动作:写前查冲突
      `uvm_error("SB", $sformatf("dup id %0h", t.id))
    pend[t.id] = t;
  endfunction

  function void on_response(txn_t r);
    if (!pend.exists(r.id)) begin
      `uvm_error("SB", "response with unknown id")
      return;
    end
    if (!pend[r.id].compare(r))
      `uvm_error("SB", "payload mismatch")
    pend.delete(r.id);         // 配对完成,删当前项
  endfunction

  function void check_phase();  // 遍历兜底:仿真结束不能有残留
    id_t id;
    if (pend.first(id)) begin
      do `uvm_error("SB", $sformatf("lost txn id=%0h", id));
      while (pend.next(id));
    end
  endfunction
endclass
这份骨架里每个方法都落在它该在的位置:写入前 exists 查重复 ID(对应第二节的规范动作),num 做容量门禁,delete(key) 配对后删当前项,check_phase 用 first/next 遍历兜底查丢失事务。它与 scoreboard 队列实现 形成互补:队列适合保序、先到先出的事务流(比如单通道 FIFO 类 DUT),关联数组适合乱序完成、按键配对的场景(AXI 多 outstanding、多通道 DMA)。选型判据就一条——响应顺序和请求顺序一致用队列,可能乱序用关联数组。更大的 scoreboard 结构(predictor 与 comparator 分工)见 scoreboard predictor 模型。
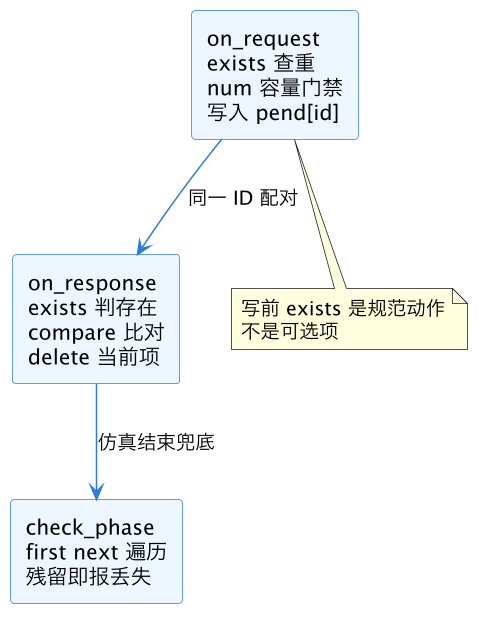
上图把三个时刻的分工画清楚了:请求侧管「进表」,响应侧管「配对出表」,check_phase 管「兜底审计」。三个环节缺一个都会漏 bug——没有 exists 查重,DUT 重发同 ID 请求检测不到;没有容量门禁,丢响应的 DUT 会让表无限涨;没有 check_phase 遍历,仿真结束时表里的残留事务(真丢的事务)就永远没人发现。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录下 SystemVerilog 语言基础线的方法专题文。向上承接 队列与关联数组方法 的结构对比总览与 数据类型 packed 与 unpacked 的内存布局基础,把「关联数组是什么」推进到「每个内建方法怎么用才对」。横向与 scoreboard 队列实现 构成选型互补(保序用队列、乱序配对用关联数组),与 内存管理与垃圾回收 在 delete 内存语义上互相印证,与 对象深拷贝与浅拷贝 共享句柄语义前提。向下,本篇的 scoreboard 骨架可直接嵌入 scoreboard predictor 模型 的 comparator 侧使用。
总结
关联数组方法的精髓是理解稀疏存储这把双刃剑:键空间巨大而物理存储只为写过的键分配,所以读前必须 exists 判存在防野读默认值,num 数的是实际元素不是容量;遍历靠 first/next 接力且顺序按键排序——整数键按数值、字符串键按字典序("10" 在 "9" 前),遍历期间只删当前项绝不插入;delete(key) 删映射不析构对象、delete() 清表不保证还内存。落到 scoreboard 实战,在途事务表的标准骨架就三招:写入前 exists 查重加 num 容量门禁、响应时 exists 加 compare 加 delete 配对、check_phase 里 first/next 遍历兜底抓丢失事务——乱序配对场景用关联数组,保序场景用队列,选型错了方法再熟也白搭。