Medusa 头与树注意力验证:多头并行草稿的 top-k 展开、验证内核与接受长度的平衡
更新时间:2026-10-06。Medusa 是投机解码家族里「把草稿头焊在主模型上」的代表路线:在主模型最后一层加 k 个并行预测头,第 i 个头预测第 t+i 个 token,一次主模型前向同时拿到多步草稿,再展开成候选树一次验证。站内 EAGLE 与 Medusa 投机头 做了两条路线的训练与接受率对比,tree attention 草稿验证内核 讲了验证内核的掩码机制,投机解码方法全景 给了选型框架。这篇聚焦 Medusa 自身的工程闭环:头怎么产草稿、top-k 怎么展开成树、验证内核怎么跑、接受长度和开销的平衡点在哪。
本文要回答的问题
- Medusa 的 k 个并行头各自看到什么输入,为什么独立预测会导致深层准确率快速衰减?
- top-k 展开成候选树时,树的宽度和深度怎么定,节点预算超支的代价是什么?
- tree attention 验证内核相对普通因果注意力改了哪三样东西?
- 接受长度与验证开销的平衡怎么定量,生产上怎么调这组参数?为什么「树越大越好」是个直觉陷阱?
一、Medusa 头的结构:一次前向,多步预测
普通语言模型只有一个输出头,从最后层 hidden state 预测下一个 token。Medusa 的做法是保留这个原始头(它继续预测 t+1),再额外挂 k 个头分别预测 t+2、t+3……t+k+1。每个头的结构很轻:一层带残差的前馈网络加一个共享的输出投影(和原头共用词表嵌入矩阵,省参数也保证分布对齐)。训练时冻结主模型,只用语言模型损失训这几个头,几张卡几天就能训完,这是 Medusa 相对 draft model 路线最大的部署优势——草稿零额外前向,权重增量不到主模型的 2%。
但并行头有一个结构性弱点:各头互相独立,谁也看不见谁的预测。预测 t+3 的头并不知道 t+2 位置会是什么 token,它只能基于「主模型到 t 为止的 hidden state」做边际分布预测。位置越深,条件信息缺口越大,准确率衰减越快——典型数字是 t+1 位置的 top-1 接受率 70% 左右,t+2 掉到 50% 上下,t+3 只剩 30% 多。这个衰减规律决定了 Medusa 的草稿不能是「一条直线往深了猜」,而必须转成「每个位置多给几个候选」的树形结构,用宽度换深度。EAGLE 正是针对这个弱点做了特征级自回归改进,接受率普遍高 10 到 20 个百分点,代价是每步多一次小计算,详细对比见 EAGLE 与 Medusa 投机头。
训练侧还有一个影响接受率的细节:头的训练数据分布要和线上解码分布一致。用预训练语料训头,头学到的是「给定真实前缀的边际分布」;而线上解码时前缀是模型自己生成的,分布有系统偏移(exposure bias)。主流做法是在头训练阶段混入一部分「主模型自己生成的前缀」,让头见过自己将要面对的真实输入分布——这一步能把深层头的接受率再抬几个点,成本只是多跑一遍主模型采样。头数 k 的选择也和训练预算挂钩:每个头都是独立训练目标,k 从 3 加到 5 训练时间近似线性涨,而第 5 个头的边际贡献通常已经很小,这也是 k 普遍停在 3 到 4 的原因之一。

上图把多头结构和衰减规律画在一起。注意黄色节点——衰减不是工程没做好,是「条件信息缺失」的数学必然,理解这一点才能理解后面所有树形设计的动机:树的作用就是把深层位置的低置信度,折算成同层多个候选里「至少一个对」的较高命中率。
二、top-k 树展开:宽度、深度与节点预算
树展开是 Medusa 工程里调参空间最大、也最容易超支的一环。Medusa 原始论文的草稿形态是笛卡尔积树:第 1 层取头 1 的 top-k1 个候选,第 2 层对第 1 层每个节点取头 2 的 top-k2 个候选作为子节点……总节点数是各层 k 的乘积,膨胀极快。k1=k2=k3=4 时三层就是 64 个节点,加第四层变 256——验证这些节点的 KV 都要占显存,注意力计算量也随节点数线性上涨,而深层节点的命中贡献越来越小。生产实现因此都不做完整笛卡尔积,而是做剪枝的预算制展开:
联合概率排序。每个候选路径的得分是沿途各头概率的乘积,按得分全局排序,只保留预算内的前 N 条路径(典型 N 在 32 到 64)。这样树的形状自动变成「头几层宽、深层只延伸到高置信分支」,把预算花在刀刃上。
深度与宽度的配比。给定预算 N,全堆宽度(一层 32 个候选)和全堆深度(一条 32 步的链)都不如混合形状,前者浪费在并列低价值候选上,后者被深层衰减拖死。经验甜点:k=3 到 4 个头、每头 top-3 到 top-5、预算 32 到 64 节点,对应平均接受长度 2.5 到 3.5 个 token。深度超过头的数量没有意义——第 k+1 层之后没有头提供预测了。
静态树模板。为了配合 CUDA Graph(图结构必须静态),vLLM 等实现把树的拓扑固定成一张静态模板:形状不再随每步的概率动态变化,而是离线按平均概率质量选好一棵固定形状的树,每步只是把各头的 top-k 填进模板对应位置。静态模板损失了一点自适应性,换来验证路径完全可 Graph 化,是工程上的标准取舍。模板本身也是可调产物——离线用一段代表流量统计「哪类树形状的平均接受长度最高」,定期重新生成,和 CUDA Graph 逐节点开销拆解 里讲的按桶备图是同一套「形状枚举加静态化」思想。

上图画出从笛卡尔积到静态模板的两级收敛。节点预算为什么是 32 到 64 而不是更大?因为验证这 N 个节点要在注意力内核里展开成 N 个查询位置,tree attention 草稿验证内核 的计算和 KV 驻留都随 N 线性涨——而第 64 名开外的路径,命中概率已经低到不值得为它付 KV 租金。预算的边际收益曲线在 32 到 64 之间明显变平,这是甜点区间的由来。
三、验证内核的三处改动
tree attention 验证和普通 decode 前向的差别集中在注意力内核,改动只有三处但每处都不能错——错了不会崩溃,只会静默地把接受率打崩或把输出分布改坏,是最难排查的一类 bug。
掩码从因果三角变成树形可达矩阵。普通因果掩码里位置 i 可见所有 j 小于等于 i 的位置;树掩码里节点 i 只可见它的祖先链——同层兄弟互不可见,不同分支的节点互不可见。掩码以位图或分块形式传入内核,FlashAttention 的分块结构要求掩码也按块对齐,块内任意节点不可见整块才能跳过,否则要逐元素判断,这是树验证内核比普通内核慢一到两成的主要原因。
位置编码按深度而非序号。树节点的位置编号必须取它在树上的深度(从根到它的路径长度),不能取展平后的数组下标——否则 RoPE 的旋转角全错,验证出来的分布和目标模型不一致,严格接受采样被 silently 破坏。
KV 布局按树展平、验证后按分支裁剪。N 个候选节点的 K/V 写入连续的临时 KV 区,验证完选定被接受的路径后,把这条路径的 KV 拷回正式 KV cache(或用块表重指),其余临时区回收。裁剪要快,因为它在 decode 关键路径上;PagedAttention 的块表机制正好可以零拷贝完成——把被接受路径占用的 block 直接挂到正式序列的块表上即可,分配层机制见 PagedAttention 与 vLLM 服务化。
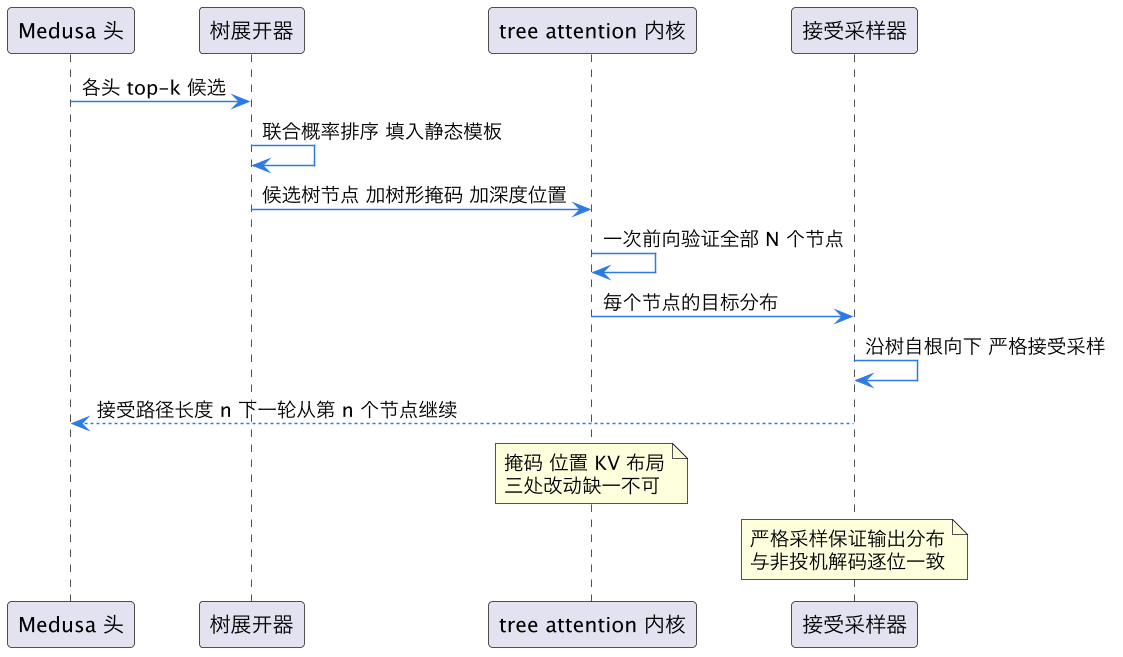
上面这张时序图把一步投机验证的完整闭环画出来了。接受采样器的工作方式值得展开:它从树根开始沿候选路径向下走,每个节点按目标模型分布做拒绝采样(公式见 接受率与接受长度),走到第一个被拒绝的节点就停,该节点的修正 token 由目标模型分布直接采样补上。这条「沿树走」的规则保证了只要草稿分布和目标分布一致就必然全接受,不一致时也有数学上严格的修正——投机解码「无损」的承诺全靠这一步守住,任何图省事的宽松接受(比如阈值放行)都会引入分布漂移。
四、接受长度与开销的平衡:生产调参方法
Medusa 配置的最终账本是:净加速比 = 平均接受长度 /(1 + 树验证开销系数)。平均接受长度随预算 N 增大但边际递减,验证开销随 N 线性涨,两者的交点就是最优预算。典型配置下的实测区间:N=32 时接受长度约 2.5、验证开销约 10%,净加速比约 2.2;N=64 时接受长度约 3.0、验证开销约 20%,净加速比反而降到 2.1 上下——预算翻倍的收益已经被开销吃掉了。这个反直觉的结果是 Medusa 调参最重要的认知:不是树越大越好,中等预算往往最优。把典型扫参结果列成表更直观(数值为 70B 级模型、4 个头、小 batch decode 的代表量级,实际以自有负载灰度实测为准):
| 节点预算 N | 平均接受长度 | 验证开销系数 | 净加速比 | 临时 KV 驻留 |
|---|---|---|---|---|
| 16 | 约 2.0 | 约 5% | 约 1.9 | 很小 |
| 32 | 约 2.5 | 约 10% | 约 2.2 | 小 |
| 48 | 约 2.8 | 约 15% | 约 2.2 | 中 |
| 64 | 约 3.0 | 约 20% | 约 2.1 | 中 |
| 128 | 约 3.3 | 约 40% | 约 1.8 | 大 挤压并发 |
表的两头都不划算:N=16 时接受长度没吃满,N=128 时开销和 KV 驻留把收益反噬。甜点稳定在 32 到 48 一带,这和第二节从命中率角度推出的预算区间互相印证。
生产上调这组参数的标准流程是四步(全部在灰度流量上做,不要用离线benchmark的数字直接上线)。第一步,在代表性流量上灰度采集各头的逐位置接受率,画出衰减曲线——曲线形状决定头数 k 的上限,第 4 个头接受率跌破 25% 就不值得挂。第二步,扫预算 N(16、32、48、64),每个点测端到端 ITL 和平均接受长度,取净加速比最大的点。第三步,按负载分流定两套配置:高重复负载(代码、模板化输出)用较大预算吃满接受长度,高熵负载(创意写作)用小预算甚至只验前两层,分流判据见 投机解码方法全景 的负载三问。第四步,纳入发版回归:主模型换权重后各头接受率会漂,要么重新蒸馏头,要么重新标定预算——头是和主干权重绑定的,这一点在多模型共存的平台上容易被漏掉。
还有两个二阶效应值得知道。其一,batch 大了以后树验证的白嫖性质会消失:验证 N 个节点的算力在小 batch 时是闲置算力,batch 上 32 以后 decode 本身接近计算受限,树验证开始和正常 decode 抢算力,此时要调小 N 或对大 batch 请求关投机,量化分析见 batch 与延迟吞吐曲线。其二,树验证和 KV cache 显存的争抢:N 个节点的临时 KV 在长上下文服务里不是小数目,显存紧张时它会挤压可并发请求数,验收指标要用端到端 goodput 而不是单请求延迟。如果模型自带 MTP 头(DeepSeek-V3 系),整条 Medusa 链路可以换成出厂自带版本,见 MTP 多 token 预测。
这一篇在知识体系里的位置
本篇是投机解码专题里 Medusa 路线的工程闭环篇:训练与路线对比在 EAGLE 与 Medusa 投机头,验证内核的掩码与 KV 细节在 tree attention 草稿验证内核,指标口径在 接受率与接受长度,选型与负载分流在 投机解码方法全景,零训练替代路线在 prompt lookup 解码。
总结
本篇全部讨论可浓缩为下面这一段。Medusa 在主模型上挂 k 个并行头实现零额外前向的多步草稿,但独立预测导致深层接受率快速衰减,所以草稿必须经 top-k 联合概率排序展开成预算制候选树(甜点 32 到 64 节点、3 到 4 层),再用固定形状的静态树模板配合 CUDA Graph;tree attention 验证内核只改三处——树形掩码、按深度的位置编码、按树展平可裁剪的 KV 布局——配合沿树的严格接受采样保证输出无损;调参的核心认知是树不是越大越好,预算翻倍的接受长度收益会被线性上涨的验证开销吃掉,生产上按「灰度测衰减曲线、扫预算取净加速比最大点、按负载分流两套配置、发版回归重标定」四步落地。