高层综合 HLS:用 C++ 描述算法,让工具去找微结构(B5)
HLS 概念与 FPGA 侧实践见 HLS 入门、HLS 优化、HLS 深入、HLS vs 手写 RTL;本篇讲工具内部机制与工程边界:Siemens Catapult、AMD Vitis HLS(前 Xilinx Vivado HLS)、Synopsys Synphony 怎样把 C++/SystemC 变成 RTL,以及什么该用 HLS、什么不该。
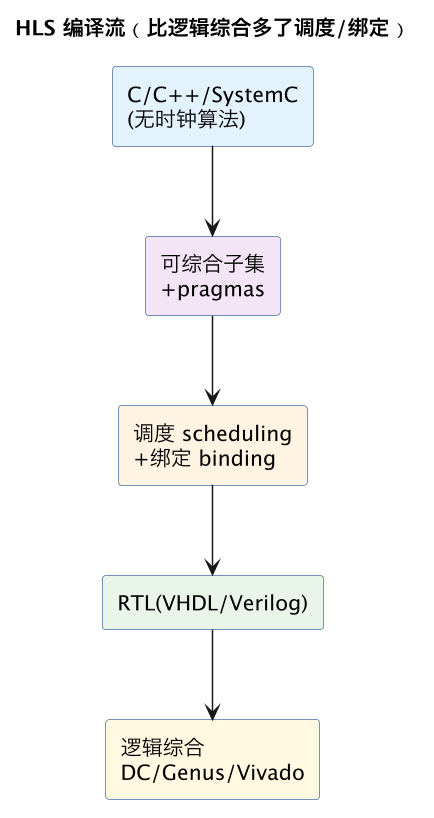
一、HLS 在综合栈里的位置
普通逻辑综合(C1 DC/Genus)输入是已经有时钟、复位、逐拍行为的 RTL;HLS 的输入是无时钟的顺序算法(C/C++/SystemC),由工具额外决定两件大事:
- 调度(scheduling):把每条操作(加/乘/访存/访存数组)安排到哪个时钟周期;
- 绑定(binding):这些操作映射到哪些硬件资源(几个乘法器、几个加法器、几块 RAM),哪些操作复用同一单元。
也就是说,HLS 把微架构(pipeline 深度、并行度、资源复用、I/O 协议)也交给工具搜索,人用 pragma/directive 在「延迟—吞吐—面积」空间里引导。
二、三个最关键的优化旋钮
| pragma(Vitis / Catapult 叫法) | 作用 | 换来/代价 |
|---|---|---|
PIPELINE(Catapult pipeline) | 允许新的迭代每隔 II 个周期进入,不必等上一轮跑完 | 吞吐↑,II(Initiation Interval)越小越快;增资源 |
UNROLL(unroll) | 把循环每次迭代展开成并行硬件 | 并行度↑、面积↑(可能复制运算与访存端口) |
ARRAY_PARTITION(split/partition) | 把数组/RAM 切成多块增加访问端口 | 解除访存瓶颈,让流水线 II 降下来;增 RAM/寄存器 |
INLINE/DATAFLOW(STREAM) | 函数内联 / 任务级流水线 | 减少握手开销、跨函数流水分发 |
核心矛盾通常不是算力而是访存:算法里一个数组默认综合成一块双端口 RAM,循环若每拍要读多个元素,RAM 端口数(II 瓶颈)就卡住流水线。ARRAY_PARTITION/RESHAPE 把数组拆成多 bank 提供多端口,是 HLS 调优里最常见的操作(与 存储 banking 同源思想)。
三、接口综合:函数边界如何变成硬件端口
C++ 函数参数没有协议概念,HLS 用 directive 决定每个参数综合成什么:
- 块级协议(block-level I/O):
ap_ctrl_none(无握手)/ap_ctrl_hs(start/done/idle 握手); - 端口协议(port-level):标量综合成
ap_none/ap_vld/ap_ack/ap_hs(valid/ready);数组默认成 AXI4 内存映射主端口(m_axi,配 burst 长度/位宽)或流式axis(AXI-Stream,FIFO 式); - 还可生成标准 AXI4-Lite 从口暴露寄存器做控制(AXI 协议、valid-ready)。
接口综合直接决定 HLS IP 能否接进 SoC(连 DMA、NoC、CPU),选错协议会让工具内部很快、数据却喂不进来。
四、延迟、吞吐与 II:看对报告
HLS 综合报告给每个循环/函数的:
- Latency(延迟):一次调用从进来到出结果多少周期;
- II(Initiation Interval):两次调用最少间隔——吞吐由 II 决定,不是 latency;
- 资源估计:LUT/FF/BRAM/DSP(FPGA)或面积/时序(ASIC 再交给逻辑综合)。
PIPELINE II=1 是常见目标:每周期吞一组新数据。达成不了时报告给出瓶颈(依赖、访存端口、递归环路),这正是要靠 partition/unroll 解的。注意延迟隐藏在流水里:吞吐高不代表单次延迟低,延迟/吞吐/流水概念要先厘清。
五、可综合子集:不是所有 C++ 都能上硬件
HLS 只接受可综合子集:
- 支持:定宽整数(
ap_int/ac_int)、数组、受限循环(界可定)、部分template、固定形式的switch; - 受限/不支持:动态内存
malloc/new、std::vector等运行期分配、操作系统调用、文件 I/O、无界递归、动态多态——这些只能在 testbench 侧(仿真)用; - 指针别名、全局可变状态会让工具保守,影响调度质量;
- 浮点可综合但极耗资源,通常用定宽定点(
ap_fixed/ac_fixed)替换。
工程上同一套 C++ 同时作黄金参考(软件编译跑功能)和综合输入,并用 C/RTL co-simulation 验证生成的 RTL 与 C 行为一致(协同验证概念见 A5 混合协同)。
六、为什么 HLS 不能替代手写 RTL
HLS 的强项是计算密集、规则、数据并行、算法迭代快的块:视频/图像 pipeline、DSP、无线、AI 算子、加密/纠错数据面。它的弱项是:
- 精细控制与时序敏感逻辑:时钟/复位/低功耗控制、跨时钟域(CDC)、自定义 I/O 接口、PHY 周边——工具无法可靠表达亚拍级意图;
- 极致面积/功耗/频率:手写 RTL 的老模块往往比 HLS 结果更省、更快、更可预测;
- 强共享/复杂握手/不规则控制:HLS 调度容易过度复制资源,QoR 不稳定。
因此成熟团队把 HLS 当生产力工具用在算法数据面(快速探索、快速随算法版本重出 RTL),控制面、I/O、关键库仍用手写 RTL,再经标准接口集成;生成的 RTL 一样要过 lint(B1)、CDC、LEC(B4)(C vs RTL 可做形式等价)与正常后端流程,不是「绕过签核」的捷径。
七、Catapult vs Vitis HLS 的取向
- Vitis HLS 深度绑定 AMD/Xilinx FPGA,生态示例多、
m_axi/axis出 IP 接 Vivado 方便,适合 FPGA 原型与加速器; - Catapult 偏 ASIC 与高端,SystemC/ANSI C++、
ac_int/ac_fixed,支持更强的接口/协议库、功率与面积探索、与综合/形式链路结合更紧,多 FPGA 厂也可对接; - 选型看目标是 FPGA 加速还是 ASIC 数据面 IP,以及团队既有 C++ 模型资产。
相关与延伸
- 前置/对照:C1 逻辑综合、A5 混合协同仿真、B1 Lint、B4 LEC。
- FPGA 侧:HLS 入门、优化、深入、HLS vs RTL。
- 选型方法论:G4 EDA 工具选型。
总结
HLS 与普通逻辑综合的本质区别是它把无时钟的 C++/SystemC 算法连同微架构一起交给工具:先做调度决定每条操作落在哪个周期、再做绑定决定复用几个乘加器和几块 RAM,人用 PIPELINE 控 II、UNROLL 提并行、ARRAY_PARTITION 拆 bank 解访存端口瓶颈,并用 block-level 握手与 m_axi/axis/AXI-Lite 接口综合把函数边界变成可接进 SoC 的硬件端口,调优时要看 II(吞吐)而非只看 latency;但它只接受定宽类型、有界循环、无动态内存的可综合子集,同一 C++ 兼作黄金参考并经 C/RTL 协同仿真与形式等价,只在规则、数据并行、算法迭代快的数据面(DSP/视频/AI/编解码)体现生产力优势,而时钟复位、CDC、定制接口与极致面积频率的控制面仍需手写 RTL,且生成结果一样要过 lint、CDC、LEC 和完整后端签核——HLS 是放大器,不是绕过工程纪律的捷径。