uvm_sequence 和 uvm_sequence_item 区别:一个管发牌,一个是牌
刚学 UVM 的人十有八九会问这个问题:写激励的时候一会儿 uvm_sequence,一会儿 uvm_sequence_item,名字里都有 sequence,到底谁是谁?这一对概念分不清,后面 sequence、driver、scoreboard 的完整链路 就全是糊的。本文用最短路径把两者的边界划清。
本文要回答的问题
- uvm_sequence 和 uvm_sequence_item 各自是什么角色?
- 为什么激励要拆成「流程」和「数据」两层,合起来写行不行?
- 两者在 sequencer → driver 链路上是怎么交接的?
- 初学者最容易踩的误区有哪些?
一句话结论
uvm_sequence_item 是一笔事务的数据载体(牌),uvm_sequence 是产生、随机化并发送一批 sequence_item 的流程代码(发牌的人)。 sequence 本身不是 component、不占层次结构,它运行在 sequencer 上,通过 start_item() / finish_item() 把 item 一笔一笔递给 driver。
三条理由把边界钉死
理由一:类继承与角色完全不同
uvm_sequence_item 继承自 uvm_transaction(再往上是 uvm_object),它的职责是描述一笔总线事务长什么样:地址、数据、读写方向、校验位,加上 do_print / do_compare 这类字段自动化钩子。它是纯数据,没有行为。
uvm_sequence 也继承自 uvm_object,但它的核心是一个 body() 任务——一段可以跑仿真时间、可以循环、可以条件分支的过程代码。它的职责是决定下一笔发什么:先发 10 笔写、再发 10 笔读、中间插一笔边界地址。
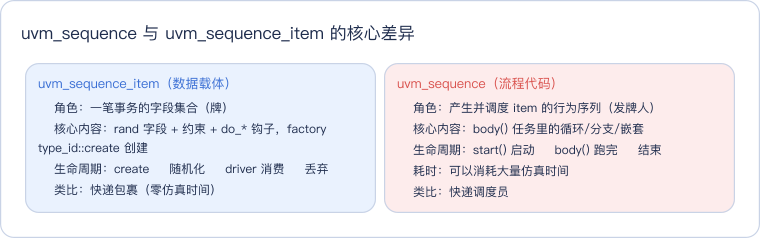
读这张对比卡抓一条主线:左边回答「这笔事务是什么」,右边回答「下一笔发什么、怎么发」。字段归 item 管,时序与策略归 sequence 管,两边都不越界。
理由二:消耗仿真时间的是 sequence,不是 item
这是区分两者最硬的技术判据。item 的创建、随机化、字段填充都发生在零时间——它们是软件对象的操作,不等时钟、不做延时。真正让仿真时间往前走的是 sequence 的 body():等 driver 取走上一笔(finish_item 阻塞)、`uvm_do 宏内部隐含的握手、乃至 sequence 里显式的延时语句。
换句话说,波形上能看到的时间结构,全部来自 sequence 的调度决策;item 只是被调度时顺便带过去的数据快照。调试时如果想改激励节奏(间隔、突发长度),去改 sequence;如果想改事务内容(地址范围、数据模式),去改 item 的约束。改错了地方是新手最常见的无效劳动。
理由三:复用维度不同
item 的复用靠继承扩展字段:基础 transaction 派生出带错误注入的 err_transaction。sequence 的复用靠组合嵌套:一个 sequence 的 body() 里可以 `uvm_do 另一个 sequence,层层叠出 分层 sequence(layered sequence) 乃至 virtual sequence。两种复用机制分别长在两个类上,也是因为它们管的事情不同。
把三个理由压成一张速查表,写代码前对照一眼就不容易越界:
| 维度 | uvm_sequence_item | uvm_sequence |
|---|---|---|
| 回答的问题 | 这笔事务是什么 | 下一笔发什么、怎么发 |
| 继承自 | uvm_transaction → uvm_object | uvm_sequence_base → uvm_object |
| 是否耗仿真时间 | 否(零时间) | 是(body() 可长时间运行) |
| 关键成员 | rand 字段、constraint、do_* 钩子 | body()、start_item/finish_item |
| 复用方式 | 类继承扩字段 | 嵌套调用、virtual sequence |
| 与谁直接握手 | driver(经 sequencer 中转) | sequencer(start 挂载) |
它们在激励链路上的位置
把眼光放大到完整链路:sequence 坐在 sequencer 上跑,item 沿着「sequence → sequencer → driver」这条路被递下去,driver 把 item 翻译成 wiggle 信号。
这张图看清两点:sequence 和 item 在图上根本不在同一层——sequence 在策略层,item 是它产出的、向右流动的数据包;sequencer 只做仲裁转发(多 sequence 竞争时的优先级见 sequencer 仲裁机制),真正的协议时序由 driver 与 sequence_item 的握手流程 完成。
一个最小例子
// 牌:一笔读事务长什么样
class rd_txn extends uvm_sequence_item;
  rand bit [31:0] addr;
  rand int unsigned len;
  constraint c_len { len inside {[1:16]}; }
  `uvm_object_utils(rd_txn)
  function new(string name = "rd_txn");
    super.new(name);
  endfunction
endclass

// 发牌人:连发 8 笔,地址步进
class rd_burst_seq extends uvm_sequence #(rd_txn);
  `uvm_object_utils(rd_burst_seq)
  task body();
    rd_txn tr;
    repeat (8) begin
      tr = rd_txn::type_id::create("tr");
      start_item(tr);
      if (!tr.randomize()) `uvm_fatal("RND", "randomize failed")
      finish_item(tr);   // 阻塞到 driver item_done
    end
  endtask
endclass
注意 body() 里 item 是每轮循环新建一个:8 笔事务 = 8 个 item 对象,但 sequence 只有 1 个。这个「1 个 sequence 产出 N 个 item」的配比,正是两者关系最直观的写照。启动方式也很说明问题——item 从不「启动」,它只是被 create;sequence 才需要 rd_burst_seq.start(m_sequencer) 挂到 sequencer 上跑起来。字段基础写法详见 uvm_sequence_item 入门。
再补一个容易忽略的细节:uvm_sequence #(rd_txn) 的参数化类型只是声明这个 sequence 主要收发哪种 item,并不限制它产生别的类型——一个 sequence 完全可以先 start_item 一笔读事务、再发一笔写事务,只要目标 sequencer 的参数类型兼容。这进一步说明 sequence 是「策略」而非「数据容器」。
一张脑图收拢全部关系
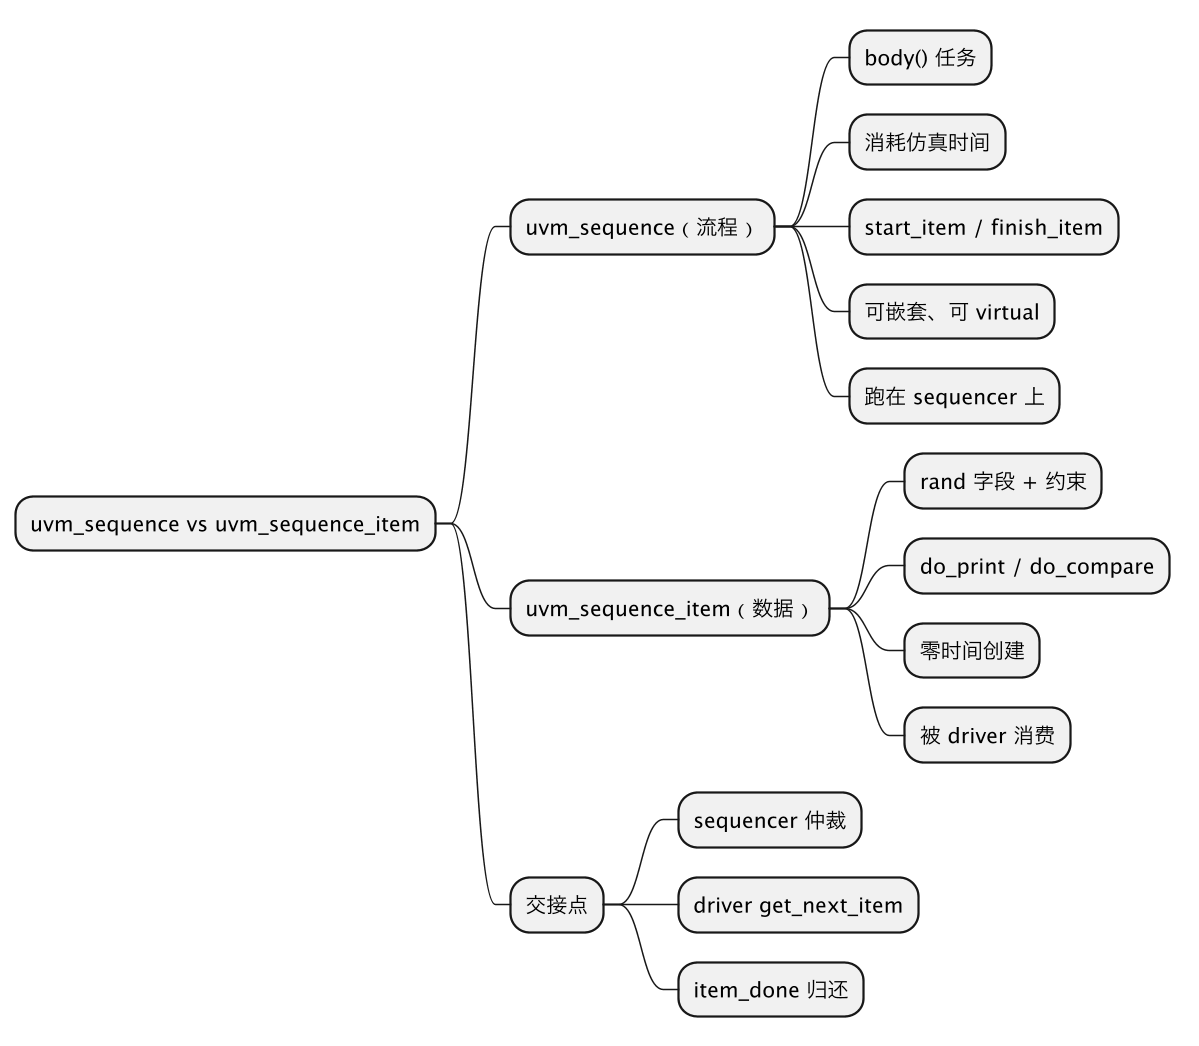
脑图从左到右就是一条记忆路径:先记住「流程 vs 数据」的根分歧,再往下挂各自的特征叶子,最后在「交接点」汇合——两者所有的交集都发生在 sequencer 和 driver 的握手那几行代码里。
常见误区
误区一:把激励逻辑写进 item。 在 item 里塞「上一笔完成后延时 5 拍再发」之类行为是典型越界——item 没有任务、不该消耗时间,时序策略一律放 sequence 的 body()。
误区二:一个 item 复用到底。 全程只 create 一次 item、循环里反复 randomize,看似省对象,实际上 driver 可能还持有上一笔的句柄(比如做响应返回),复用对象会造成数据被覆盖。标准做法就是上面例子的每轮新建,对象语义见 clone 与 create 的区别。
误区三:以为 sequence 是组件、要 build_phase 例化。 sequence 是 object 不是 component,不在 uvm_component 树里,没有 phase;它靠 seq.start(sequencer) 动态启动,这也是为什么它能被 test 在运行时灵活替换。
误区四:混淆 sequence 与 sequencer。 名字更像的其实是这一对——sequence 是激励脚本,sequencer 是转发管道,sequence 必须挂在某个 sequencer 上才能把 item 送出去。sequencer 自己一笔事务也不产生,它只负责在多组 sequence 竞争时做仲裁、把 item 安全地递到 driver 手上。
误区五:在 item 的 constraint 里写跨事务的先后关系。 「第 5 笔必须是读后写」这类依赖属于时序策略,item 的约束只能约束单笔事务内部的字段取值,跨笔关系必须放到 sequence 的 body() 里用循环计数、状态变量或嵌套子 sequence 来表达。约束解决不了的问题硬塞进 constraint,最后只会得到随机失败且报错莫名其妙的激励。
误区六:以为 item 必须经 factory 覆盖才有意义,直接 new 更省事。 直接 new() 确实能跑,但等于放弃了 UVM 的类型覆盖机制——test 里一句 set_type_override_by_type 把基础 item 换成错误注入派生类的前提,就是所有对象都走 type_id::create 创建。sequence 里 new 出来的 item 不受 factory 管,覆盖对它无效,错误注入激励发不出来时往往查半天才发现是创建方式不对。
一个时序小账:时间到底花在谁身上
以上面的 rd_burst_seq 为例,假设 driver 消费一笔 item 要驱动 4 拍总线时序(时钟 10ns)。8 笔事务跑完,仿真时间前进了约 8 × 40ns = 320ns——这 320ns 全部花在 finish_item(tr) 阻塞等待 driver 归还 item_done 上,也就是 sequence 的 body() 里。而 8 次 create 加 randomize 是纯软件操作,耗时为零,在波形上不占一格。想在波形上拉开两笔事务的间隔,去 body() 里加延时;想让地址落在某个区间,去改 item 的 constraint——时间归 sequence、内容归 item,这个分工在调试激励时是最实用的定位口诀。
这一篇在知识体系里的位置
本文是 UVM 激励建模链条上的概念辨析篇。向上,testbench 整体骨架见 UVM 测试平台架构入门;向下,item 字段怎么写见 uvm_sequence_item 入门,多 agent 协调见 virtual sequence 的启动方式,sequence 与 driver 的完整握手见 driver-sequence-item 数据流。
一句话总结
uvm_sequence_item 是被传输的数据(一笔事务长什么样),uvm_sequence 是产生并调度这些数据的流程(下一笔发什么、什么时候发);分清「牌」与「发牌人」,sequence/sequencer/driver 整条链路就顺了。