FPGA 专家 02:Aurora 与高速串行协议——轻量点对点链路
本文是
fpga/专家层第 05 篇。物理层基础见收发器深水区;Aurora 的典型大舞台是专家层多 FPGA 原型系统(见 02 多 FPGA 原型系统 ASIC 分区/TDM)。
本文要回答的问题
- Aurora 是什么、和 PCIe/以太网差在哪?
- 链路初始化与就绪状态怎么看?
- 流控、帧/流模式、多 lane 怎么处理?
- 多板互联的时钟/拓扑怎么设计?
一、协议定位
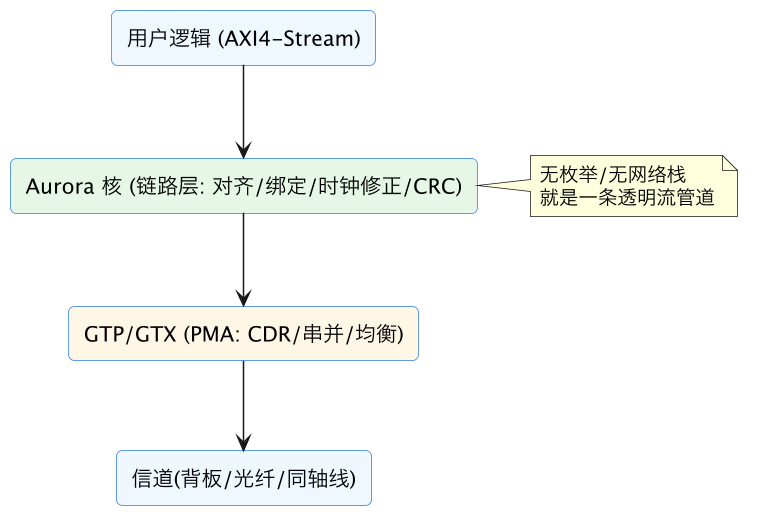
| 协议 | 开销 | 语义 | 适用 |
|---|---|---|---|
| Aurora | 小、延迟亚微秒 | 透明流(帧可选) | FPGA 间点对点、背板 |
| PCIe | 中(核+DMA) | 内存读写、枚举 | 接主机 |
| 以太网 | 大(MAC+协议栈) | 帧、可交换路由 | 网络 |
二、用户接口
- 发送:
s_axi_tx_tdata/tvalid/tready/tlast(帧模式 tlast 定帧界,流模式不用); - 接收:
m_axi_rx_tdata/...; - 状态:
channel_up(链路就绪)、lane_up、hard_err/soft_err; - 时钟:
init_clk(初始化)、user_clk(用户接口时钟,由核从线速率分频给出); - 流控:帧模式可用 NFC 暂停;否则用户用 FIFO 水位/信用反压。
三、初始化状态机
1. 收发器复位/PLL 锁定
2. CDR 锁定、块/字节对齐(K 字符/block lock)
3. 多 lane: 通道绑定(align 字符)去偏斜
4. 时钟修正: 弹性缓冲插删补偿字符, 消化参考钟频差
5. channel_up 拉高 → 可收发
hard_err: 信号丢失/锁定失败; soft_err: 偶发误码 → 看眼图/误码率
四、多板互联工程要点
- 参考钟:独立参考钟即可(≤±300ppm,靠时钟修正消化);多 lane 绑定建议同源;
- lane 映射:板级交叉可在核内做 lane 极性翻转/顺序映射;
- 调试:近端 PMA 回环→远端回环→真实链路,逐级验证(见收发器篇);
- 拓扑:直连点对点;多芯片用星形/环形/交换 IP;
- JTAG 隧道:Aurora 传 JTAG 信号,实现一块下载器访问背板多片 FPGA(原型平台常用);
- 物理层:100Ω 差分、AC 耦合、SI/PI 按板级 SI。
五、帧模式与流模式:定界、吞吐与延迟的取舍
使用 Aurora 第一个真正要做的设计决策是帧模式还是流模式,这决定了上层看到的数据语义。帧模式(framing,AXI4-Stream with tkeep/tlast):用 tlast(和 tkeep)标出报文边界,核在链路上插入帧头帧尾控制字符,接收端还原边界;它还支持原生流控 NFC(native flow control),允许接收侧通过带内字符请求发送侧暂停。帧模式适合天然有包概念的数据——网络报文、DMA 描述符、带事务边界的命令响应。代价是帧控制字符占一点开销、链路层为组帧带来少量延迟,以及对 tvalid/tready 握手时序要按 AXI-Stream 规则正确实现(tvalid 置起后在握手完成前不允许撤销,这是最常见的协议级 bug)。流模式(streaming):无边界,就是连续的字节/字流,延迟最低、逻辑最简单,适合恒定码率的采样流、或上层自己已有成帧机制(比如内部总线协议已经带长度和定界)的场景;代价是核不能替你保留边界,接收端必须持续取数,且无内建流控。
吞吐和延迟要分开算账。吞吐受三因素限制:线速率乘 8b/10b(0.8)或 64b/66b(约 0.97)编码效率、控制/时钟修正字符的少量占用、以及用户接口不能持续握手造成的气泡。很多实测吞吐上不去不是链路问题,而是用户逻辑 tvalid/tready 出现气泡——多 lane 高速时一个 user_clk 周期对应几十字节,一次反压停顿的损失很大。延迟方面,Aurora 核内部有发送缓冲、串行化、接收弹性缓冲等流水,端到端物理延迟通常在几十到一两百纳秒量级(取决于配置和缓冲深度),配成低延迟/浅缓冲可以更小但牺牲容忍抖动能力;这比 PCIe(事务层、交换、重传)和以太网(MAC、帧间间隙、可能的交换)低一个数量级,正是低延迟板间互联选它的原因(低延迟系统设计见 专家 35)。设计时应把“平均吞吐要多少、突发多大、可接受最大延迟多少、是否需要报文边界”四个问题先回答,再选模式和 FIFO 深度,而不是默认勾选。
六、流控深论:Aurora 不替你保证不丢数
这是最容易产生生产事故的一点:Aurora 保证链路可靠传输,但不提供端到端流控(帧模式 NFC 只是局部暂停机制,不解决下游消费能力问题)。核的 tready 反映的是核内发送缓冲和链路是否可接收,它不知道对端应用层多久取一次数。如果对端应用来不及消费,接收缓冲会填满,之后到的数据要么被丢弃要么触发错误,链路本身仍是 up 的——于是出现“链路正常但数据莫名缺失”的隐蔽故障。工程上有三种处理层次。第一层,缓冲吸收:接收侧放足够深的 FIFO/帧缓冲,按业务允许的最大突发深度设计;简单但只推迟问题,长期生产快于消费必溢。第二层,NFC 暂停(仅帧模式):接收侧在 FIFO 高水位时通过 NFC 字符通知发送侧暂停,发送侧核自动停发;它工作在链路两端的 Aurora 核之间,延迟和暂停粒度受链路往返限制,适合对端只是短暂来不及处理的场景。
第三层,端到端信用/水位协议:在 Aurora 之上自建轻量流控——接收侧周期性把可用 FIFO 空间(credit)经反向链路发回,发送侧维护信用计数器,“发多少数据必须先有多少信用”,信用到零立即停发。这是唯一能正确处理多级下游拥塞(Aurora 接收端后面还挂着 DDR、PCIe、另一条链路)的方案,多 FPGA 原型和背板系统普遍这么做(端到端流控与避免循环依赖的设计见 专家 43)。设计信用协议时必须避免 专题 08 案例七那种循环等待:信用返回路径不能经过一个可能被本链路数据填满的队列。还要处理链路断开/重连时信用和缓冲的复位——channel_down 时所有在途数据作废,两端 FIFO、信用、序号必须一起重置,不能只重置其中一端。把“链路 up 但数据丢了”作为必须检测的故障:在应用层加序号和(对高可靠场景)CRC/重传,Aurora soft error 计数只反映误码,不反映应用层溢出。
七、多 lane 与多板拓扑:绑定、去偏斜与参考钟策略
当单条链路带宽不够,Aurora 支持把同一对收发器 Quad(或按核规则布局)内的多个 lane 绑定成一条更宽的逻辑链路。绑定后用户看到的是位宽成倍的单条 AXI-Stream,核在内部完成 lane 间对齐和去偏斜:发送端在各 lane 上同时发出对齐序列,接收端测量各 lane 的比特/字偏移,用每 lane 的独立缓冲把它们拉到同一节拍释放。工程约束有几个硬点:第一,物理布局,绑定 lane 必须在核支持的范围内(通常同 Quad,跨 Quad 需特定时钟路由),随意分配引脚会让绑定失败或被迫绕行;第二,参考钟最好同源,虽然独立参考钟在容差内可工作(时钟修正兜底),但绑定去偏斜对 lane 间频率差更敏感,同源能显著扩大可靠范围;第三,lane 映射与极性,PCB 交叉布线时在核配置里做 lane 顺序翻转和逐 lane 极性翻转,不必为此改板;第四,偏斜预算,lane 间 PCB 长度差应控制在核允许的去偏斜范围内(数据手册给 UI 或毫米数),超长差需要更深缓冲或等长约束。
多板拓扑上,Aurora 是严格的点对点协议,本身没有交换和寻址,多 FPGA 互联要自己组织拓扑。星形:一个中心 FPGA 用多条链路连所有节点,中心承担全部交换逻辑和收发器数量,延迟低、无环,但中心是单点且端口数受限。链形/环形:节点串接,数据逐跳转发,省收发器但延迟随跳数增长,环还要处理双口访问和断链。Mesh/交叉开关:节点间多链路互联,配自研或商用的 switch IP 做路由,扩展性最好、复杂度最高,大型多 FPGA 原型系统(见 02 多 FPGA 原型系统 ASIC 分区/TDM、12 多 FPGA 分区算法 割集/容量/图划分)采用。拓扑选择本质是在收发器数量、板卡端口、延迟、布线复杂度、单点风险之间做交换,且要在背板设计阶段定死——收发器引脚和参考钟分发一旦投板无法更改。背板物理设计延续 专家 42 的要求:差分 100Ω、AC 耦合电容位置、连接器插损、参考钟分发树和供电都要按目标速率做裕量预算。
八、初始化与 bring-up:channel_up 不拉高的完整决策树
Aurora bring-up 的核心指标是 channel_up(有的版本叫 channel_ready),它不拉高或频繁闪烁时,按下述决策树定位能覆盖绝大多数情况。第一层,物理层前提:MGTREFCLK 频率正确、接到正确的专用引脚、对应 Quad 供电正常且去耦到位(见 专家 04 第八节);看收发器 PLL lock,不锁就停在这里查时钟和电源,与 Aurora 逻辑无关。第二层,复位序列:核复位与收发器复位必须按手册顺序(一般是等参考钟稳定→复位收发器→等 lock→复位核),用厂商 example design 的初始化模块而不是自己拉 reset;很多“偶发起不来”是复位释放时刻 PLL 未稳或复位没跨域。第三层,速率与编码一致:两端线速率、参考钟频率、8b/10b 或 64b/66b 选择、lane 数、用户数据宽度必须逐项一致,任何一项不同都可能 lock 但不 up。第四层,物理连接:用近端 PMA 回环验证本地核(自发自收 channel_up 且自测数据正确),再远端回环验证信道+对端物理层,最后去回环跑真链路——这一步把“本地问题”和“对端/信道问题”彻底分开。
第五层,对齐与绑定:单 lane 看字节/块锁定(K 字符检测、block lock 状态);多 lane 额外看通道绑定/去偏斜状态,绑定不起查 lane 映射、参考钟是否同源、PCB 偏斜是否超范围。第六层,时钟修正:参考钟频差超出 ±300ppm(或所选编码/配置的规格)、时钟修正序列配置错误、用户长时间不让出可插修正字符的间隙,都会让弹性缓冲溢出/下溢而无法稳定 up。学会读 hard error 与 soft error 的区别:hard error 是锁定失败、信号丢失类硬故障(配置、时钟、物理层),soft error 是偶发 CRC/字符错误(眼窗裕量、均衡、参考钟相噪)——前者恒定、后者随温压出现,定位手段完全不同。把整条初始化链的状态信号(lock、resetdone、block_lock、align、bond、clock_correction、channel_up、错误计数)全部接进可读寄存器(见 专家 45),bring-up 时就不必反复改 RTL 加探针。
九、JTAG-over-Aurora 与带外管理:把背板变成一个调试域
Aurora 在多 FPGA 原型/背板系统里有一个高价值用法:隧道化 JTAG(JTAG-over-serial/Aurora),让一台下载器经一个入口 FPGA 访问背板上所有 FPGA。传统做法每片 FPGA 都要 JTAG 线或人工切换下载器,背板规模一大就无法维护;隧道方案把 TCK/TMS/TDI/TDO 四个 JTAG 信号(配合各片的 TAP 链选择)打包成低速 Aurora 消息,经已有的高速链路或独立的低速管理链路转发到目标板,目标板上的小核把消息还原成本地 JTAG 时序。由于 JTAG 本身是同步串行且对实时性要求不高,Aurora 的延迟和缓冲完全够用,但要注意 TCK 由隧道消息合成、不是连续自由时钟,边界扫描和某些对 TCK 周期敏感的操作要确认工具链支持这种远程网关。
除了 JTAG,这条管理通道还应承载带外管理信息,形成背板的“控制平面”:各板的 BIST 结果、链路状态、温度电压、比特流版本(见 20 比特流烧录与四方版本一致 manifest/门禁)、远程复位和重配命令。设计上把它与业务数据平面隔离——管理通道独立于业务链路(或共享链路但用独立虚通道和固定信用),保证业务面挂死时管理面仍可达,这与 专家 45 讲的“不依赖业务面健康的带外通道”是同一原则。多片 JTAG 链还要规划 TAP 拓扑(菊花链或逐片使能)和地址映射,使主机软件能用“槽位号+器件号”定位任意目标。一个成熟的原型背板,工程师应当能坐在工位上完成:枚举机箱内所有 FPGA、读版本和状态、给任意一片重配比特流、对任意一片下发 JTAG 调试会话,而不必插拔线缆——这是把多板系统从“实验装置”变成“可运维平台”的关键一步。
十、选型决策与工程清单:什么时候不该用 Aurora
最后给一个清醒的选型判据。Aurora 的价值主张是“轻、快、简单的点对点透明管道”,因此它最适合:板间/背板的大量数据搬运、多 FPGA 原型互联、FPGA 与采集/显示设备的直连、需要亚微秒级延迟且无需交换的场景。但有三类场景不应选它。需要接主机/操作系统时用 PCIe:当 FPGA 是 CPU 的外设、需要被枚举成设备、走标准 DMA 和内存语义、需要热插拔和电源管理,Aurora 没有这些层,强行自研枚举和驱动是重复造 PCIe 的轮子(见 专家 07)。需要组网/交换/长距离时用以太网:多对多、跨机架、走现有网络设施、需要 IP/TCP 生态和互通时,Aurora 的点对点拓扑是硬限制(见 专题 01)。需要标准化互通时也不要用:Aurora 是厂商生态协议,跨厂商器件互通支持有限,产品若要求与第三方设备对接,应选开放标准。
一份落地检查清单:速率/lane 数/编码/宽度两端一致;参考钟引脚、Quad 布局、绑定规则在引脚规划阶段确认;差分 100Ω、AC 耦合、连接器插损、板材按速率做裕量预算(引用 专家 42);复位采用官方初始化模块并逐级等待 lock/ready;近端 PMA→远端→真链路三级回环验证;channel_up 及全部锁定/错误状态入寄存器;帧/流模式按“边界、吞吐、延迟”三问选定;流控按缓冲→NFC→端到端信用的层次针对真实拥塞设计,并排除循环依赖;链路断开时两端缓冲/信用/序号同步复位;均衡参数在温压矩阵下选鲁棒点并版本化;管理面(JTAG 隧道、版本、BIST、远程重配)与业务面隔离。逐条过一遍,Aurora 链路就能从“能点亮”走到“在机箱里长期可靠、出问题可远程定位”。
十一、Aurora 64B/66B 版本:什么时候该从 8B/10B 升级
Aurora 有两个主要变体,选错会同时损失带宽和可靠性。Aurora 8B/10B 结构简单、字节级对齐、支持 NFC,单 lane 线速率通常在较低区间,带宽效率固定为 80%;它适合控制通道、中低带宽数据搬运、以及希望链路行为直观易调试的场合。Aurora 64B/66B 用加扰和 2bit 同步头,效率约 97%,支持更高速率和更宽接口,适合大吞吐数据面;代价是块锁定状态机更复杂、加扰使链路上看不到简单字节图案(调试时不能直接在串行数据里搜 K 字符),时钟修正和流控机制也相应变化。升级判据算一笔账:一条 10Gbps lane,8B/10B 净荷 8Gbps,64B/66B 净荷 9.7Gbps,差 21%;当系统带宽恰好卡在中间、或 lane 数受引脚/收发器数量限制时,换编码可能省掉一条 lane,直接降低成本和面积。
但升级不是无代价的。第一,两端必须同时升级,两种变体不互通;第二,64B/66B 的 block lock 行为、加扰种子复位、时钟修正序列都要在初始化状态机里重新验证,bring-up 时对状态码的解读不同;第三,调试可见性下降,需要更多依赖核内状态寄存器和用户侧序号检查,而不是在示波器上找逗号。对多 lane 大带宽骨干,还应关注 lane 内加扰的相关性——不同 lane 用独立加扰可避免同步开关噪声和 EMI 尖峰。一个务实策略:背板/板间大带宽数据面用 64B/66B,独立保留一条低速 8B/10B 或其它链路作为带外管理面(第九节),这样既拿到效率,又保留一条行为简单、在数据面故障时仍可依赖的通道。把数据面和管理面按不同编码/速率分级,是大型背板常见的工程妥协。
十二、可靠性设计:掉线检测、重连行为与数据一致性
把 Aurora 用于产品而不是 demo,必须把“链路会断”当作常态设计。链路断开的原因包括:对端复位/重配、线缆或连接器接触不良、电源波动、眼窗在温压下闭合、参考钟瞬断。核通过 hard error、信号检测和 channel_up 下降给出指示,用户逻辑要明确定义断开期间和恢复后的行为。断开瞬间:立即停止把需要可靠送达的数据交给核(或标记其可能丢失),冻结写入端的相关状态,记录断开时刻和在途序号;接收侧作废 FIFO 中可能不完整的帧,避免把半帧当数据。重连过程:channel_up 重新拉高后,不能立刻恢复业务——要等一个两端约定的“就绪交换”:双方互发 hello、对端确认应用层也已准备好、重置序号窗口和信用、清空 FIFO,之后再放数据。只看链路层 up 就发数据,是“重连后数据错位”类 bug 的根因。
数据一致性策略取决于业务:恒定码率的采样流允许丢包,重连后从新样本继续即可,关键是不要用陈旧或半截数据污染下游;命令/配置/文件类传输要求不丢不重,必须在 Aurora 之上加序号、确认、超时重传(轻量 Go-back-N 或选择重传),并把流控信用与重传缓存统一设计——发出去未确认的数据要保留到对端 ack,窗口大小按带宽×往返延迟估算。故障升级:设定重连次数/时间阈值,超过后上报系统健康管理、点亮告警、必要时触发对端复位或切换到冗余链路(冗余切换见 专家 43)。还要防止振荡:链路频繁 up/down 时加入滞回和退避,避免系统不断清状态、刷日志。把这些写成显式的链路管理状态机(INIT→UP→SYNC_APP→RUNNING→DOWN→RECOVER→FAIL),比在业务逻辑里散落的 if 条件可靠得多,也让现场故障可被日志完整回放(遥测设计见 专家 45)。
十三、性能工程:把标称线速率变成实际持续吞吐
最后解决一个高频困惑:IP 标称 10Gbps,实测却只有 6Gbps。差距几乎总在用户侧而非链路。逐项排查如下。编码与协议开销:先扣除编码效率(0.8 或 0.97)和帧/控制字符,这是理论上限,不是故障。AXI-Stream 握手效率:高带宽核的用户接口位宽大(如 64B/周期),要求 user_clk 每个周期都能握手;用户逻辑若用 FSM 隔一拍给一次 valid、或 tvalid 置起后又因内部判断拉低(违反 AXI-Stream 规则),吞吐直接腰斩。正确做法是发送侧用“满则停”的 FIFO 接口、valid 一旦置起保持到 ready,接收侧永远准备好接收(先入 FIFO 再处理)。反压传播延迟:下游(DDR、PCIe)偶尔繁忙导致 ready 拉低,若上游没有足够缓冲平滑,停顿会沿链路传播;按“下游停顿时长×带宽”设计弹性 FIFO 深度。
时钟与频率匹配:user_clk 频率由线速率和接口宽度决定,用户逻辑必须能跑在该频率(时序收敛见 专家 16),跑不到就要加宽接口降 user_clk 或加流水。多 lane 负载不均:把一条业务流静态绑到一条 lane 会浪费其余 lane,需要按报文/块轮询分发并在接收端重排,重排要处理乱序和最坏偏斜。中断与软件瓶颈:Aurora 数据若最终进主机,DMA 描述符、中断合并、缓冲区管理往往成为实际瓶颈(主机侧共性见 专家 07)。测量方法要科学:用硬件计数器统计“有效字节÷墙钟时间”和“valid&ready 握手周期占比”两个数——后者若不是接近 100%,问题在用户侧握手;若接近 100% 而有效吞吐仍低,问题在编码/帧开销或下游限速。把这两个计数器从第一天就做进设计,性能调优就从猜变成读表。
十四、Aurora 设计一页纸
协议定位:点对点透明流,无枚举、无交换、无内存语义,适合板间裸数据,不适合接主机或组网。选型三问:要报文边界选帧模式、恒定码率选流模式;带宽紧张选 64B/66B、管理面保留简单编码;流控按缓冲、NFC、端到端信用分级,信用返回路径不得经过会被本链路灌满的队列。上线六件事:官方复位序列加三级回环;全部锁定与错误状态入寄存器;链路断开时两端 FIFO、信用、序号同步复位并做应用层就绪交换;可靠传输自行加序号与重传;管理面独立于业务面;均衡参数版本化并在温压矩阵验证。记住一句话:Aurora 给你的是一条可靠的裸管道,管道之上的一切语义都由你负责。最后强调一个常被低估的协作点:链路两端往往由不同工程师或不同团队实现,协议契约(帧格式、控制字、序号、信用、复位握手)必须在开工前写成双方签字的接口文档并配联调用的回环测试桩,任何一端单方修改字段定义都要走变更评审。多板系统后期大量“偶发错帧”问题,追溯起来不是物理层而是两端对同一字段的理解漂移。接口文档、波形回放文件和版本号要随比特流一起管理。此外还要给链路建立容量基线:在常温、低温、高温各跑满带宽 soak test,记录 soft error 率和时钟修正频度,作为现场判读的参照——现场报“偶发错误”时,没有基线就无法区分正常裕量消耗和真正劣化。把基线数据纳入交付包,接手维护的团队才能在不重新做全量验证的情况下做出可信判断。
常见坑对照
| 坑 | 后果 | 正确做法 |
|---|---|---|
| 链路不起查协议 | 其实是物理层 | 回环分阶、看 lane_up/PLL lock |
| 两端参考钟偏差大 | 缓冲溢出/掉链 | ≤±300ppm + 时钟修正使能 |
| 流模式不持续取数 | 数据丢、报错 | 接收侧 FIFO 足够/持续 drain |
| 把 Aurora 当 PCIe 用 | 没有内存语义 | 接主机选 PCIe |
| 多 lane 跨 Quad 乱放 | 绑定失败 | 按核规则布局、参考钟同源 |
| 无反压设计 | 对端慢时丢帧 | NFC 或信用/水位协议 |
相关与延伸
一句话总结
Aurora 是跑在 GTP/GTX 上的轻量点对点串行协议:链路层做字节对齐、多 lane 绑定去偏斜、时钟修正(弹性缓冲消化两端参考钟 ±300ppm 频差),用户看到的就是一条 AXI4-Stream 透明管道(帧模式 tlast 定界、流模式无边界),channel_up/lane_up/hard_err/soft_err 反映状态。它比 PCIe/以太网小得多、延迟亚微秒,适合多 FPGA 板间、背板、FPGA-设备裸数据搬运;接主机用 PCIe、进网络用以太网。工程要点:独立参考钟即可但多 lane 绑定宜同源,流控要自己设计(NFC 或 FIFO 水位/信用反压,Aurora 无端到端流控),调试按近端 PMA 回环→远端回环→真实链路分阶,物理层差分 100Ω/AC 耦合/眼图裕量照收发器篇要求;JTAG-over-Aurora 可让一块下载器访问整个背板的 FPGA。