虚类模板方法模式:SystemVerilog 测试平台里用抽象基类定义算法骨架、子类填充步骤的场景族复用结构
更新时间:2026-10-04。验证工程师的测试库里有个普遍的生长规律:第一个测试写得干干净净,第二个测试从第一个复制粘贴改几行,第十个测试已经没人说得清它和第九个差在哪。差异通常只有几处——激励的约束不同、错误注入的位置不同、检查器的严格程度不同——但骨架完全一样:建环境、配参数、发激励、等完成、做比对。这类「骨架相同、步骤各异」的场景族,正是虚类模板方法模式(virtual class template method pattern)的主场:把算法骨架固化在抽象基类的
run_test()里,把会变的步骤声明成 virtual 钩子方法,每个具体测试只重写自己关心的钩子。站内的 测试用例基类派生 讲了「公共代码进基类」的基本功,UVM 环境垂直水平复用 讲了环境粒度的复用,这一篇往下钻一层:当复用粒度细到「一次测试运行内部的步骤编排」时,虚类模板方法模式怎么搭、钩子怎么设计、和工厂模式与回调机制的边界画在哪。
本文要回答的问题
- 虚类模板方法模式到底解决什么问题,和「复制粘贴改几行」差在哪?
- 模式的最小骨架长什么样,
virtual class和pure virtual各承担什么角色? - 钩子方法(hook)怎么设计:哪些步骤该做成钩子,粒度粗好还是细好?
- 模板方法与工厂模式、回调机制、约束随机分工的边界怎么划,什么场景不该用它?
- 用模板方法组织「场景族」回归时,目录结构、命名、覆盖率归并有哪些工程纪律?
一、问题的形状:十个测试九个像,差的只是几步
先看一个典型的真实场景。某 AXI VIP 的测试库里有这样一批测试:正常读写测试、burst 越界错误注入测试、backpressure 压力测试、复位中断恢复测试、QoS 优先级测试。把它们的 run_phase 并排摆开,主干一模一样:配置环境参数、构建激励序列、启动 sequence、等 scoreboard 收齐、检查统计计数、打印报告。真正不同的只有:激励约束怎么收口、错误注入挂在哪个节点、scoreboard 的严格级别。
复制粘贴的代价不是磁盘空间,是维护时的漏改。骨干逻辑里修一个 bug(比如「等完成」的超时阈值算错了),要同步改十个文件,改到第七个时被叫去开会,回来就忘了还剩三个。更隐蔽的是测试意图的稀释——评审一个新测试时,你得逐行 diff 才能找出它和基线测试的真正差异,而 diff 出来的 300 行里只有 15 行是意图,剩下全是骨架噪音。
虚类模板方法模式把这两件事一起解决:骨架在基类里只存在一份,改一处全局生效;子类里只剩钩子重写,一个测试的意图就是它重写的那几个方法,评审只看钩子。用一句 GoF(Gang of Four,设计模式四人帮)的经典定义说:模板方法定义一个算法的骨架,将一些步骤延迟到子类中,使得子类可以不改变算法结构就重定义某些步骤。SystemVerilog 的 virtual class 加 virtual function/task 恰好把这个模式表达得严丝合缝。
二、最小骨架:虚类定骨架,钩子留给子类
先把模式的最小可用骨架立起来。三个角色:抽象基类(virtual class,不可实例化,只定义骨架和钩子)、模板方法(run_test(),写死步骤顺序,调用钩子)、具体测试(继承基类,重写需要的钩子)。
virtual class axi_base_test;
  axi_env env;

  // ---- 模板方法:算法骨架,子类不许动 ----
  task run_test();
    pre_configure();          // 钩子 1:改配置对象
    build_env();
    configure_env();          // 钩子 2:环境级开关
    run_stimulus();           // 钩子 3:激励编排
    wait_completion();
    post_check();             // 钩子 4:收尾检查
    report_summary();
  endtask

  // ---- 钩子方法:默认实现 + 子类可重写 ----
  virtual function void pre_configure();  endfunction
  virtual function void configure_env();  endfunction
  virtual task run_stimulus();
    axi_seq seq = new();
    assert(seq.randomize());
    seq.start(env.agent.sequencer);
  endtask
  virtual function void post_check();
    if (env.scb.mismatch_cnt != 0)
      $error("mismatch = %0d", env.scb.mismatch_cnt);
  endfunction

  // ---- 骨架内部私有步骤:与钩子无关 ----
  function void build_env();  /* ... */  endfunction
  task wait_completion();     /* ... */  endtask
  function void report_summary(); /* ... */ endfunction
endclass

class err_inject_test extends axi_base_test;
  // 只重写差异:注入错误 + 放宽 scoreboard
  virtual function void configure_env();
    env.agent.driver.inject_mode = ERR_BRESP;
  endfunction
  virtual function void post_check();
    if (env.scb.mismatch_cnt != 4)   // 预期恰好 4 笔错误
      $error("expected 4 errors, got %0d", env.scb.mismatch_cnt);
  endfunction
endclass
这个骨架里有几个值得逐条抠的设计决策。第一,模板方法 run_test() 本身是普通 task 不是 virtual——它就是要不可被重写,骨架的权威性靠这个保证;谁想改骨架,去改基类,所有测试一起跟着变,这正是模式要的效果。第二,钩子给默认实现(哪怕是空实现)而不是声明成 pure virtual,让子类「按需重写」而非「被迫全填」——pure virtual 适合那种「不给实现就活不下去」的步骤(比如激励生成器的句柄),用多了会把每个子类都逼成样板代码集合,违背模式初衷。第三,钩子的命名直接对应骨架里的位置(pre_configure / configure_env / post_check),读子类时不用回基类就能猜到钩子在哪个时点被调。
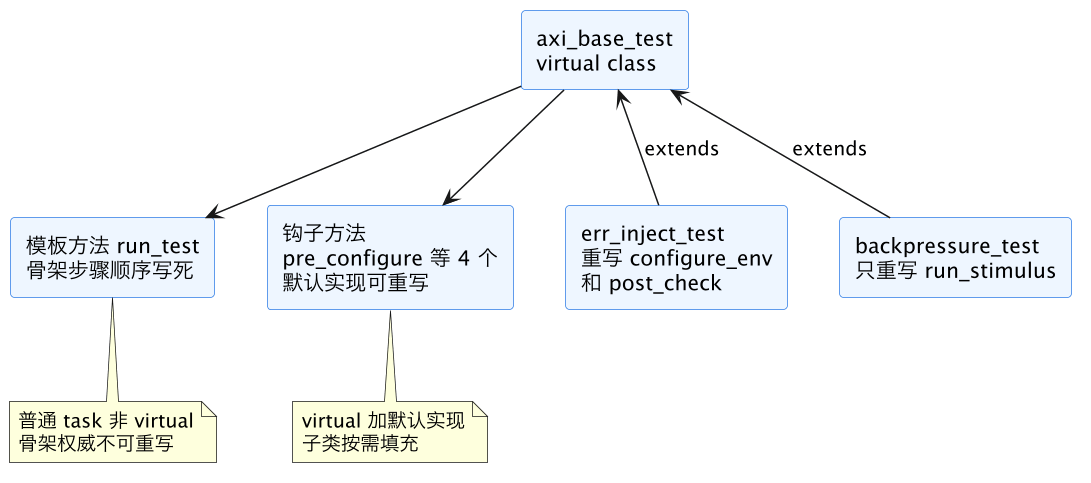
上图把三类成员的关系画清楚了:基类向下分出「写死的模板方法」和「留口的钩子方法」两簇,具体测试向上继承、只碰钩子那一簇。注意箭头语义的严格对应——子类到基类是 extends 泛化关系,基类内部是组成关系,这两类箭头混在一起画是 UML 图最常见的歧义来源。
三、钩子设计:模式的成败全在钩子划分上
骨架好定,钩子难划。钩子粒度是虚类模板方法模式里唯一需要真功夫的决策,划错方向各有代价。
钩子太粗——整个激励阶段就一个 run_stimulus() 大钩子——等于把模式退化成普通继承:子类一重写就是 80 行,其中 70 行还是从默认实现抄来的,差异又埋回噪音里。钩子太细——每一步都拆成 pre_xxx / do_xxx / post_xxx 三件套——骨架读起来的心智成本暴涨,而且很多钩子从来没被任何子类重写过,纯属占位尸位。经验法则是让差异分布来投票:先写三五个真实测试,把它们 diff 出来,差异落在哪几个时点,哪几个时点才配拥有钩子; diff 不出来差异的地方,留在骨架里当私有步骤。
实战里高复用价值的钩子通常落在这五个时点,可以用一张表对照。
| 钩子时点 | 典型重写内容 | 适合做成钩子吗 |
|---|---|---|
| 配置对象收口 | 改 cfg 字段、收口约束、切模式 | 必做,几乎家家不同 |
| 环境开关 | 覆盖率采样开关、检查严格度、错误注入路径 | 必做 |
| 激励编排 | sequence 选择与叠加、并发分支、权重分布 | 必做,场景族的灵魂 |
| 等待完成 | 超时阈值、完成判据 | 看情况,常和激励耦合 |
| 收尾检查 | scoreboard 阈值、统计断言、自定义比对 | 必做 |
注意「等待完成」那一栏的「看情况」:完成判据往往由激励形态决定(发 100 笔就等 100 笔回来),如果激励钩子已经能表达,等待逻辑就留在骨架里用统一策略(比如「激励发完加 drain 时间加 scoreboard 清空」),没必要再开钩子。钩子存在的唯一理由是被重写,没被重写的钩子是债务不是资产。
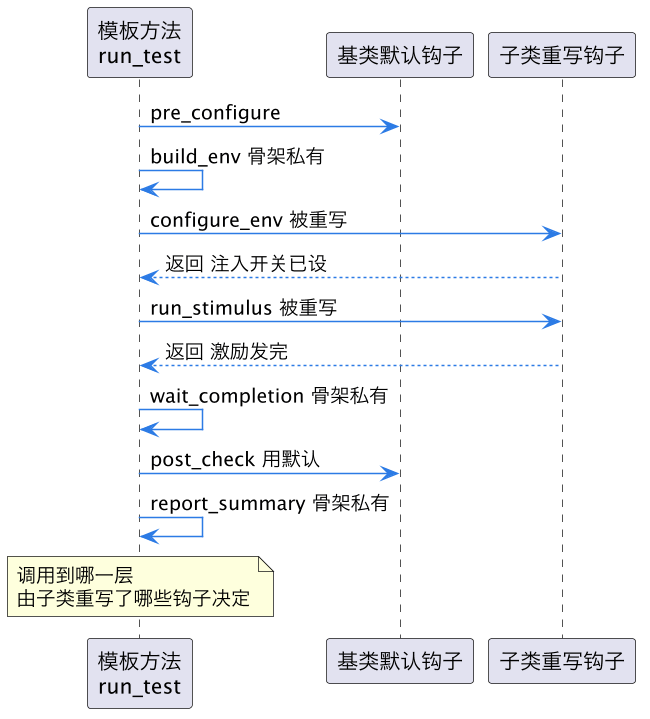
这张时序图表达的是运行时多态的实质:模板方法从头到尾是同一个调用者,但 configure_env 和 run_stimulus 两站因为子类重写而动态分派到子类实现,其余站落回基类默认。骨架里的私有步骤(build_env 等)永远是基类自己的代码。这张图的另一面是个调试提示:用仿真器单步跟踪测试流程时,调用栈在「基类 task 调子类 method」处跳层,不熟悉这个模式的工程师常在这里迷路,以为代码跳错了文件。
四、与邻居模式的边界:工厂、回调、约束随机各管一段
虚类模板方法模式从来不单独工作,它活在一片模式生态里。边界划不清,最常见的病是「所有问题都用继承解决」,类层次深得像家谱,改一个钩子影响三层派生。三条主要边界值得钉死。
与工厂模式的边界。工厂(factory pattern)回答「造哪个对象」,模板方法回答「流程怎么走」。两者天然互补:模板方法的骨架里用工厂造激励对象,子类通过重写上工厂注册的类型来换激励,连钩子都可以省掉一个。UVM 里这就是 factory override 的日常用法,纯 SystemVerilog testbench 里的等价做法见 虚类工厂模式。判据很简单:差异是「换一种对象」时走工厂,差异是「换一种步骤编排」时走模板方法钩子。把「换对象」也做成钩子重写是过度设计——你会得到一个 20 行的钩子方法,其中 19 行是 new 一个对象,1 行是有效意图。
与回调机制的边界。回调(callback)是「在对象行为里插桩」,模板方法是「在流程编排里留口」。driver 收发每笔 transaction 前后要插错误注入,那是回调的地盘,见 callback 钩子机制;测试流程走到「配置环境」这一步要做差异化设置,那是模板方法钩子的地盘。把回调机制拿来编排测试步骤,会得到一堆注册顺序敏感的隐式流程,谁注册谁先跑全靠纪律,三个月后没人敢动。
与约束随机的边界。激励「内容」的差异尽量用约束表达(改 cfg、改 constraint、加 inline constraint),激励「结构」的差异(发几类 sequence、并发还是串行、要不要插复位)才用钩子表达。场景随机化分层 讲的「配置层、场景层、事务层」分层和这里的划分同构:能随机出来的不要写成代码分支,能写成一个测试类的不要堆 if-else。
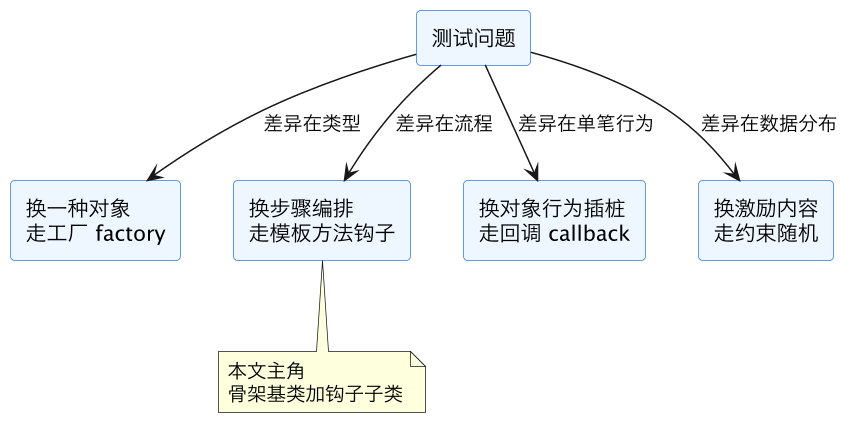
这张分流图是选型入口:拿到一个测试差异需求,先问差异落在哪一类,再进对应的模式。四类手段不是竞争关系,一个成熟的测试库里它们按这张图的边界同时服役。
五、组织场景族:从单个测试到回归矩阵
单个测试讲完了,模式的真正杠杆在场景族(scenario family)的组织上——把同一骨干流程下的一批差异化测试作为一个族来管理,而不是一堆散落的 class 文件。
落地结构推荐三层。第一层是族基类:继承公共 test base,把这一族特有的骨架段落补上(比如「错误注入族」统一在骨架里加「注错后等恢复」步骤),钩子集合在这一层定型。第二层是族内具体测试:每个测试类只做「重写若干钩子」这一件事,平均 20 到 50 行,类名直接说明差异(axi_bresp_err_test、axi_rready_backpressure_test)。第三层是回归清单:一个 scenario family 对应一份测试列表文件,列表里每行就是「类名加 seed 范围」,回归脚本按列表逐条 +TESTNAME=xxx 起仿真。三层结构下,新增一个场景的成本降到「写一个 30 行的类加一行清单」,这正是复用结构的验收标准。
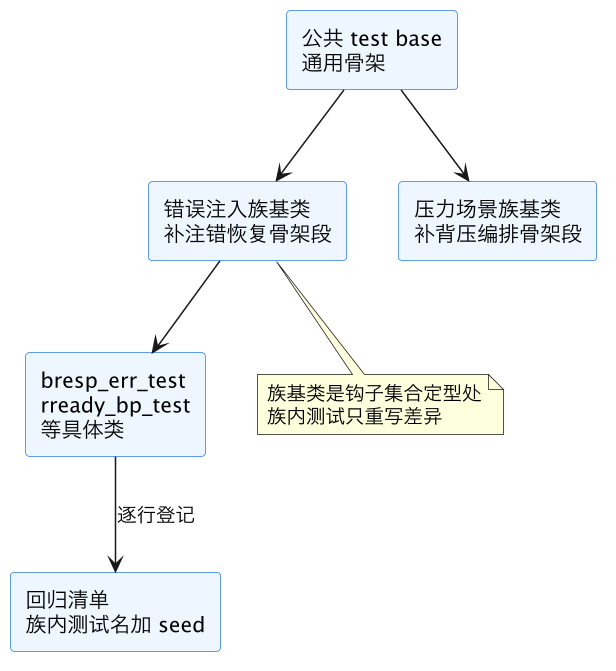
上图是族式组织的继承树加回归清单的关系:族基类夹在公共基类和具体测试之间,承担「这一族共同骨架段」的固化职责,叶子测试落到清单里被回归脚本驱动。注意继承深度控制在三层——再深就是上一节警告的「家谱病」,第四层的差异多半该用配置或约束而不是再开一层类。
场景族还有两条工程纪律容易被忽略。一是覆盖率归并按族合并:同族测试的 functional coverage 合在一个 merge 单元里看,族内覆盖缺口的责任归属才清楚,这和 覆盖率合并与排除流程 的合并粒度决策直接挂钩——骨架相同意味着覆盖空间相同,族内合并才有统计意义。二是钩子的回归保护:基类钩子一旦被某个下游项目重写,基类改动就有了隐性破坏半径,所以基类的每次修改必须触发全族回归,而不是只跑改动者手头那个测试;族基类是公共资产,公共资产的改动纪律就该比叶子测试重。
六、常见踩坑:模式用歪的四种形态
最后把实战里反复出现的误用列出来,每一条都有对应的返工形态。
坑一,把模板方法本身声明成 virtual。子类一旦重写 run_test(),骨架权威就瓦解了,你得到的是「每个测试各写一套流程」,模式名存实亡。发现这类代码,修法是把重写内容拆回钩子。坑二,钩子里塞骨架逻辑。子类钩子的前三行复制了默认实现的大段代码再追加几行——这说明钩子粒度划错了,正确做法是回基类把这段公共逻辑提升为骨架私有步骤或更细的钩子。坑三,钩子之间隐式依赖顺序。configure_env 依赖 pre_configure 设置的某个字段,而这个依赖只存在于某个子类的重写里——基类默认路径下字段没初始化,换一个子类就炸。钩子的契约必须自包含:基类保证每个钩子被调用前的环境状态合法,钩子不许假定前一个钩子被重写过。坑四,用模板方法硬扛本该用组合的差异。当一个测试想同时借用「错误注入族」和「压力场景族」的骨架段时,单继承就顶到墙了——SystemVerilog 不支持多继承,这时候正确的重构是把可复用的骨架段抽成独立的策略对象(strategy),模板方法的钩子改成委托给策略对象调用,继承树保持三层,灵活度靠组合补齐。这也是 测试平台分层架构复用 里「继承表达是什么、组合表达用什么」原则在测试层的直接推论。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录下 SystemVerilog testbench 结构线的一篇 S 层深文,主关键词虚类模板方法模式。向上承接 测试用例基类派生 的基类抽取基本功和 面向对象继承与多态 的语言机制,把「继承怎么用才不退化成复制粘贴」这个问题给出了模式级的答案。横向与 虚类工厂模式(造对象的复用)、callback 钩子机制(行为插桩的复用)、场景随机化分层(数据分布的复用)划清了四类复用手段的边界。向下,场景族的组织手法是 UVM 环境垂直水平复用 在测试粒度的对应物——环境复用管「搭建什么」,模板方法管「怎么跑」,两者合起来才构成完整的 testbench 复用体系;族内覆盖率合并的纪律则衔接 覆盖率合并与排除流程 的合并粒度决策。
总结
虚类模板方法模式的本质是把测试算法骨架固化在 virtual class 基类的非 virtual 模板方法里、把差异步骤做成带默认实现的 virtual 钩子让子类按需重写,从而消灭场景族里的骨架复制粘贴;用好的关键在钩子设计——让真实测试 diff 出的差异分布决定钩子时点,没被重写的钩子是债务,模板方法本身绝不可 virtual,钩子契约必须自包含;划清与工厂(换对象)、回调(行为插桩)、约束随机(换数据分布)的边界后,用「公共基类、族基类、叶子测试」三层继承加一族一清单的组织手法,把新增场景的成本降到三十行代码加一行回归清单,同时用族级覆盖率合并和基类改动全族回归两条纪律守住公共资产的破坏半径。