uvm_subscriber 覆盖收集器:analysis export 绑定 covergroup、write 回调与采样时序、多订阅者拓扑实战
更新时间:2026-10-02。UVM 环境里功能覆盖率的收集有一条公认的主线:monitor 从接口上把事务捞下来,通过 analysis port 广播出去,覆盖收集组件订阅这个广播,在回调里给 covergroup 采样。承担「订阅 + 采样」职责的那个组件,就是 uvm_subscriber。它的名字平淡无奇,网上教程多半只给你一段三行的样板代码,但真实项目里围绕它翻车的点一点不少:write 回调里直接 sample 导致采到半个事务、模板参数写错类型编译报出一屏天书、一个 monitor 挂三个订阅者结果覆盖率互相污染、回归合并时发现覆盖箱永远差一格打不满。本站的 UVM 组件与 phase 讲了组件骨架,UVM sequence driver scoreboard 讲了激励与比对链路,covergroup coverpoint bins 讲了覆盖箱本身怎么定义。这一篇把中间那一环——uvm_subscriber 怎么把 analysis export 和 covergroup 绑在一起——彻底讲透,从内部结构到采样时序到多订阅者拓扑,再到回归合并纪律,一次到位。
本文要回答的问题
- uvm_subscriber 内部到底封装了什么,它和「裸写 uvm_analysis_imp」的差别在哪?
- write 回调什么时候被调用、在里面 sample 有什么时序坑,事务拼接场景怎么处理?
- uvm_subscriber 的参数化模板怎么用,类型不匹配时报错怎么读?
- 一个 monitor 多个订阅者、多个 monitor 一个订阅者,两种拓扑各自怎么接线?
- 覆盖收集器的采样时机、覆盖组实例化策略、回归合并有哪些工程纪律?
一、uvm_subscriber 的本质:一个封装好 analysis_imp 的抽象类
先把定义钉死。uvm_subscriber 是 UVM 标准库提供的一个抽象组件类,源码展开后核心内容非常薄:它继承自 uvm_component,内部实例化了一个 uvm_analysis_imp#(T, this_type) 类型的成员,名字就叫 analysis_export,同时声明了一个纯虚函数 write(T t)。你继承 uvm_subscriber 时必须实现 write,这个 write 会在上游 monitor 的 analysis port 调用 write 时被间接触发。
class apb_cov_collector extends uvm_subscriber #(apb_txn);
  `uvm_component_utils(apb_cov_collector)

  apb_txn tr;
  covergroup cg_apb;
    cp_addr : coverpoint tr.addr { bins low = {[0:'hFF]}; bins high = {['h100:'hFFFF]}; }
    cp_write: coverpoint tr.write;
    cc_aw   : cross cp_addr, cp_write;
  endgroup

  function new(string name, uvm_component parent);
    super.new(name, parent);
    cg_apb = new();
  endfunction

  function void write(apb_txn t);
    tr = t;
    cg_apb.sample();
  endfunction
endclass这段代码是教科书样板,值得逐行拆。uvm_subscriber #(apb_txn) 的参数 T 决定了内嵌 analysis_export 接受的事务类型;cg_apb = new() 放在构造函数里,保证每个收集器实例一出生就带着自己的覆盖组实例;write 里先把事务句柄存下来再 sample,是因为 covergroup 的 coverpoint 表达式引用的是 tr 的成员——sample 的语义是「把当前表达式求值一次并对命中箱计数」,不 sample 就永远不会命中。
那它和「自己在普通 component 里手工声明一个 uvm_analysis_imp」差别在哪?差别小到可以忽略——uvm_subscriber 帮你省掉的就是 imp 的声明和类型绑定这两行。真正的价值在语义约定:团队里一看到 extends uvm_subscriber,所有人立刻知道「这个组件只订阅、只消费、不回写」,职责边界靠继承关系本身表达。站内的 UVM monitor analysis imp 讲了 monitor 侧手工接 imp 的完整细节,analysis port 多订阅者 讲了广播机制本身,本文聚焦「订阅者这个角色怎么用对」。
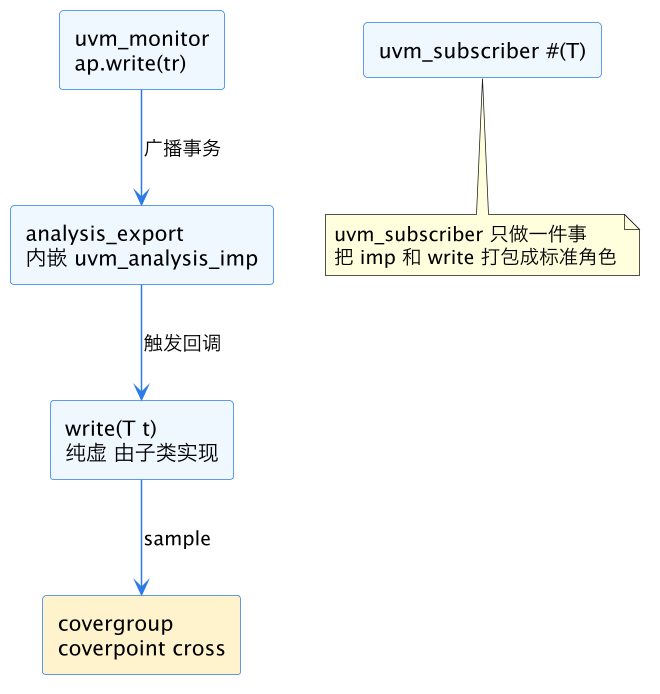
上图是 uvm_subscriber 的全部家当:monitor 广播的事务流进内嵌的 analysis_export,export 调用子类实现的 write,write 里完成 sample。链路每一环都是 UVM 标准件,唯一需要你写的就是 write 函数体和 covergroup 定义。理解了这个结构,后面所有的坑——时序、类型、拓扑——都只是在这条链路上找位置。
二、write 回调的时序:采到的是不是完整事务
write 回调的调用时序由上游 monitor 决定:monitor 在 ap.write(tr) 那一行同步调用所有订阅者的 write,整个过程发生在同一个仿真时间片里,是零延时的函数调用链。这个语义带来第一个坑——上游在 write 之后如果继续修改这个事务对象,你在 write 里 sample 到的可能是中间态。
最典型的现场是 monitor 边收边广播:收到地址相位就 write 一次,收到数据相位再 write 一次,用的是同一个事务对象。第一次 write 时 data 字段还是 X 或旧值,你的 coverpoint 如果引用了 data,就采进了一箱垃圾。解决纪律有两条:monitor 侧只在事务完整时广播(推荐,monitor 的职责就是还原完整事务);或者订阅者侧在 write 里先克隆再采样——tr = t.clone() 拿到快照,后续上游怎么改都与你无关。克隆的代价是性能,高频接口上一个 test 几百万笔事务,多一次克隆能吃掉可观的仿真时间,所以工程上首选改 monitor,把「广播时机 = 事务完整时机」写成 monitor 的编码规范。关于克隆语义的深浅拷贝细节,UVM clone create 语义 有专门展开。
第二个时序坑在采样窗口。covergroup 的 sample 是「调用时刻求值」,如果 coverpoint 引用的信号依赖时钟边沿后的稳定值,而 write 恰好在时钟边沿的 active region 被调用,你可能采到旧值。UVM 环境里这个问题通常不严重——monitor 本来就该用 clocking block 同步采样,clocking block testbench 同步 讲过这层语义——但有一种混合场景要当心:订阅者的 write 里除了 sample 事务级 covergroup,还直接 sample 了引用接口信号的 covergroup(通过 virtual interface 句柄)。这种写法把「事务采样」和「信号采样」混在一个回调里,信号采样的时序就继承了 monitor 调用 write 的精确时刻,和时钟的关系变得微妙。纪律:信号级覆盖交给接口里的 covergroup 用时钟事件采样(covergroup 采样时机 讲的四种触发方式),订阅者里只 sample 事务级覆盖,职责分开,时序问题自然消失。
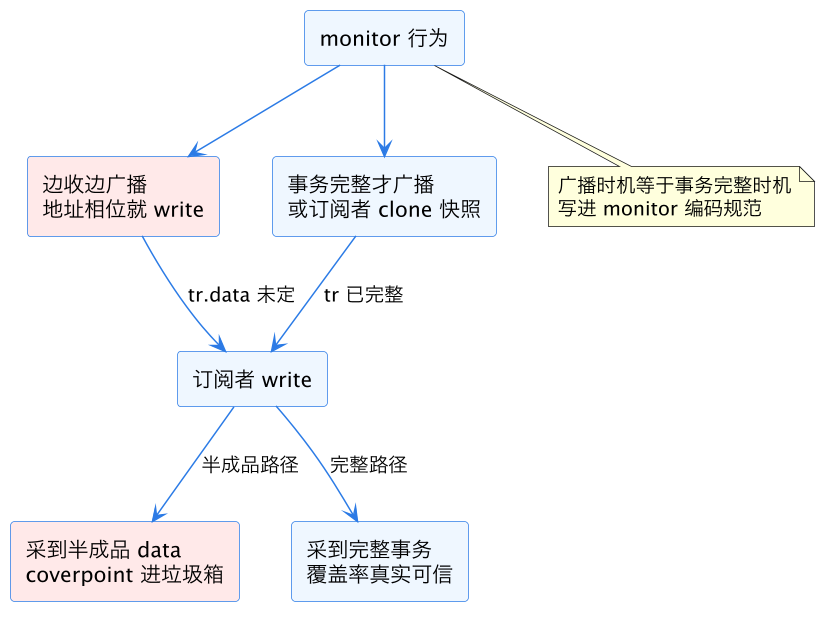
这张图回答「write 里 sample 之前先检查什么」:先检查上游给你的东西是不是完整的。覆盖率数据的价值完全取决于样本的真实性——采进一万笔半成品事务,合并出来的报告再漂亮也是垃圾进垃圾出,而且这类污染极难事后追查,因为覆盖报告里看不出哪笔样本是残缺的。
三、参数化模板与类型不匹配:报错怎么读
uvm_subscriber 是参数化类,uvm_subscriber #(T) 的 T 必须和上游 analysis port 广播的事务类型严格一致。真实项目里最常见的编译事故是:env 里连接时写的是 mon.ap.connect(cov.analysis_export),编译器报出一屏模板推导错误,核心信息埋在倒数第三行——port 的 T 是 apb_txn,imp 的 T 是 apb_txn_ext,两者不匹配。
这类错误的根源有三种。第一种最简单,就是写错了类名,把扩展类传给了基类收集器。第二种是工厂 override 造成的:test 里把 transaction 类型 override 成了派生类,monitor 广播的实际是派生类对象,但 port 声明的类型仍是基类——这种情况编译能过(基类句柄可以指向派生对象),运行时你的收集器如果只按基类字段采样,就丢了派生类新增字段的覆盖。第三种最隐蔽:两个 package 里各定义了一个同名事务类,import 顺序不同导致两个模块看到的 T 不是同一个类型,编译器报的错误消息里两个类型名一模一样,只能靠全限定名(pkg_a::apb_txn 对 pkg_b::apb_txn)区分。
工程纪律:订阅者声明的 T 用「采样需要的最完整类型」。如果你需要派生类字段的覆盖,订阅者就参数化成派生类,配合 $cast 在 write 里做下行转换并处理转换失败(失败说明工厂配置和收集器期望不一致,该报错就报错,不要静默跳过——静默跳过的后果是覆盖率悄悄缺一块)。多个层次的事务类型共存时,宁可给每层各写一个订阅者,也不要在一个订阅者里做一长串 $cast 试探,后者三个月后没人读得懂。类型系统的另一个相关话题是 factory override 的审计,UVM factory override 审计 讲了怎么排查「override 到底生效没有」。
| 现象 | 根因 | 处理 |
|---|---|---|
| connect 处模板报错一屏 | T 类型不匹配 | 看倒数几行的实际类型对 |
| 编译过但派生字段覆盖为零 | 按基类采样丢字段 | 订阅者参数化为派生类加 $cast |
| 报错里两个类型名相同 | 不同 package 同名类 | 用全限定名核对 |
| 覆盖率悄悄缺一块 | $cast 失败被静默 | 转换失败必须 uvm_error |
四、多订阅者拓扑:一对多与多对一怎么接线
analysis port 的广播语义是「一个 port 可以 connect 任意多个 export」,这让 uvm_subscriber 的拓扑非常灵活,但两种典型拓扑各有各的坑。
一对多:一个 monitor 挂多个订阅者。常见形态是一个功能覆盖收集器、一个性能统计收集器(算延迟、吞吐)、一个 trace 转存收集器同时订阅同一个 monitor。这是完全合法的用法,UVM 保证所有订阅者的 write 都会被调用。坑在调用顺序不保证——LRM 没有规定多个 imp 的回调顺序,如果你写的收集器之间有隐式依赖(比如收集器 B 依赖收集器 A 先处理过某个全局状态),那就是埋雷。纪律:订阅者之间零耦合,各自只依赖事务本身。另一个坑是覆盖率污染:两个收集器各自定义了名字相同的 covergroup,合并数据库时同名组会被合并而不是区分——如果两个组的 bin 定义不同,合并直接报错或数据错乱。纪律:covergroup 类型名全环境唯一,必要时加实例级 option.name 区分。
多对一:一个订阅者订阅多个 monitor。比如 AXI 环境里有读通道 monitor 和写通道 monitor,你想用一个收集器统计「读写混合比例」的交叉覆盖。做法是在收集器里声明两个 imp——但 uvm_subscriber 只内嵌了一个 analysis_export,所以要么给收集器手工加第二个 uvm_analysis_imp,要么干脆放弃 uvm_subscriber 继承、自己写 component 声明两个 imp(此时需要两个不同名字的 write 回调,用 uvm_analysis_imp_decl 宏声明 _write_read / _write_write 两套)。第二种方案更直白,uvm_subscriber 的便利性在「单订阅」场景,多源订阅就别硬套它了。sv-analysis-component-broadcast 对广播组件的通用组织方式有更细的展开。
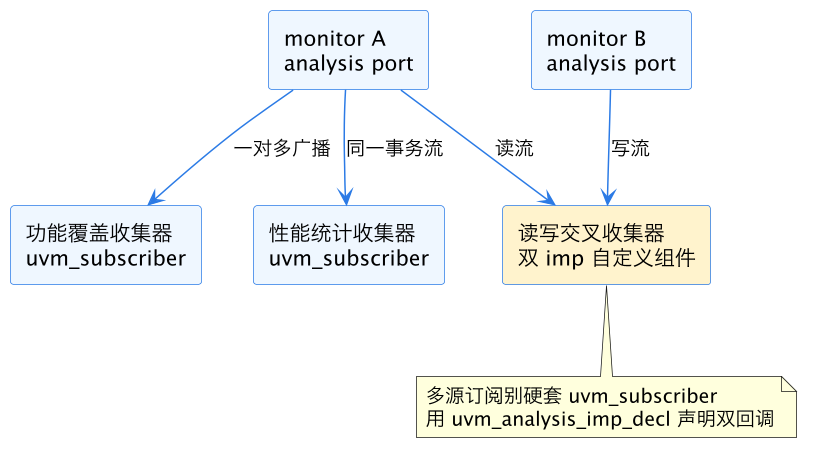
上图把两种拓扑画在一起:左侧 monitor A 一对多广播给两个标准订阅者,右侧读写两个 monitor 汇入一个双 imp 的自定义收集器。拓扑选择的判据很简单:订阅的事务源只有一个,用 uvm_subscriber;源有多个或者回调职责非覆盖(性能统计、转存),自己声明 imp 更诚实。
五、实例化策略与回归合并纪律
覆盖收集器怎么实例化、覆盖数据怎么进回归,决定了一个月后你的覆盖率数字还可不可信。
实例化策略的核心问题是「一个收集器实例对应几个 covergroup 实例」。默认情况下每个 uvm_subscriber 实例 new 一个 covergroup 实例,这天然正确。出问题的是两种偷懒写法:把 covergroup 定义成 static 想「全省一份」,结果多接口 agent 的所有实例共享一组覆盖数据,哪个接口贡献了哪个 bin 完全分不清;或者把 covergroup 的 option.per_instance 忘了设,合并时按类型合并而非按实例合并,实例维度的信息丢失。站内的 covergroup options goal atleast 把 per_instance、goal、at_least 这组选项的语义讲全了,本文只强调结论:覆盖收集器的 covergroup 一律 option.per_instance = 1,实例名带接口标识,合并时才能按实例追溯。
回归合并纪律有三条。第一条,覆盖收集器的 sample 必须在仿真结束前完整落盘——UVM 的 phase 机制保证 extract/check 阶段时所有 write 都已回调完,但如果你的环境用了 phase objection 提前收尾,最后一笔在途事务可能没广播就被截断,这种「最后一笔丢失」在长事务协议(大块 DMA 传输)上会稳定缺一个 bin。UVM phase objection 结束机制 讲的 objection 传递细节值得对照检查。第二条,合并时非法箱和忽略箱的定义必须全团队统一,同一个覆盖点有人标 illegal 有人标 ignore,合并工具的处理方式不同会导致覆盖率数字漂移——coverage bins illegal ignore 区分了两种箱的语义,覆盖率合并与排除流程 给了合并流水线。第三条,覆盖收集器本身要进评审:每个 coverpoint 对应验证计划里的哪一条,追不到验证计划的 coverpoint 是噪音,追不到 coverpoint 的验证计划条目是漏洞——testplan 覆盖映射 正是解决这个双向追溯的。
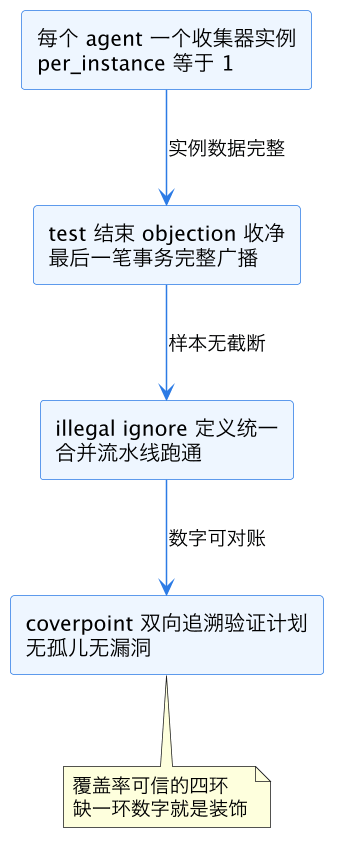
这四环是覆盖率可信度的完整链条:实例化对了数据才有粒度,事务收净了样本才完整,合并规则统一了数字才稳定,追溯验证计划了数字才有意义。uvm_subscriber 只是这条链条的第一环的技术实现,但第一环错了后面全错。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录下 UVM 组件线的一篇标准深文,主关键词 uvm_subscriber。向上承接 UVM 组件与 phase 的组件骨架和 UVM sequence driver scoreboard 的环境链路,把「monitor 之后、覆盖组之前」的订阅者角色补齐。横向与 UVM monitor analysis imp(生产者侧)、analysis port 多订阅者(广播机制)、sv-analysis-component-broadcast(通用广播组织)互为镜像;采样与覆盖组语义的细节散落在 covergroup coverpoint bins、covergroup 采样时机 与 covergroup options goal atleast。向下,收集器产出的覆盖数据汇入 覆盖率合并与排除流程 与 覆盖率驱动测试分诊,最终挂到 testplan 覆盖映射 完成签核闭环。
总结
uvm_subscriber 是 UVM 里把 analysis export 和 covergroup 绑在一起的标准订阅组件,本质只是「内嵌 uvm_analysis_imp 加纯虚 write」的薄封装,但用好它要守四组纪律:write 回调里只采完整事务(上游广播时机等于事务完整时机,或订阅者克隆快照),模板参数 T 用采样需要的最完整类型并 $cast 失败即报错,单源订阅用 uvm_subscriber、多源订阅改用 uvm_analysis_imp_decl 双回调,实例化坚持 per_instance 加实例命名、回归合并坚持 objection 收净、illegal ignore 统一、coverpoint 双向追溯验证计划——订阅者只是覆盖率可信链条的第一环,但第一环采进去的是垃圾,后面合并出来的再漂亮也是垃圾。