UVM analysis port 广播:一个 monitor 如何同时喂饱 scoreboard 与覆盖率
更新时间:2026-09-29。UVM TLM port/export/imp:组件间事务怎么流 讲了点对点阻塞与非阻塞端口的三种角色;UVM monitor 与 analysis_imp:观测数据怎么出组件 讲了 monitor 为什么必须用 analysis port 吐出事务。这一篇再往前走一步:现实环境里一个 monitor 的事务从来不是只喂一个消费者——scoreboard 要比对、covergroup 要采样、trace 组件要落盘——靠的就是 analysis port 的广播语义。
本文要回答的问题
- analysis port 和普通 port 的「一对多」能力差别在哪?为什么广播不需要 monitor 知道订阅者有几个?
- 一个组件想同时接收两种事务流,多个
analysis_imp怎么写才不会编译冲突? - 分层环境里 subscriber 套 subscriber 的「接力广播」怎么搭?
write()在哪个仿真时刻被调用,和 scoreboard 的采样时机有什么关系?
一、广播语义:port 只管喊,谁来听它不管
普通 TLM 端口(uvm_blocking_put_port 这类)是严格一对一的:connect 阶段一个 port 只能连一个 export,多连直接报 elaboration 错误。analysis port 打破了这个限制:
class apb_monitor extends uvm_monitor;
  uvm_analysis_port #(apb_txn) ap;

  function void build_phase(uvm_phase phase);
    ap = new("ap", this);
  endfunction

  task run_phase(uvm_phase phase);
    apb_txn tr;
    forever begin
      collect_one(tr);        // 从接口采一笔事务
      ap.write(tr);           // 广播:所有订阅者都会收到
    end
  endtask
endclass
ap.write(tr) 的语义是:遍历当前连接到该 port 的所有 analysis_imp,依次同步调用每个订阅者的 write()。订阅者是 0 个不报错(这在普通端口上是致命错误,广播场景下是合法的——monitor 不应关心下游有没有人在听),是 5 个就调 5 次。monitor 的代码里没有任何「订阅者列表」的概念,连接关系完全在 env 的 connect_phase 里由上层决定。这种「发布者无知」正是 UVM 环境可扩展性的根基:新增一个消费者,只改 env 不动 monitor。
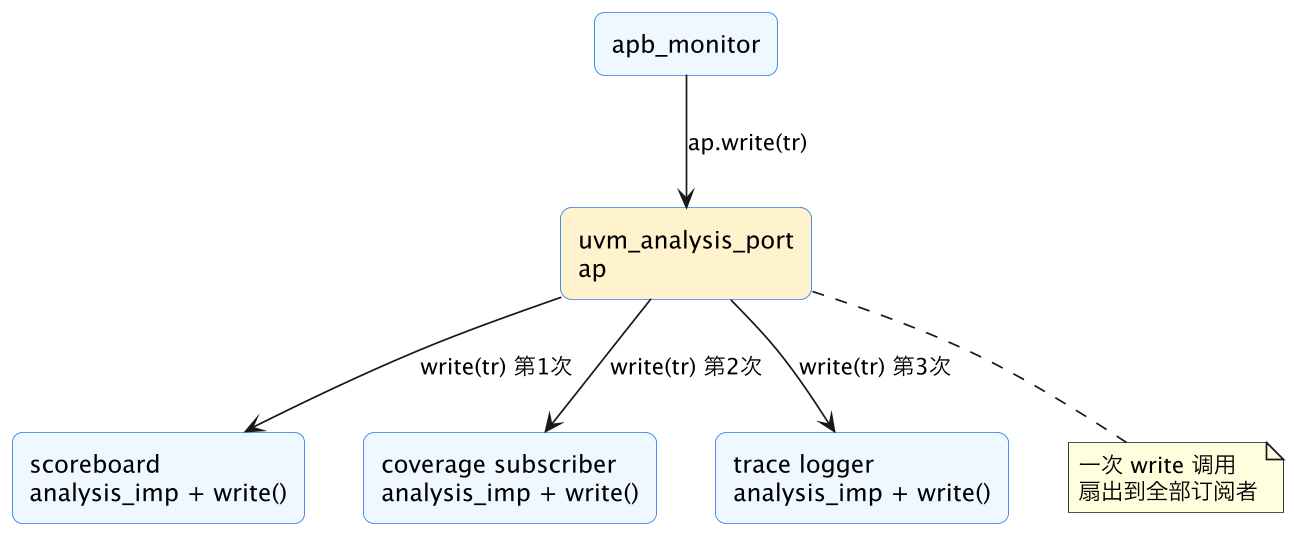
这张扇出图抓两个要点:其一,ap 是 monitor 内部的一个对象,扇出逻辑由 UVM 库完成,monitor 只写一次 ap.write(tr);其二,三个订阅者的 write() 是按 connect 顺序同步依次调用的,全部返回后 ap.write(tr) 才返回——这一点决定了后面要讲的采样时机纪律。
二、多订阅端:analysis_imp 的写法与命名冲突
订阅侧的标准动作是在组件里声明 uvm_analysis_imp 并实现 write()。uvm_subscriber 基类已经内置了一个 analysis_export,纯覆盖率组件直接继承它即可:
class apb_coverage extends uvm_subscriber #(apb_txn);
  `uvm_component_utils(apb_coverage)
  covergroup cg;
    addr: coverpoint t.addr { bins lo = {[0:'hFF]}; bins hi = {[>'hFF]}; }
    dir:  coverpoint t.write;
  endgroup
  apb_txn t;

  function void write(apb_txn tr);
    t = tr;
    cg.sample();     // 每收到一笔就采一次
  endfunction
endclass麻烦出在一个组件要接两路不同事务流的时候。典型场景:scoreboard 同时监听 master 口和 slave 口的 monitor。uvm_analysis_imp 的参数化类型绑死了 write() 的签名,直接声明两个 imp 会得到两个同名 write 冲突。解法是 uvm_analysis_imp_decl 宏声明带后缀的 imp:
`uvm_analysis_imp_decl(_master)
`uvm_analysis_imp_decl(_slave)

class apb_scoreboard extends uvm_scoreboard;
  uvm_analysis_imp_master #(apb_txn, apb_scoreboard) m_imp;
  uvm_analysis_imp_slave  #(apb_txn, apb_scoreboard) s_imp;

  function void write_master(apb_txn tr);  req_q.push_back(tr); endfunction
  function void write_slave (apb_txn tr);  rsp_q.push_back(tr); endfunction
endclass
宏展开后生成 uvm_analysis_imp_master 类型,它回调的函数名是 write_master 而非 write,冲突消解。env 里照常 connect:mon_m.ap.connect(sb.m_imp);。这套宏是 UVM 里少数「必须背下来」的惯用法,凡是双口协议(AXI 的读写通道、请求/响应分离的总线)的 scoreboard 都会用到。scoreboard 内部拿到两路队列后的比对策略见 SV scoreboard 实现:队列比对与乱序匹配。
三、分层广播:env 内部再扇出一次
规模上来以后,消费者不一定和 monitor 平级。子系统级 env 里常见的结构是:block 级 env 的 monitor 先广播给 block 内 scoreboard,同时 block env 自己再暴露一个 analysis port 向上转发,subsystem 层的覆盖率组件订在转发口上。这就是「subscriber 再当 publisher」的接力:
class block_env extends uvm_env;
  apb_monitor    mon;
  apb_scoreboard sb;
  uvm_analysis_port #(apb_txn) env_ap;   // 对外转发口

  function void connect_phase(uvm_phase phase);
    mon.ap.connect(sb.m_imp);      // 内部消费
    mon.ap.connect(env_ap);        // analysis_port 也能被 connect,等价转发
  endfunction
endclass
注意第二行 connect 的目标是另一个 uvm_analysis_port——UVM 允许 port 连 port,效果是把广播原样接力出去,block env 自己不消耗事务。subsystem env 里 blk_env.env_ap.connect(sub_cov.analysis_export); 一句话完成订阅。
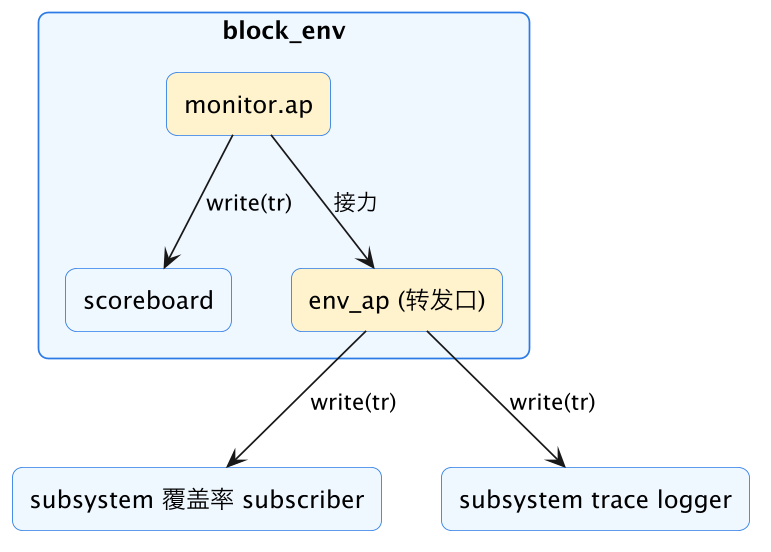
图里的关键判断是转发口不复制事务、不引入延迟:env_ap 只是把调用链再往下传一层,subsystem 的两个订阅者收到 write(tr) 与 block 内 scoreboard 收到的是同一个对象句柄、同一个时间步。层数再多也不改变这个性质。
四、采样时机:write 是零耗时的同步调用
广播机制最容易被忽视的一点是:整条 write 调用链不消耗任何仿真时间。monitor 在时刻 T 调用 ap.write(tr),所有订阅者的 write() 都在时刻 T 的同一个 time slot 内执行完。这带来三条纪律:
write()里不许有时序语句。write是 function,不能@不能#不能wait。订阅者若要做耗时处理(比如往 DPI 送数据、等某个状态),只能把事务塞进队列,在自己的run_phase进程里慢慢消化。- 事务对象必须克隆或只读。monitor 下一拍会复用或覆盖
tr的字段,订阅者若只存句柄,回头一看队列里全是同一个对象的最后状态。纪律是:要么 monitor 每次write前 new 一个新对象(推荐),要么订阅者入口就tr.clone()。 - 采样点即广播点。covergroup 在
write()里直接sample(),采到的是 monitor 完成采样的那一拍的数据。如果设计里同一拍还有别的 monitor 也在广播,两个订阅者之间没有先后保证之外的时序关系——别把「覆盖率采样时刻」当成「信号稳定时刻」之外的任何东西。和 clocking block:测试平台与 DUT 的同步语义 里讲的采样区间配合理解:monitor 通常在 clocking block 的采样沿取数,紧接着广播,所以订阅者看到的永远是采样后的稳定值,这是这套链路不出竞争问题的根本原因。
下面这张表把广播链路上的角色职责再钉一遍:
| 角色 | 关键成员 | 能做什么 | 不能做什么 |
|---|---|---|---|
| 发布者(monitor) | uvm_analysis_port + ap.write(tr) | 每拍广播一次;不知道订阅者数量 | 假设有人订阅;write 后复用 tr 字段 |
| 订阅者 | uvm_analysis_imp + write() 或继承 uvm_subscriber | 零耗时处理:采样、入队、计数 | 在 write 里挂时序;长期持有未克隆的 tr |
| 转发层 | env 内的 uvm_analysis_port | port 连 port 接力广播 | 在转发路径上加缓冲、改数据 |
| 上层 env | connect_phase | 决定谁订谁,一对多自由组合 | 在 connect 之外动态增删订阅(技术上可行但自找麻烦) |
五、广播与回调的边界:什么时候不该用 analysis port
广播不是万能的。两类场景它不合适,硬用会把环境搭歪。
第一类是需要消费者反馈的流控场景。analysis port 是纯推送,发布者拿不到任何返回,订阅者处理不过来也无法反压。如果下游是参考模型且处理一笔事务要调度复杂计算,正确结构是 monitor 广播给「适配层组件」,适配层内部用阻塞 put/get 端口与参考模型做带握手的点对点通信——广播负责分发,阻塞端口负责流控,各管各的一段。
第二类是需要按条件路由的场景。比如「错误事务只送 debug 组件、正常事务送 scoreboard」。analysis port 对所有订阅者一视同仁,过滤只能在订阅者的 write() 入口做(不感兴趣的直接 return)。订阅者少时这么干没问题;如果过滤条件复杂且各订阅者各不相同,说明分流逻辑该收进一个专门的 router 组件:router 订阅 monitor,判定后用自己持有的多个 analysis port 分别广播给不同下游。这本质上是把「扇出」和「路由」两个职责拆开,环境结构会清晰得多。
六、常见坑速查
实际回归里和广播相关的三类高频问题,按出现率排序:
- 「数据全是最后一笔」:订阅者存了句柄没克隆,monitor 又复用对象。波形上 scoreboard 报一连串莫名其妙的不匹配,第一条线索就是队列里所有元素的句柄地址相同。
- 「覆盖率数字对不上 transaction 数」:
write()里 sample 了,但该 subscriber 忘了 connect——广播对零订阅者静默合法,不会报任何错。对策是在 env 的check_phase里断言ap.size() > 0(uvm_analysis_port::size()返回当前订阅数),把「没人听」变成显式失败。 - 「宏声明放错位置」:
uvm_analysis_imp_decl(_master)必须写在 package 作用域、类定义之前,写在类里面编译器会给出非常费解的报错。这是 UVM 宏的老脾气,见过一次就记住了。
这一篇在知识体系里的位置
- 上游机制:UVM TLM port/export/imp:组件间事务怎么流 定义了三种端口角色,本篇的广播是 analysis 端口独占的扩展语义。
- 数据出口:UVM monitor 与 analysis_imp:观测数据怎么出组件 讲 monitor 侧为什么不能用阻塞端口,本篇讲的是出口之后怎么分流。
- 下游消费:SV scoreboard 实现:队列比对与乱序匹配 与 覆盖率模型:covergroup 与 bins 设计 分别是两条订阅链的终点实现。
- 时序底座:clocking block:测试平台与 DUT 的同步语义 保证广播出去的永远是采样后的稳定值。
总结
UVM analysis port 广播让 monitor 一次 ap.write(tr) 同步扇出到任意数量的订阅者,发布者对订阅关系零感知;多路事务流入同一组件用 uvm_analysis_imp_decl 宏消解 write 命名冲突,分层环境用 port 连 port 做零延迟接力广播;整条 write 链零耗时,所以订阅者只许采样和入队、事务要么新分配要么克隆,再用 ap.size() 守住「没人订阅」的静默失败——守住这几条,一套 monitor 就能干净地喂饱 scoreboard、覆盖率和 trace 三路人马。