数模混合协同设计:把基尔霍夫的连续世界和 0/1 的离散世界装进一个仿真(F3)
纯模拟求解器(SPICE/Fast-SPICE、收敛与拐角)见 F1,模拟版图与 PEX 见 F2,混合语言数字协同见 A5,概念见 混合信号边界;本篇讲真正的数模混合仿真与协同收敛:Cadence AMS Designer(含 XPS 高速模式)/Spectre AMS、Synopsys 侧 Custom Sim 与 VCS 耦合,怎么让 SPICE 的连续模拟网表和 Verilog 的离散数字进程在同一个 testbench 里跑。
一、为什么不能简单「各跑各的」
模拟(SPICE)和数字(事件驱动)是两套完全不同的数学:
- 模拟:用连续时间、连续电压电流,对非线性微分代数方程组(矩阵)做瞬态积分,任何节点都是实数电压,满足基尔霍夫定律(能量守恒);
- 数字:用离散事件 + 逻辑值 0/1/X/Z,只在信号跳变时唤醒进程求值,是离散、事件驱动的。
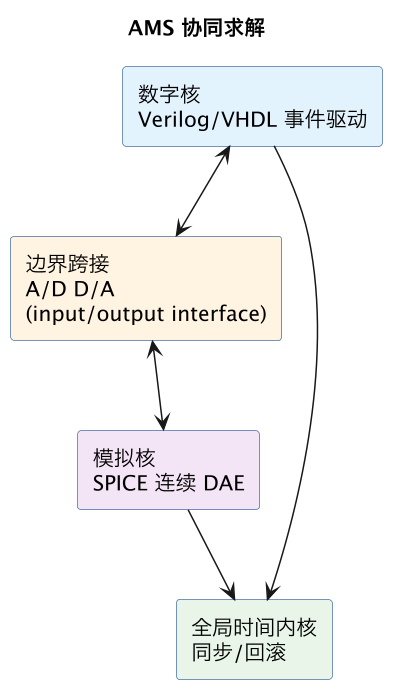
在一个 SerDes、PLL、ADC/DAC、电源管理芯片(PMIC)或 SoC 里,PLL 输出的连续时钟要喂给数字逻辑,数字寄存器输出又要控制模拟开关/电流源。必须有工具在运行时同时推进两个求解器并在边界上互译——这就是混合信号(mixed-signal / AMS)仿真。
二、Verilog-AMS / VHDL-AMS:两套语义的桥
Verilog-AMS 在 Verilog 数字事件语义上加了模拟扩展:
analog连续赋值块(analog begin),用在每个模拟时间点求解;- **从节点(branch/nature)**取连续量(
V()、I()),用 贡献语句<+写电流/电压(如I(p,n) <+ ...); - 跨接函数在两世界间转换:
$abstol/过渡函数、transition():把离散数字值变成平滑连续波形(D→A,带有限上升/下降时间,避免数学上的不连续导致求解器震荡);cross()/ above()`:检测连续电压越过阈值(A→D),据此产生数字事件;
- discipline/nature 声明节点的电气类型(电压、电流、容差)。
写 PLL/DLL、比较器、ADC/DAC 的行为级模型常常用 Verilog-AMS:比晶体管级 SPICE 快几个数量级,又比纯 RTL 更接近模拟行为(连续、有限边沿、失调),是数字团队在等真模拟硬 IP 时的关键替身(与 A5 SystemC 替身 类似但在电学连续域)。
三、接口算法与全局时间同步(收敛问题的根源)
工具在数模边界插入 connect module(A2D/D2A 接口元件),负责电平翻译、驱动强度、阻抗与 Z/X 处理。全局同步大致两种:
- 统一时间步长 / 锁步(lock-step):数字事件与模拟积分时间点对齐推进,准确但慢;
- 数字以事件驱动、模拟用自适应步长:数字跳变时让模拟求解器在该时刻取点(hit crossing),模拟检测到的
cross()事件再回插(backanno)唤醒数字——处理不好会错过阈值穿越或反复回退(rollback)。
收敛坑几乎都在边界:
- 数字输出理想阶跃直接灌进模拟高阻/容性节点 → 导数无穷大,矩阵不收敛;要用
transition()给有限边沿、加合理驱动阻抗; cross阈值设得与信号容差(abstol)不匹配 → 抖动产生大量伪事件(一个穿越被触发成百上千次),仿真极慢;- 接口的 Z/X/强度语义(总线竞争、上拉)翻译不一致 → 数字侧 X 与模拟侧高阻对不上;
- 数字时钟来自模拟 PLL:时钟沿由
cross检测产生,jitter/边沿斜率直接影响数字行为,模型太理想会掩盖问题。
四、精度档位:从晶体管到全芯片,选对抽象
混合信号工具提供多级精度,按块选择(digital real / 信号流 / 全模拟):
| 级别 | 模拟表示 | 速度 | 用途 |
|---|---|---|---|
| 全晶体管 SPICE(F1) | 全 BSIM 器件、守恒 | 最慢最准 | 关键模拟核、PLL 抖动、ADC 线性度 |
| Fast-SPICE | 电路划分/事件加速、近似 | 快数十~千倍 | 大 SRAM、PLL 锁定、上电序列、大电源网络 |
| 信号流 / real-number model(RNM,wreal/SystemVerilog 实型) | 只传实数电压、不守恒 | 接近数字速度 | 数模比例悬殊的大 SoC 全芯片(电源域、ADC 数据流) |
| 纯数字 RTL | 0/1 | 最快 | 控制逻辑功能 |
- 实数模型(RNM / SystemVerilog wreal、AMS Designer 的数字实数):把模拟量当浮点在事件核里传,不求解矩阵,极大提速,适合「数字为主、模拟为行为模型」的 SoC 级(PMIC 上电时序、混合低功耗域,配合 UPF);
- 真正需要能量守恒/阻抗/反馈的关键模拟块,仍要切回 Fast-SPICE/SPICE 子电路(在同一原理图里给不同块指定不同精度,即 split-level / multi-rate)。
五、协同不只是仿真:版图、验证、签核也要合
混合信号芯片的工程协同点:
- 共用版图与连接:模拟库(F2 Virtuoso)与数字 P&R(D1)的 LEF/DEF/GDS/OASIS 要在顶层正确组装(F2 格式、F7 GDS),数模边界的 pin、阱、guard ring 要对齐,LVS 要能识别整片(E3);
- 网表混合:数字综合网表(门级)+ 模拟 PEX 后网表(F2)可做混合后仿;
- 验证复用:数字 UVM 环境(A2)经 AMS transactor 驱动模拟激励(如给 ADC 喂连续波形、监测 DAC 输出),模拟行为模型让数字回归不必带晶体管;
- 功耗协同:模拟供电(LDO/DCDC,见 片上 LDO)与数字电源完整性(E4)在顶层联合,上电/掉电序列常是混合后仿最容易出事的场景。
六、实践建议(收敛与提速)
- 行为模型先行:用 Verilog-AMS/RNM 建 PLL/ADC/DAC 替身,数字团队不等硬 IP;
- 边界建模给足物理性:
transition()有限边沿、真实驱动阻抗、合理abstol/cross 方向与容差; - 分级精度:关键核 SPICE,大块 Fast-SPICE/RNM,不要全芯片全晶体管;
- 先跑上电/复位/时钟锁定/低功耗切换这些最易出数模交互 bug 的序列;
- 模型与最终 IP 用同一 testbench 在多 corner(F1/E2)做相关性确认,避免「行为模型对、真 IP 不锁」。
相关与延伸
- 模拟求解:F1 SPICE/Fast-SPICE;模拟版图:F2 Virtuoso/PEX。
- 数字混合语言:A5 Verilog/VHDL/SystemC;数字验证:A2 UVM。
- 顶层组装与签核:D1 P&R、E3 Calibre、F7 GDS、E4 功耗。
- 概念:混合信号边界、片上 LDO。
总结
数模混合仿真的本质是让满足基尔霍夫定律、对连续非线性微分方程做矩阵积分的 SPICE 世界,和离散事件驱动、只有 0/1/X/Z 的数字世界在同一时间内核里锁步推进,并靠 connect module 在边界互译:Verilog-AMS 用 analog 块、节点电压电流和 <+ 贡献语句描述连续行为,用 transition() 把数字阶跃变成带有限边沿的平滑波形、用 cross()/above() 把连续电压越阈翻译成数字事件;绝大多数不收敛都源于边界——理想阶跃灌高阻节点、cross 容差不当产生伪事件风暴、X/Z 强度语义不一致,以及 PLL 连续时钟沿的 jitter 建模;工程上按块选精度,关键模拟核用全晶体管 SPICE、大 SRAM 和上电序列用 Fast-SPICE、数模比例悬殊的全芯片用只传实数不守恒的 RNM 信号流逼近数字速度,行为级 PLL/ADC/DAC 模型让数字团队不等硬 IP 即可回归;同时协同远不止仿真——模拟 Virtuoso 与数字 P&R 的版图要经 LEF/DEF/GDS 在顶层正确组装并整片 LVS,门级网表加 PEX 后网表可做混合后仿,而最先跑、也最容易暴露问题的正是上电、时钟锁定与跨电源域切换这类真正发生数模交互的序列。