PDL 依赖启动:Programmatic Dependent Launch 消除 kernel 间空泡的编程模型
更新时间:2026-10-04。前面 kernel 启动开销与融合 讲过单个 kernel 的启动成本从哪来、为什么小 kernel 序列会被 launch overhead 拖垮;CUDA Graph 捕获与回放 讲过怎么把一整串 kernel 录成图、一次提交消除 CPU 侧调度开销。这两篇解决的是「启动太贵」的问题,但即使启动免费了,GPU 时间轴上还残留着一道缝:前一个 kernel 的尾部和后一个 kernel 的头部之间,SM 有一段谁都没活干的空泡。PDL 依赖启动(Programmatic Dependent Launch,编程式依赖启动)就是 Hopper 架构给的补缝工具——允许下游 kernel 在上游 kernel 还没完全结束时提前拿到 SM、先把不依赖上游数据的准备工作做掉。本篇把 PDL 的语义、两个
griddepcontrol原语、使用的边界条件,以及它和 CUDA Graph「一个管启动、一个管重叠」的分工讲透。
本文要回答的问题
- kernel 之间的空泡到底有多大,为什么 LLM 推理的 decode 阶段对它最敏感?
- PDL 依赖启动的语义是什么,「提前启动」到底提前了多少、安全性靠什么保证?
cudaTriggerProgrammaticLaunchCompletion和cudaGridDependencySynchronize两个原语怎么配合?- 什么样的 kernel 对能吃到 PDL 的收益,什么样的不行?
- PDL 和 CUDA Graph 是替代关系还是互补关系,实际部署怎么组合?
一、空泡从哪来:kernel 之间的「清场」时间
先看没有 PDL 时 GPU 的执行模型。同一条 stream 上两个 kernel K1、K2 串行发射,硬件的语义是:K2 的任何线程块在 K1 的所有线程块全部退出之前,不允许被调度上 SM。这不是软件限制,而是 stream 顺序语义在硬件层的实现——K2 可能读 K1 写的任何全局内存,最保守且唯一正确的假设就是「K1 完全写完」。
问题在于 K1 的「完全结束」有个拖尾过程:最后几个线程块收尾、flush 写回、SM 上的资源(寄存器、shared memory)释放、调度器扫描依赖、然后 K2 的线程块才开始被分发。这一串加起来,单个 kernel 间隙在 Hopper 上大约是 2~4 微秒量级——注意这是硬件清场加调度的开销,跟 CPU 侧的 launch 开销(CUDA Graph 解决的那个)是两码事,Graph 回放时这个间隙依然存在。
2~4 微秒听起来无所谓?放到 LLM decode 场景算笔账。一次 decode 前向,一个 70B 级别模型跑 80 层,每层含 RMSNorm、QKV GEMM、RoPE、attention、output GEMM、又一个 RMSNorm、MLP 三个 GEMM 加激活——配合 RMSNorm 与 RoPE 融合 kernel 这类优化后,每层仍有 6~8 个 kernel,全模型一轮就是 500~700 个 kernel。decode 阶段 batch 小、每个 GEMM 本身可能只有 5~15 微秒,kernel 间隙占比轻松摸到 20%~30%。整个 decode 时间轴上有四分之一的 SM 时间在清场,这就是 PDL 要吃的肉。

上图里还有两个常被忽略的细节:K1 的尾部本身利用率也在掉——最后几个线程块跑不完,其余 SM 已经闲了(GEMM 尾波效应,GEMM split-k 与 stream-k 调度 讲的正是 GEMM 内部的尾波);K2 的头部同样有一段「还没碰到上游数据」的工作:线程块被分发上来、读自己的元信息、算 tile 坐标、预取权重。K2 头部这段工作根本不依赖 K1 的输出——它只依赖常量(权重、配置)。PDL 的核心洞察就在这:既然 K2 的头部不碰 K1 的数据,为什么不让它在 K1 收尾时就开跑?
二、PDL 语义:下游提前上 SM,用原语划出安全线
PDL 的编程模型由两半组成:启动侧的 launch attribute 和 kernel 内的两个原语。
启动侧,发射 K2 时用 cudaLaunchAttributeProgrammaticStreamSerialization(值为 1)标记这个 kernel「允许和上游重叠」。这一标记的含义是:硬件不再等 K1 彻底清场,而是在收到 K1 发出的一个「我快写完了」的信号后,就开始往 SM 上分发 K2 的线程块。
kernel 内的两个原语定义了这条安全线的精确位置:
cudaTriggerProgrammaticLaunchCompletion():上游 kernel(K1)调用,意思是「我的输出数据已经写完,或者至少写到只剩尾巴了,下游可以开始上来了」。它是个「发令枪」——触发后下游的线程块开始被调度。注意它是提示而非保证:即使 K1 不调用,硬件也会在 K1 所有线程块退出时隐式触发,语义不会错,只是重叠窗口没了。cudaGridDependencySynchronize():下游 kernel(K2)调用,意思是「从这里往后的代码要读上游的输出,必须等上游全部完成」。它是个「闸门」——K2 提前上来的线程块可以在闸门之前随便干活(只要不读 K1 写的内存),走到闸门处阻塞,直到 K1 真正全部退出且内存可见。
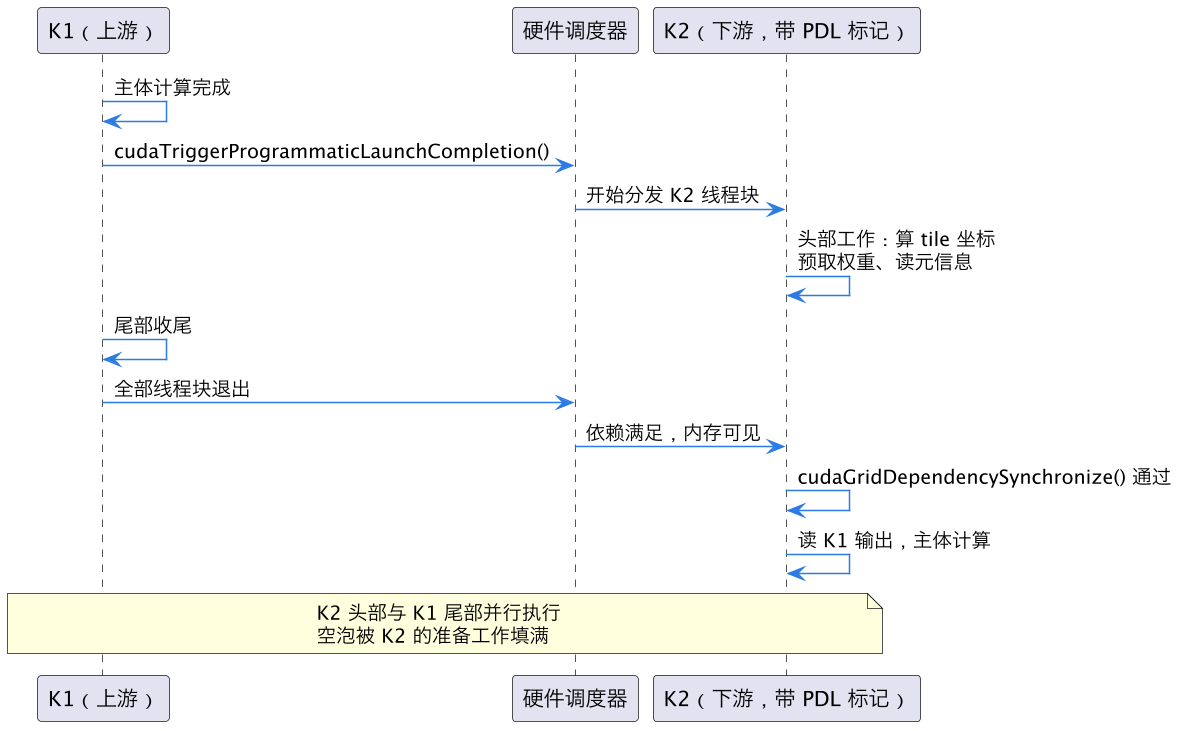
图中可以看到 PDL 的收益来源是两段重叠:K2 的分发和头部工作被塞进了 K1 的尾部窗口。理想情况下,K1 最后一个线程块退出的瞬间,K2 的所有线程块已经在 SM 上就位、闸门一开立刻开始主体计算——空泡被压到接近零。一个容易被误读的点:trigger 的调用位置由程序员决定,但正确性不依赖它。trigger 调早了(比如数据还没写完就调),唯一的后果是下游提前上来、然后在 synchronize 闸门处多等一会,绝不会读到脏数据——因为闸门等的是「K1 全部退出」这个硬件事件,不是 trigger 信号。这个「trigger 只影响性能、synchronize 保证正确」的不对称设计,是 PDL 敢放进通用编程模型的底气。
三、代码长什么样:一对 kernel 的改造过程
把上面语义落成 CUDA 代码,上下游各改一处,launch 时加一个属性。
上游 kernel 的改动是在合适位置发 trigger。典型位置是「所有写全局内存的操作都已发起」之后——对 GEMM 来说通常是最后一个 tile 的 store 之后:
__global__ void producer(float* out, ...) {
    // 主体计算,写 out
    compute_and_store(out, ...);
    // 告知硬件:下游可以开始上来了
    cudaTriggerProgrammaticLaunchCompletion();
}
下游 kernel 的改动是把准备工作挪到闸门之前、把读上游数据的部分放在闸门之后:
__global__ void consumer(const float* in, const float* weight, float* out, ...) {
    // 闸门之前:只碰常量和自己的元信息
    int tile = compute_tile_index();
    const float* w = prefetch_weight(weight, tile);  // 权重不依赖 in

    // 闸门:等待上游全部完成
    cudaGridDependencySynchronize();

    // 闸门之后:可以安全读 in
    out[tile] = reduce(in, w, tile);
}
发射侧用 cudaLaunchKernelEx 带属性:
cudaLaunchConfig_t cfg = {};
cudaLaunchAttribute attrs[1];
attrs[0].id = cudaLaunchAttributeProgrammaticStreamSerialization;
attrs[0].val.programmaticStreamSerializationAllowed = 1;
cfg.attrs = attrs;
cfg.numAttrs = 1;
cudaLaunchKernelEx(&cfg, consumer, in, weight, out, ...);三个细节值得强调。其一,PDL 是相邻 kernel 之间的链式机制:stream 上 K1→K2→K3 都带 PDL 标记,重叠会一级级传下去,每个 kernel 都在做「等上游 trigger 就上来、自己完事发 trigger 给下游」。其二,trigger 由 kernel 内任意线程调用即可,硬件按 grid 粒度聚合语义——实际写法里常让每个线程块都调,硬件保证「最后一个调用生效」。其三,PDL 要求 compute capability 9.0(Hopper)及以上;Ampere 及更早架构上这个 launch attribute 被忽略,退化成普通串行发射——代码能跑,只是没有收益,这也让框架可以无分支地给所有 kernel 挂 PDL 标记。
四、什么样的 kernel 对吃得到肉:三个判据
PDL 不是所有 kernel 对都值得开。实务上按三个判据筛。
判据一:下游 kernel 要有足够多的「头部工作」。如果 K2 一上来第一行就读 K1 的输出(比如 elementwise 的 y = f(x)),那它的头部几乎为空,提前上来也只能干等在闸门处,收益只剩省掉分发延迟的零头。头部肥的 kernel 才划算:GEMM 类 kernel 要读权重(权重是常量,不依赖上游)、算 tile 划分、做 shared memory 的 swizzle 预取——这部分能占整个 kernel 耗时的 10%~30%,尤其 decode 阶段权重读带宽是瓶颈(KV cache 推理显存 分析过 decode 的访存密集特征),把权重预取塞进上游尾部是真金白银。
判据二:kernel 本身要短,间隙占比才高。一个 500 微秒的大 GEMM,省 3 微秒清场时间没有意义。PDL 的主场是小 kernel 密集序列:decode 前向、MoE 路由与 dispatch 之间、norm-activation 这类 elementwise 链。
判据三:上下游 grid 规模要能共存。K2 的线程块提前上 SM,需要 SM 上有空位。如果 K1 尾部仍然把所有 SM 塞得满满当当,K2 的块只能在队列里等——语义没错,但重叠为零。这也是为什么 PDL 和 GEMM 尾波天然合拍:K1 尾波期 SM 恰好半闲,K2 的块正好填进去。
按这三个判据看 decode 前向里的典型 kernel 对:RMSNorm → QKV GEMM 是好对(GEMM 头部肥,权重预取量大);QKV GEMM → RoPE 一般(RoPE 头部薄);attention → output GEMM 是好对;MLP 内部 GEMM → SiLU → GEMM 的链上,第二个 GEMM 吃得到第一个 GEMM 尾波的红利。TensorRT-LLM 在其 in-flight batching 实现 的较新版本里给 decode 路径的 GEMM 系列默认挂上了 PDL,公开 benchmark 报告单步 decode 延迟改善在 5%~10% 区间——这个数字和「500 个 kernel、每个省 2 微秒上下、总延迟省出 1 毫秒级」的估算吻合。
| 判据 | 适合 PDL | 不适合 PDL |
|---|---|---|
| 下游头部工作 | 权重预取、tile 坐标计算占 10% 以上 | 第一行就读上游输出 |
| kernel 时长 | 5~50us 的小 kernel 密集序列 | 数百 us 的大 kernel |
| 上游尾部占用 | 有尾波、SM 半闲 | 全程满占用到最后一刻 |
| 典型场景 | decode 前向、norm-activation 链 | 大 batch prefill 的巨型 GEMM |
五、PDL 与 CUDA Graph:一个管重叠,一个管提交
最常被搞混的问题:有了 CUDA Graph 捕获与回放,为什么还要 PDL?答案是两者消除的开销根本不在同一层。
CUDA Graph 解决的是 CPU 侧提交开销:不用 Graph 时每个 kernel 发射要走一遍 CUDA runtime 的参数校验、驱动调用、doorbell 写,CPU 侧每个 kernel 花 2~5 微秒,小 kernel 序列下 CPU 提交速度跟不上 GPU 消费速度,GPU 空转等下一道命令。Graph 把整串 kernel 录成一张图、一次提交,CPU 开销压到一次 launch 的量级。
但 Graph 回放时,GPU 侧的执行语义没变:图里的节点之间仍然是「前一个彻底结束、后一个才开始」,清场间隙原样保留。而 PDL 改的是 GPU 侧相邻 kernel 的重叠语义。两者是正交的——而且是可以叠加的:Graph 在捕获时会把 stream 上的 PDL launch attribute 一并录进图节点,回放时重叠语义照样生效。
上图是三层演进关系。实务部署的标准形态就是最右列:decode 路径整段录成 Graph(顺带解决 continuous batching 调度器 每步重组 batch 后的重复发射开销),图内符合条件的相邻 kernel 对挂 PDL。两个优化各自的收益量级也常见混淆:Graph 在小 batch decode 下通常省 10%~20% 的端到端延迟(CPU 瓶颈被解除),PDL 在其上再叠加 5%~10%(GPU 间隙被填)。两者不互斥、不重复计算,这也是 TensorRT-LLM 和 SGLang 先后把「Graph 内开 PDL」做成默认开关的原因。
还有一个分工边界值得记住:Graph 管的是「固定形状的 kernel 序列」——decode 的每步形状稳定,所以 decode 是 Graph 的主场;prefill 形状随输入长度变化,Graph 适用性差,PDL 照样可以用(它是逐 kernel 的 launch 属性,不依赖图结构)。反过来,PDL 只影响相邻 kernel,管不了跨 stream 的复杂依赖编排,那仍然是 Graph 和事件的领地。CUDA stream 异步重叠 讲的是多 stream 维度的并行,PDL 则是在单 stream 内部挖出来的第三维重叠,三者各管一段。
六、落地检查单与常见坑
把 PDL 从「知道」变成「用上」,按这个顺序走。
先量化再动手。用 Nsight Systems 或 Nsight Compute 抓一段 decode 时间轴,数两件事:kernel 间隙总时长占整段的比例,以及候选下游 kernel 的头部工作时长(看 kernel 开始后到第一次全局内存读上游数据的间隔)。间隙占比低于 5% 就别折腾了。
改造时三个坑最常见。坑一:闸门位置放错。cudaGridDependencySynchronize 放得太靠后,中间代码偷偷读了上游数据——不会报错,读到的就是脏值,表现为精度偶发劣化,极难查。防御性做法是闸门紧跟在所有「只碰常量」的代码之后,越靠前越安全。坑二:以为 trigger 必须调用。不调 trigger 语义也对,只是重叠窗口退化成「K1 全退才放 K2」——如果上游 kernel 是第三方库里的(cuBLAS 的 GEMM),没法插 trigger,可以靠 grid 末尾隐式触发吃到一部分收益,或者在上游后面插一个几行的 dummy kernel 专门发 trigger。坑三:在满占用大 kernel 后开 PDL。上游尾部 SM 全满,下游块上不来,白白多一次属性检查,虽无正确性问题但别指望收益——这也呼应第四节判据三。
验证收益时对照组要配对:同 batch、同序列长度下「无 PDL 的 Graph 回放」对「带 PDL 的 Graph 回放」,盯单步 decode 延迟和 SM 占用率曲线——看到 K1 尾部与 K2 头部在时间轴上咬合起来,就是成了。
这一篇在知识体系里的位置
本篇是 GPU kernel 调度优化系列的「最后一微米」:上游是 kernel 启动开销与融合(减少 kernel 数量与单次启动成本)、CUDA Graph 捕获与回放(消除 CPU 侧提交开销)、CUDA stream 异步重叠(跨 stream 的并行维度);同层对照 GEMM split-k 与 stream-k 调度(GEMM 内部尾波——PDL 重叠窗口的来源)和 RMSNorm 与 RoPE 融合 kernel(decode 链上的典型节点);下游应用是 TensorRT-LLM in-flight batching 与 continuous batching 调度器 这类 serving 系统怎么把 PDL 加 Graph 变成默认配置。
落地路径建议:先把 decode 路径录成 CUDA Graph 拿掉 CPU 侧开销,再用 Nsight 量化 kernel 间隙占比,超过 10% 就按第四节三个判据筛 kernel 对挂 PDL,闸门位置从严,收益对照 Graph-only 基线量。
总结
PDL 依赖启动是 Hopper 引入的相邻 kernel 重叠机制:下游 kernel 带 cudaLaunchAttributeProgrammaticStreamSerialization 标记发射后,可在上游 cudaTriggerProgrammaticLaunchCompletion 发令时提前上 SM,用 cudaGridDependencySynchronize 闸门划出「此前只碰常量、此后才能读上游数据」的安全线,把权重预取等头部工作塞进上游尾部窗口,吃掉每对 kernel 2~4 微秒的清场空泡——它和 CUDA Graph 是正交互补关系(Graph 消 CPU 提交开销、PDL 消 GPU 执行间隙),在 decode 这种 500 个小 kernel 串成的场景里两者叠加可再压 5%~10% 单步延迟,前提是下游头部够肥、kernel 够短、上游尾部有 SM 空位。