总线带宽性能计数器:拍计数、字节计数、利用率公式与瓶颈定位
更新时间:2026-09-28。本篇是「集成电路大类 · 芯片设计 · 片上总线」序列里的性能量化篇。总线协议本身的时序与突发规则建议先读 AXI4 LEN/SIZE 与拍数计算 和 AMBA 总线性能与面积基准;仲裁公平性对带宽的影响见 Round-Robin 仲裁器公平性。本篇回答一个工程上反复出现的问题:设计评审时说「这条总线够不够宽」到底拿什么数字说话——答案是一组挂在总线上、按拍累加的性能计数器。
本文要回答的问题
- 总线带宽性能计数器到底数什么:拍计数、字节计数、请求计数各自的定义与采样点在哪?
- 带宽、利用率、突发效率三个公式怎么从计数器原始值推导,单位怎么换算?
- 利用率 80% 和利用率 30% 都可能不健康,怎么结合停顿计数区分「主供不上」与「从不收下」?
- 用计数器数据定位瓶颈的标准流程是什么,先怀疑谁、再怀疑谁?
- 定位到瓶颈之后,加宽、加深 outstanding、改突发、改仲裁各能解决哪类问题?
一、为什么需要计数器:带宽争论的终结者
SoC 评审会上最常见的争论是「DDR 控制器到 NoC 的这条路会不会成为瓶颈」。没有数据的时候,各方只能拿峰值带宽互相压:128 bit 总线跑 1 GHz,理论峰值 16 GB/s,看上去绰绰有余。但峰值是「每一拍都在传有效数据」的理想值,真实总线上有空闲拍、有反压拍、有主机发不出数据的等待拍,还有读写切换的死时间。实测有效带宽常常只有峰值的 40%-70%,而这个比例每个 SoC、每个工作负载都不一样。
总线带宽性能计数器(bus bandwidth performance counter)就是把「每一拍总线在干什么」量化成可读寄存器的一组硬件:它不参与功能逻辑,只在总线接口上旁观握手信号,按拍累加。验证阶段它证明性能达标,硅后调试阶段它是定位性能塌方的第一手证据。CPU 侧的同类思想是 PMU(性能监控单元),软件侧怎么读这类硬件事件可看 perf events 事件体系;片上总线计数器更简单——没有超标量那种事件组合爆炸,核心事件一双手数得过来。
图里最关键的一点是探头「纯旁观」:它只采样 valid/ready/last 这类已有信号,绝不允许反向驱动总线,否则一个调试组件就可能改变被测系统的时序行为——观测者效应在 RTL 里同样成立。探头一般做成可例化的 wrapper,套在 master 出口或 slave 入口;配置口挂到 APB 这类低速总线上,软件或仿真里的 testbench 周期性读数。
二、数什么:四类基本计数
一套够用的总线计数器只需要四类原始计数,其余指标全部派生:
| 计数 | 采样条件(以 AXI 为例) | 含义 |
|---|---|---|
| 总拍数 total_cycles | 每个时钟沿 +1 | 统计窗口的分母 |
| 有效拍数 transfer_beats | VALID && READY 的拍 | 真正传数据的拍 |
| 停顿拍 stall_cycles | VALID && !READY | 从机反压、数据滞留 |
| 空闲拍 idle_cycles | !VALID | 主机没发请求 |
| 字节数 byte_count | 有效拍 × 每拍字节 | 折算带宽的分子 |
| 请求数 trans_count | 地址通道完成一次握手 | 突发笔数 |
注意三类拍互斥且完备:任意一拍要么在传数、要么被反压、要么空闲,三者相加等于总拍数。这个完备性检查本身就是计数器 RTL 的自检手段——仿真里加一个断言,三者之和若不等于 total,说明采样逻辑有 bug。
字节数这一行要单独解释:AXI 的每拍字节数由 AxSIZE 决定,W 通道则固定等于总线数据位宽(WSTRB 全 1 时)。精确的 byte_count 应当在每个有效拍上累加 1 << AxSIZE(对 R/W 数据通道而言是总线宽度减去 WSTRB 空洞),粗颗粒的实现直接按总线满宽折算,结果会高估 5%-15%,做跨设计对比时必须先对齐口径。笔数 trans_count 配合拍数可以反推平均突发长度:avg_burst_len = transfer_beats / trans_count,这个比值是后面算突发效率的输入。
三、三个核心公式:带宽、利用率、突发效率
从原始计数到结论,中间只隔三个公式。
有效带宽 = byte_count × f_clk / total_cycles。例:统计窗口 100 万拍、累计字节 8 MB、时钟 1 GHz(每拍 1 ns,窗口 1 ms),有效带宽 = 8 MB / 1 ms = 8 GB/s。
总线利用率 = transfer_beats / total_cycles。它是「数据通道有多少拍在干活」。上例若总线 128 bit(每拍 16 B),100 万拍满负荷可传 16 MB,实际传了 8 MB,利用率 50%。
突发效率 = transfer_beats / (trans_count × 协议允许的最大拍数)。它回答「主机有没有把突发用满」。AXI4 最大 256 拍,如果实测平均突发只有 4 拍,地址握手开销和读写切换开销就把带宽吃掉了——后面会看到这是最常见的调优点。
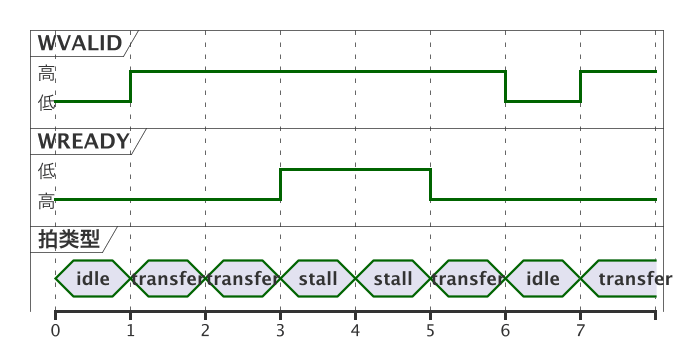
按这张波形数一遍:8 拍窗口里 transfer 4 拍、stall 2 拍、idle 2 拍,利用率 4/8 = 50%,而从机反压造成的停顿占 25%。如果只看「带宽 8 GB/s」这一个数,你分不清是主机懒得发(idle 多)还是从机吃不下(stall 多)——这两种病的药方完全相反,所以 stall 与 idle 必须分开计数,这是计数器设计里最容易被省掉、也最容易让人返工的一组寄存器。
四、读数怎么读:利用率的健康区间
经验上,共享总线的利用率落在三个区间含义不同:
| 实测利用率 | 含义 | 动作 |
|---|---|---|
| < 30% | 总线过宽或主机没喂饱 | 检查主机 outstanding、突发长度;可考虑降位宽省面积 |
| 30%-70% | 健康工作区 | 记录基线,回归对比 |
| > 70% | 排队延迟开始非线性增长 | 看 stall/idle 构成,定位谁在拖 |
| > 90% 持续 | 拥塞,延迟雪崩 | 必须扩容或分流 |
为什么是 70% 而不是 100% 才报警?因为请求到达是突发的(排队论的 M/D/1 模型),利用率超过拐点后平均延迟按 1/(1-ρ) 上涨,70% 时延迟已是空载的 3 倍多,95% 时是 20 倍。实时性敏感的通路(显示控制器取帧、音频 DMA)宁可让利用率压在 50% 以下换确定性延迟,这与「榨干带宽」的批量通路(视频编码写回)是两种优化目标,计数器数据要分通路采集、分目标评判。
多主共享的场景还要按 HMASTER/AxID 分桶统计:总利用率 60% 可能是「一个主占 95%、其他主饿死」的假象平均。分桶计数器成本高,折中做法是只给带宽需求最大的两三个 master 配独立计数,其余合并统计——公平性问题则交给 Round-Robin 仲裁器公平性 里讲的仲裁侧手段。
五、瓶颈定位流程:从计数器到嫌疑犯
拿到一组不健康的读数后,按固定顺序排查,不要跳到结论:
流程背后的逻辑是「停顿方向即瓶颈方向」。stall 高说明数据压在总线上等从机,瓶颈在下游:典型原因是 DDR 控制器命中率低(bank conflict、行切换频繁)、刷新吃掉窗口、或者 AXI 到 APB 之类的桥根本喂不饱。idle 高说明总线空转等主机,瓶颈在上游:outstanding 配小了(延迟 × 带宽积装不满,比如往返 200 ns × 8 GB/s 需要 1600 B 在途数据,outstanding 只够 512 B 就永远到不了峰值)、突发太短、或者主机内部流水有气泡。
两个方向之外还有两类「隐性瓶颈」。其一是桥接级联损耗:数据从 AXI 过异步桥到 AHB 再到 APB,每级桥都有握手开销和位宽折算,端到端效率是各级效率的乘积,三级 90% 相乘只剩 73%——跨时钟域桥的影响可对照 异步 FIFO 与 CDC 的思路分析。其二是读写切换死时间:DDR 总线上读转写要插总线翻转周期,主机读写交替密集时这个开销能吃掉 10%-20%,靠计数器分别统计读通道与写通道利用率、再看时间轴上的交替频率,就能把它量化出来。
六、调优手段与计数器的闭环
定位到原因后,手段与病因是一一对应的:
| 计数器症状 | 病因 | 调优手段 | 预期读数变化 |
|---|---|---|---|
| idle 高、平均突发 4 拍 | 突发太短 | 主机改 INCR16/合并请求 | 突发效率升、idle 降 |
| idle 高、outstanding=2 | 在途数据不足 | outstanding 提到 8-16 | 有效带宽逼近延迟带宽积 |
| stall 高、DDR 效率低 | bank 冲突/刷新 | 地址交织、刷新调度 | stall 降 |
| 多主时某主 idle 100% | 仲裁饿死 | 加权 RR/QoS 整形 | 分桶利用率均衡 |
| 全链路指标都好仍不够 | 位宽不足 | 升位宽或换 NoC | 峰值上限抬高 |
每一轮调优都要回到计数器读数验证,形成「测量→假设→修改→再测量」的闭环——这正是把性能计数器留在量产硅片里而不只是仿真用的理由:仿真激励是合成的,真实工作负载(操作系统调度下的 cache miss 风暴、摄像头 ISR 与显示刷新的撞车)只有硅后计数器能抓到。实际项目里常见的做法是给关键通路留一组可配置的窗口寄存器(软件写起始、计数器在窗口内累加、溢出中断通知),驱动层定时采样上报,性能回归就有了持续数据源。大规模 NoC 里这套机制进一步演化成分布式性能监控,拓扑侧的背景见 片上网络路由器。
这一篇在知识体系里的位置
协议层的拍数与字节数怎么算,见 AXI4 LEN/SIZE 与拍数计算;总线方案选型时的性能/面积基线见 AMBA 总线性能与面积基准;多主争用下的公平性机制见 Round-Robin 仲裁器公平性;跨时钟域桥的握手损耗见 异步 FIFO 与 CDC;更大规模的片上互连见 片上网络路由器。
总结
总线带宽性能计数器在接口上纯旁观地按拍累加四类原始计数——总拍数、有效拍、停顿拍、空闲拍(外加字节数与请求数),由此推出有效带宽 = 字节数 × 频率 / 总拍数、利用率 = 有效拍 / 总拍数、突发效率 = 实际平均突发 / 协议上限;诊断的核心是把停顿与空闲分开看:stall 高瓶颈在下游从机,idle 高瓶颈在上游主机的 outstanding 与突发长度,利用率超 70% 排队延迟开始非线性恶化;调优按「测量→假设→修改→再测量」闭环,手段与病因对应——加突发、加 outstanding、改地址映射、改仲裁、升位宽,每一步都用计数器读数验证。