GBA PBA 分析模式:graph-based 与 path-based 的悲观度差多少、怎么搭配用
PrimeTime 签核流程讲过黄金 STA 怎么建 timing graph、怎么跑 MMMC 多场景;MMMC 与 OCV/寄生讲过降额与寄生角的口径。本篇往下钻一层:同样一张 timing graph,GBA PBA 分析模式——graph-based(基于图)与 path-based(基于路径)——在到达时间怎么传播上走的是两条路,直接决定了报告的悲观度和跑一次要多久。搞不清两者的差异,要么在实现期被假违例拖死,要么在签核期把真实违例放过去。
本文要回答的问题
- GBA 和 PBA 在 timing graph 上的计算方式到底差在哪一步?
- GBA 的悲观度从哪来,为什么收敛点会「假性变红」?
- PBA 为什么更准,代价是什么,能不能全量跑?
- 实现期、收敛期、签核期分别该用哪种模式?
- 两种模式报告出来的 slack 差多少算正常?
一、两种模式在图上做了什么
静态时序分析把网表建成一张 timing graph:节点是引脚,边是单元延迟和线延迟,分析就是在这张图上传播到达时间(arrival time)。分歧发生在有多个输入汇聚的节点——比如一个多路选择器的输出、或时钟树上分叉后再汇合的点。
GBA(graph-based analysis)在汇聚点只保留一个最坏值:setup 分析取所有输入里的最晚到达时间,hold 取最早。之后无论有多少条路径从这个点往后走,它们都被迫继承这同一个「最坏前缀」。PBA(path-based analysis)不合并——它沿着每一条具体的路径重新算,每条路径保留自己的真实前缀,丢弃那些在汇聚点被「别人的最坏值」污染的部分。
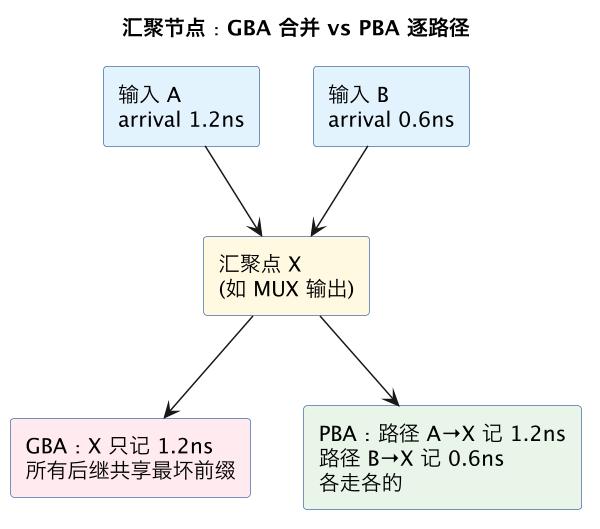
上图是全部差异的原点:GBA 为了内存和速度把汇聚点压缩成一个标量,PBA 为了精度保留逐路径的向量。后面的所有现象——悲观度、运行时间、内存——都是这一个选择的推论。
二、GBA 的悲观度从哪来
GBA 的悲观有两个独立来源,要分开看。
来源一:前缀污染(拓扑悲观)。 如上图,路径 B→X 的真实到达时间是 0.6ns,但 GBA 让它继承 1.2ns 的最坏前缀。如果 B→X 之后还有三级逻辑才到终点触发器,这三级延迟会被叠加在错误的 1.2ns 上,报出的 slack 比真实情况差。时钟路径上同理:发射时钟和捕获时钟共享的公共段,GBA 用最晚/最早分别填充,把本不该存在的偏斜算进去——这就是为什么 PrimeTime 签核里 CRPR(clock reconvergence pessimism reduction,时钟重汇聚悲观度削减)是必须开的修正项,它专门把时钟公共段的重复扣减抵掉。
来源二:与 OCV 降额的叠加放大。 在 MMMC 与 OCV的框架下,每个单元还要乘降额系数。GBA 的最坏前缀本身已经偏保守,再被数据路径 derate 放大一遍,误差沿路径长度累积。路径越深、汇聚点越多,GBA 相对 PBA 的额外悲观就越大。
下面这张表是同一设计在同一 SS 角下、同一 session 里两种模式的典型对比(16nm 级别、约 80 万实例的模块,数值为经验量级):
| 指标 | GBA | PBA(exhaustive) |
|---|---|---|
| 单次运行时间 | 基准 1× | 3×–10×,深度路径更多 |
| 峰值内存 | 基准 1× | 2×–4× |
| setup WNS | 偏悲观 20–80ps | 接近真实 |
| 违例路径数 | 偏多(含假违例) | 通常减少 5%–30% |
| 适用阶段 | 实现期快速迭代 | 收敛后期与签核 |
要注意这个差值高度依赖设计结构:数据通路里 MUX 多、时钟树分叉再汇合多的设计,GBA 悲观度大;结构规整的流水线设计两者差距可以小到几个 ps。所以「差多少算正常」没有通用答案,但有一条判据:如果 PBA 回收的违例超过 30%,说明设计里汇聚结构很重,实现期的 GBA 报告要打折看。
三、PBA 为什么贵,以及怎么用得起了
PBA 的开销来自路径枚举。一张有 N 个汇聚节点的图,逐路径计算的空间复杂度最坏是指数级的——这是教科书结论,但工程上没人真的全量枚举,工具靠的是两条折中。
折中一:只重算受影响的终点。 PrimeTime 的用法不是全局切模式,而是在 GBA 报告的基础上做路径级重算:
# GBA 全量报告(快,先拿到全局图景)
report_timing -delay max -max_paths 1000 -nworst 10

# 对违例终点做 PBA 精算(慢,但只算这几条)
report_timing -delay max -pba_mode path -max_paths 200
report_timing -delay max -pba_mode exhaustive -max_paths 50
pba_mode path 只对报告到的具体路径重算,便宜;pba_mode exhaustive 会对每个终点的所有可能路径做穷举式搜索,保证拿到该终点真实的最差 slack,最贵。Tempus 里对应 set_analysis_mode -cppr 加重算选项,思路相同。
折中二:把 PBA 当「筛子」而不是「地毯」。 工程流程是:GBA 报出 1000 条违例 → PBA path 模式重算,砍掉假违例剩 700 条 → 对其中 slack 在临界值附近(比如 -30ps 以内)的 50 条跑 exhaustive 确认真实余量。计算量集中在刀刃上。
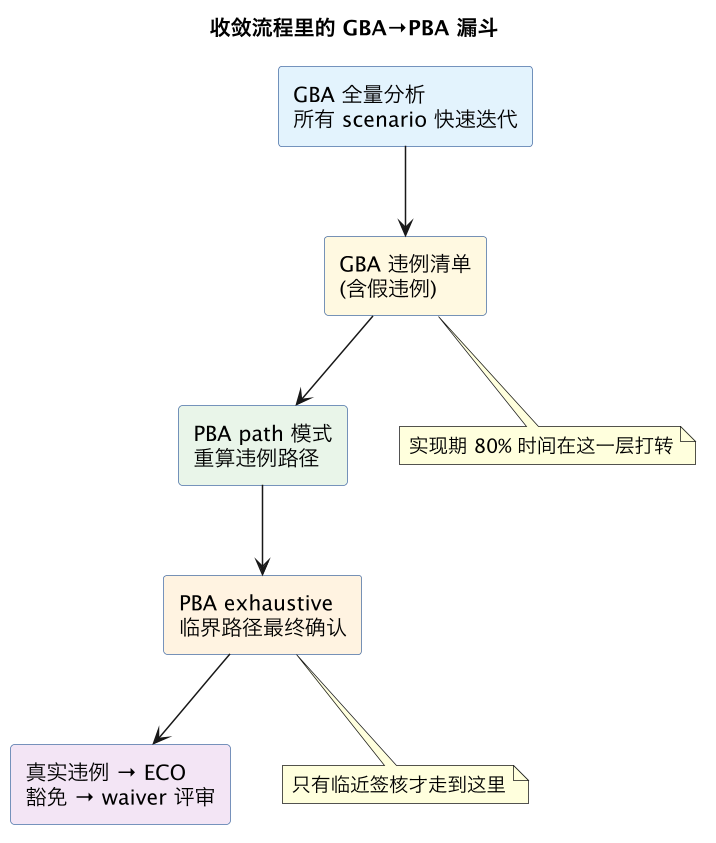
这个漏斗的关键认知是:PBA 不能替代 GBA,只能跟在 GBA 后面做精算。全量 PBA 跑一次的时间足够 GBA 迭代十几轮,而实现期的违例大多靠修约束、修 floorplan、修 CTS 解决,根本不需要路径级精度。
四、实现期与签核期怎么搭配
经验上的分工非常稳定:
- 综合与布局布线期:实现工具内部(Innovus/ICC2 的优化引擎)几乎全在 GBA 口径下工作,因为它要给成千上万条路径同时做增量评估,速度是第一位。这一阶段的违例数字偏大是常态,别拿它当签核判据。
- 收敛后期(违例收敛到百条量级):引入 PBA path 模式甄别假违例。常见收益是违例数直接掉一到两成,省掉一批无效 ECO。同时确认 CRPR 已开,否则时钟公共段的悲观还在。
- 签核期:黄金 STA(PrimeTime/Tempus)在每个 MMMC 场景下跑 GBA 出全量报告,再对所有违例终点做 PBA exhaustive 终验。最终签收以 PBA 结果为准——foundry 和设计规则手册认可的签核口径就是路径级精度,GBA-only 的签收在先进节点不被接受。
- ECO 回归:每轮 ECO后先 GBA 快速回归确认没有炸出新违例,再对受影响终点补 PBA,避免每轮都付全量精算的成本。
一句话概括取舍:GBA 买的是迭代速度,PBA 买的是报告真实性;流程设计的目标是用尽量少的 PBA 计算量,把 GBA 的假悲观挤干净。
五、常见翻车点
| 事故 | 根因 | 拦截动作 |
|---|---|---|
| 实现期追一堆假违例 | 把 GBA 数字当真 | 违例进 ECO 前先 PBA 筛 |
| 签核时 PBA 跑不动 | 全量 exhaustive 无剪枝 | 漏斗式只对违例/临界路径算 |
| GBA 绿 PBA 红 | 漏 scenario 或约束不一致 | 两模式同 session 同约束对账 |
| PBA 收益异常大(>30%) | 时钟结构汇合多/CRPR 没开 | 查 CTS 结构与 CRPR 开关 |
| hold 只验 GBA | hold 同样有前缀污染 | hold 的临界路径也要 PBA |
最后一行容易被忽略:多数团队只给 setup 跑 PBA,但 hold 检查里 GBA 取最早到达时间的做法同样会产生假违例,只是悲观方向相反。先进节点 hold 余量本来就薄,临界 hold 路径不过一遍 PBA,等于留了一个签核盲区。
这一篇在知识体系里的位置
本篇是 黄金 STA 签核的纵深补充:那篇讲 STA 的输入、构图与报告读法,本篇专讲计算模式这一个旋钮。悲观度的另一半来源——OCV/AOCV/POCV 降额与寄生角——在 MMMC 与 OCV/寄生;两种模式筛完的真实违例怎么修,接 签核收敛与 ECO;签核在整个数据流里的枢纽位置见 S5 签核枢纽。
总结
GBA 在汇聚点把多条路径压成一个最坏值、用精度换速度,PBA 逐路径保留真实前缀、用算力换真实性;工程上的正确姿势是 GBA 打全场做快速迭代、PBA 跟在违例后面做漏斗式精算,签核终验以 PBA 为准,setup 和 hold 的临界路径都别漏。