时钟门控 RTL 写法对照:使能寄存器与门控时钟 yosys 综合面积实测
更新时间:2026-10-25。本文是「集成电路大类 · 芯片设计」中间层(intermediate)的一篇实验文。低功耗设计入门 讲过动态功耗正比于「翻转率 × 电容 × 电压平方 × 频率」,时钟门控(clock gating)是降翻转率的第一手段;UPF 与功耗域设计 讲的是更粗粒度的整域断电。本篇聚焦最细粒度的一个问题:**同一个带使能的寄存器,「数据端选通」和「时钟端门控」两种 RTL 写法,综合出来的电路差多少?**用 yosys 对两份等价功能的源码各综合一遍,让 stat 报告给答案。
本文要回答的问题
- 「使能寄存器」写法在综合后到底长什么样?那 8 个 MUX 从哪来?
- 「门控时钟」写法的电路结构差在哪,为什么单元数能少将近一半?
- 既然门控时钟又小又省功耗,为什么工程上还强调要用专门的 ICG 单元而不是手写 AND 门?
- yosys 这种通用综合流程会自动把使能写法转换成门控写法吗?
先给结论卡,四个数字全部来自后文真实综合报告:
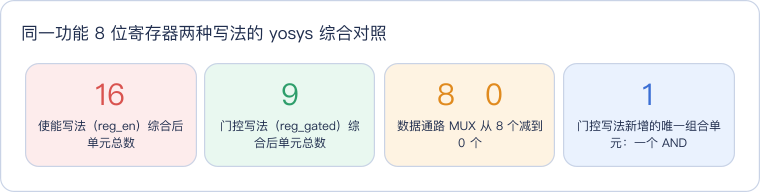
读这张卡抓一个对照:两种写法功能完全等价(en 为高时寄存器更新、为低时保持),但使能写法综合出 8 个 DFF + 8 个 MUX 共 16 个单元,门控写法是 8 个 DFF + 1 个 AND 共 9 个单元——省掉的 7 个单元全是数据通路上的 MUX。面积差异是其次,真正的收益在功耗:使能写法里时钟每个周期都在翻转所有 DFF 的时钟端,门控写法里 en 为低时时钟干脆不到达寄存器。下面从原理讲起。
一、两种写法的电路结构差异
先看写法 A,教科书里最标准的带使能寄存器:
// 写法 A:使能寄存器(数据端选通)
always @(posedge clk or negedge rst_n) begin
    if (!rst_n)  q <= 8'd0;
    else if (en) q <= d;
end
这段代码的语义是「en 为低时 q 保持原值」。寄存器没有「保持」这个硬件动作——保持只能靠把旧值再写回去。综合器因此在每个 DFF 的 D 输入前插一个二选一 MUX:en 为高选新数据 d,en 为低选回自己的输出 q。8 位寄存器就是 8 个 MUX,这就是 stat 报告里 $_MUX_ 8 的来历。
写法 B 换一条路:不动数据,动时钟。
// 写法 B:门控时钟(时钟端切断)
wire gclk = clk & en;   // 简化的 ICG 模型
always @(posedge gclk or negedge rst_n) begin
    if (!rst_n) q <= 8'd0;
    else        q <= d;
end
en 为低时 gclk 恒为 0,寄存器根本收不到时钟沿,D 端是什么都无所谓——不需要 MUX 反馈,数据通路直连。两种写法的结构对照用一张图看(红色是使能写法的功耗弱点,绿色是门控写法的省电点):
读这张图抓住主线:A 的使能逻辑在数据通路上、按位重复 8 份;B 的使能逻辑在时钟通路上、全局只有 1 份。寄存器位宽越大,这个「按位 vs 全局」的差异越悬殊——32 位总线接口寄存器用写法 A 就是 32 个 MUX,写法 B 还是 1 个门控单元。功耗上更关键:CMOS 电路的动态功耗大头在时钟树和触发器时钟端的充放电,A 写法时钟永远满载翻转,B 写法在 en 为低的周期里整段时钟子树静止——低功耗设计里「门控越早关、关得越高层越省」的原则就来自这里。
二、yosys 实测:16 个单元对 9 个单元
两轮综合真实执行实录如下(截取尾部单元类型对照与判定段):
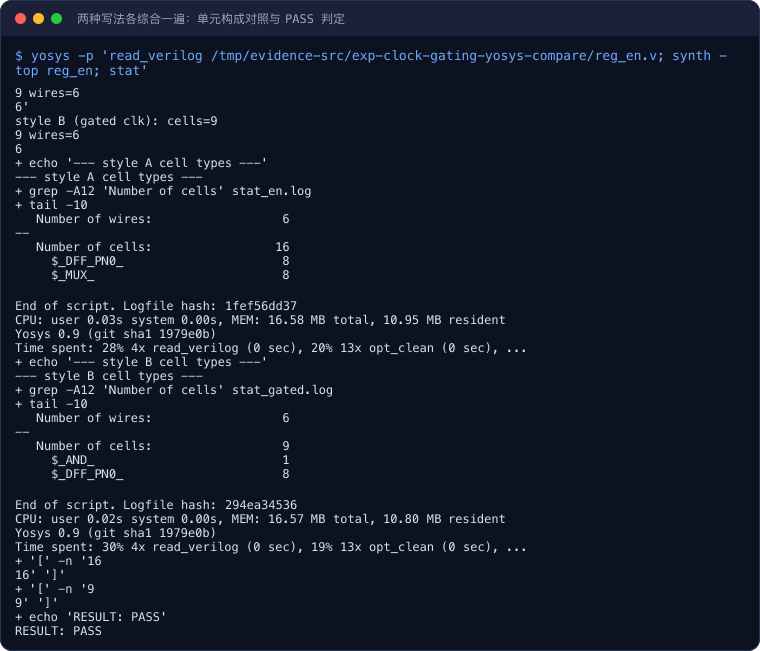
读这份实录抓三行:style A (enable) 行 cells=16、style B (gated clk) 行 cells=9;下面两段 cell types 是铁证——A 的构成是 $_DFF_PN0_ 8 加 $_MUX_ 8,B 的构成是 $_DFF_PN0_ 8 加 $_AND_ 1。MUX 一个不多一个不少正好 8 个,与 8 位位宽严格对应,这就是「理论解释与实测数字咬合」的样子。末尾 RESULT: PASS 表示两份 stat 报告都成功生成。
把两轮报告的关键段原样摘录(A 写法的 ABC 映射结果能看到 8 个 MUX 是映射阶段的真实产物,不是统计幻觉):
=== reg_en ===
   Number of cells:                 16
     $_DFF_PN0_                      8
     $_MUX_                          8

=== reg_gated ===
   Number of cells:                  9
     $_AND_                          1
     $_DFF_PN0_                      8
摘录里还有个容易滑过去的细节:两份报告的 Number of wires 都是 6,完全一样。门控省的不是连线而是单元类型——MUX 换成 AND,线网拓扑规模没变。这提醒我们读 stat 报告时别只看总数一行,单元构成清单(哪些类型各几个)才是结构信息所在。
值得停下来想的一点是 DFF 数量:两种写法都是 8 个 DFF,一个都没少。门控省的是组合逻辑和时钟翻转,触发器本体(功能要存的 8 个 bit)谁也省不掉。所以「时钟门控能省多少面积」的正确预期是:省掉与被门控位宽成正比的 MUX/反馈逻辑,外加一个门控单元的固定成本;位宽 ≥4 时这笔账就稳赚。对 1 位寄存器做门控反而亏——1 个 AND 换 1 个 MUX 没省面积,还引入时钟树复杂度。工业界的经验阈值大致是「同一份使能信号控制 ≥3~4 个触发器时才值得门控」,本次 8 位实测 16 对 9 的差距正好落在这个定量判断上。
还有一个日志细节值得点名:写法 A 的 ABC 映射段输出 MUX cells: 8 / input signals: 17(17 = 8 位 d + 8 位 q 反馈 + 1 位 en),写法 B 的映射段是 AND cells: 1 / input signals: 2——两个输入就是 clk 和 en,门控结构的极简在映射报告里也一览无余。
三、从面积到功耗:这笔账怎么算完整
本次 stat 报告只给了面积维度的数字,但时钟门控的主战场是功耗,这里把功耗账补全,免得读者拿着「省了 7 个单元」就去汇报收益。动态功耗的公式是 P = α · C · V² · f,时钟门控打的是 α(翻转率)这个因子。写法 A 里,不管 en 高低,8 个 DFF 的时钟端每个周期都完成一次充放电,时钟树到这些触发器的整段子树都在翻转;写法 B 里 en 为低的周期,gclk 恒为 0,这段子树的 α 直接归零。如果应用场景里寄存器平均十个周期才更新一次(使能占空比 10%),门控能把这条支路的时钟功耗砍掉约九成——这通常是一个模块里最大的一块动态功耗。
但门控不是白捡的。那 1 个 AND(真实设计里是 1 个 ICG 单元)自己也耗电,还给时钟树加了一级延迟。所以存在一条盈亏平衡线:同一份使能信号控制的触发器越多、en 为低的时间占比越高,门控越赚。这就是主流综合器自动门控都带 -min_bitwidth 阈值参数的原因——默认值常见 3 或 4 位,低于这个宽度插入门控单元反而净亏。本次实验 8 位寄存器、16 对 9 的单元差距,只是这条定量曲线的横轴上一个点;把 reg_en 改成 32 位再跑一遍,A 的 MUX 会变成 32 个、B 仍然是 1 个 AND,差距拉成 40 对 9,这个实验留给读者复现,改一行位宽参数即可。
另一个实操视角是验证成本。写法 A 是纯同步逻辑,仿真和形式验证都毫无障碍;写法 B 引入了一个新的时钟域(gclk),时钟域交叉检查、静态时序分析都要把它当独立时钟处理。工程上这也是「让综合器插 ICG」路线胜出的原因之一——工具插入的门控在网表里带标准属性,STA/CDC 工具认识它;手写 clk & en 的门控,验证工具只能把它当一个普通的、来路不明的时钟,报告里的警告够你追半天。
四、别手写 AND 门:ICG 与毛刺问题
看到这里容易产生一个危险的想法:既然 clk & en 就能门控,工程代码里直接写 AND 不就行了?不行。本文的写法 B 是教学简化的门控模型,真实芯片里手写 clk & en 有两个致命问题。
第一是毛刺。en 如果是组合逻辑输出、在 clk 高电平期间变化,AND 输出会出现窄脉冲,寄存器采到半个时钟沿——数据损坏且极难复现。工业做法是换用工艺库里的 ICG(Integrated Clock Gating,集成时钟门控单元):内部一个低电平有效的 latch 先把 en 锁存到 clk 低电平窗口,再和 clk 相与,保证门控后的时钟沿永远完整。第二是时钟树。手写 AND 生成的是普通数据网络,后端时钟树综合(CTS)不认识它,gclk 的偏斜(skew)没人管;声明为时钟门控单元后 CTS 会把它当时钟树的一部分处理。
工程代码的正确姿势是继续写写法 A 那种使能寄存器,然后让综合工具自动把「en 控制的一组 DFF」转换成「ICG + 直连 DFF」——这叫自动时钟门控插入,主流综合器在约束里设一个位宽阈值(比如 -min_bitwidth 4)就会做。也就是说:RTL 层面写法 A 是标准输入,写法 B 的结构是综合器替你生成的输出。本次实验里 yosys 的通用 synth 脚本没有自动门控插入 pass(0.9 版流程里不含这一步),所以两种写法在报告里保持了原始的形态差异——这恰好让教学对照更干净。功耗数字的量化评估(翻转率怎么折算成功率)在 功耗分析方法论 里有完整展开。
落到自查清单上:
| 检查项 | 正确做法 | 反例 |
|---|---|---|
| RTL 写法 | 带使能寄存器(写法 A) | 手写 clk & en 进 always 块 |
| 门控单元来源 | 工艺库 ICG,综合器自动插入 | 行为级 AND 门 |
| 门控粒度 | 同一份 en 控制 ≥4 位才门控 | 给单个 1 位标志寄存器配门控 |
| 验证关注点 | en 变化窗口与 clk 相位的覆盖 | 只验功能不验门控时序 |
这一篇在知识体系里的位置
- 功耗理论承接:低功耗设计入门(动态功耗公式与降翻转率手段全景);
- 粗粒度配套:UPF 与功耗域设计(整域断电与保持寄存器,门控是域内细粒度手段);
- 量化分析延伸:功耗分析方法论(翻转率到功耗数字的折算流程);
- 时钟基础:时钟与复位基础概念(时钟树、偏斜等入门概念)。
一句话总结
同一个 8 位使能寄存器两种写法 yosys 实测:数据端选通综合出 8 DFF + 8 MUX 共 16 个单元,时钟端门控是 8 DFF + 1 AND 共 9 个单元——门控省掉的是与位宽成正比的 MUX 和 en 为低时的全部时钟翻转;但工程上别手写 AND 门,写使能寄存器、让综合器插工艺库 ICG,才是又省又安全的标准姿势。
实验环境
- 机器/系统:云主机 S6.4XLARGE32 16C32G / Ubuntu 22.04(eda-golden-v1 镜像)
- 工具版本:Yosys 0.9 (git sha1 1979e0b)(照抄日志头部真实输出)
- 日期:2026-10-25
- 完整命令:
bash run.sh(内部依次执行yosys -p 'read_verilog reg_en.v; synth -top reg_en; stat'与yosys -p 'read_verilog reg_gated.v; synth -top reg_gated; stat',随后 grep 两份 stat 报告的 cells/wires 并打印单元类型对照)
代码获取
两份 RTL 源码与运行脚本已同步到公开仓库:geek-doc.cn/experiments/exp-clock-gating-yosys-compare,克隆后进入该目录执行 bash run.sh 即可复现本文全部结果。