Mooncake KV 传输层:PD 分离架构里 KV 搬运的设计与带宽瓶颈
更新时间:2026-10-07。前面 chunked prefill 与 PD 分离 讲过为什么要把 prefill 和 decode 拆到两组机器上,分离式推理集群 讲过集群层面的角色划分。这两篇都有意绕开了一个硬核问题:prefill 节点算出来的几十上百 MB 的 KV Cache,到底怎么搬到 decode 节点?这一篇就钻进这个缝隙,拆解月之暗面(Moonshot AI)开源的 Mooncake 系统里 Mooncake KV 传输层 的设计、它怎么用 RDMA 打满网卡,以及什么时候带宽会成为整个集群的新瓶颈。
本文要回答的问题
- Mooncake KV 传输层在整个 PD 分离架构里处在什么位置,解决什么具体痛点?
- Transfer Engine 的分层设计是怎样的,为什么说它是「以 KV Cache 为中心的分布式缓存」?
- 一次 KV 搬运的完整路径经过哪些环节,RDMA 和 GPUDirect 各自省掉了什么?
- 带宽瓶颈怎么量化测算:多大的集群、多长的上下文会把网络打满?
- 传输层有哪些可调的旋钮,瓶颈出现时先动哪个?
一、为什么 PD 分离之后,KV 传输成了新主角
在合并部署(prefill 和 decode 在同一组 GPU 上交替执行)里,KV Cache 算出来就留在本地显存,网络只需要搬运请求和输出文本,流量小得可以忽略。一旦按 chunked prefill 与 PD 分离 的思路把两种负载拆开,账就变了:prefill 节点每完成一个请求,就要把该请求全部层、全部 token 的 KV 数据跨网络送到某个 decode 节点,这个量是多少?
算一笔具体的账。一个 70B 级别模型,80 层、KV 头数 8(GQA)、头维度 128、FP16 存储,那么每 token 的 KV 大小是 2(K 和 V)× 80 层 × 8 头 × 128 × 2 字节 ≈ 327 KB。一个 8K 上下文的请求,KV 总量就是约 2.6 GB。prefill 节点每秒完成 2 个这样的请求,就需要向 decode 侧持续输出 5.2 GB/s,即 41.6 Gbps 的有效带宽——这已经顶到一张 100G 网卡的半血,而且还没算请求排队时的突发。
这就是 Mooncake KV 传输层要解决的问题:KV 流量不是偶尔来一下的管理面开销,而是和 token 产出等比例增长的数据面主流量。它的设计好坏,直接决定 PD 分离省下的算力会不会被网络吐回去。
图里把四个角色的流量量级标出来了:请求进、文本出都是 KB 级小流量,唯独 prefill 到 decode 这一段是 GB 级主干。理解这张图就理解了 Mooncake 的设计动机——传输层不是附属品,而是和调度器并列的一等公民。也正因为流量集中在这一个环节,它的带宽利用率和传输时延会被放大到整个系统的 SLO 上:搬运慢 100 毫秒,用户看到的 TTFT 就多 100 毫秒。
二、分层架构:以 KV Cache 为中心的分布式缓存
Mooncake 的整体架构可以切成三层来看:顶上是和推理引擎(vLLM、SGLang 等)对接的接入层,中间是全局调度的 Conductor,底下是干体力活的 Transfer Engine——狭义的 Mooncake KV 传输层主要指这一层加上它的存储抽象。
和传统「请求级转发」思路不同,Mooncake 把 KV Cache 本身当成一等资源来管理:每个请求的 KV 被切成固定大小的 block(与 KV Cache 管理全景 里讲的 PagedAttention 分页思想同源),注册到全局的元数据目录里。这样一来,decode 节点不一定非要「拉」数据到本地显存才能算——它可以把 prefill 节点甚至 CPU 内存池、NVMe 池当成远端 KV 存储,按需分页读取。这就把「点对点搬运」升级成了「分布式缓存分层」:GPU 显存是第一级,同机 CPU 内存是第二级,跨机内存和 NVMe 是第三级,容量逐级变大、带宽逐级变小。
这个分层带来两个直接收益。其一是显存压力的解耦:decode 节点显存不够时,可以把冷 KV block 溢出(spill)到内存池,相当于用网络带宽换显存容量,集群能装的并发上下文显著变多。其二是前缀复用跨节点生效:prefill 算过的公共前缀 KV 留在缓存层里,下一个带同样前缀的请求连 prefill 都不用跑,decode 直接拉取——这也是 Mooncake 在 Kimi 长上下文场景里压低成本的关键手段,详细机制可对照 KV Cache 管理全景 里的 prefix cache 一节。
三、一次 KV 搬运的完整路径
把镜头拉近到单次传输。prefill 完成一个请求后,Transfer Engine 要做的事是:把分布在多张 GPU 显存里的 KV block,通过 RDMA(Remote Direct Memory Access,远程直接内存访问——网卡直接读写对端内存、不经过对方 CPU 的网络技术)送到 decode 节点的指定位置。理想路径是 GPUDirect RDMA:数据从源 GPU 显存直接进网卡,跨过网络后直接落到目标 GPU 显存,全程零拷贝、零 CPU 参与。这条路径的底层原理在 RDMA 与 GPUDirect 推理加速 里有完整展开,这里聚焦 Mooncake 在它之上做的工程取舍。
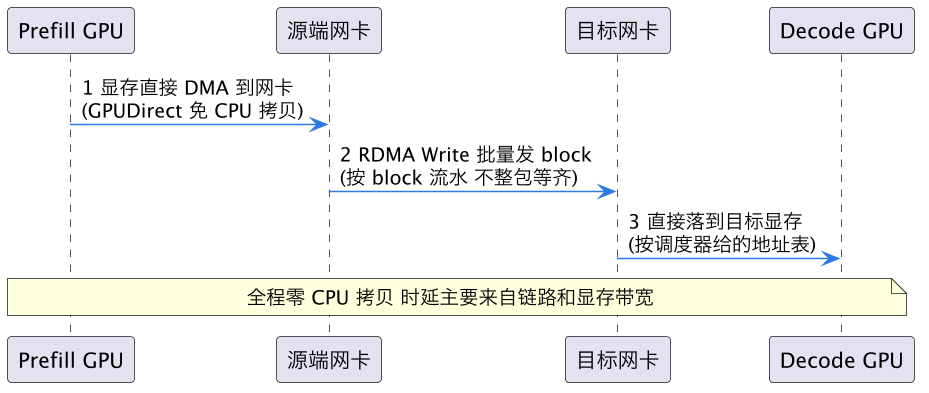
时序图里的三个步骤各有一个值得记住的点。第一步能否走 GPUDirect 取决于机器拓扑:GPU 和网卡要在同一个 PCIe 交换机(或 NUMA 节点)下,否则数据要绕行 CPU 内存,带宽直接打五折甚至更低——所以 Mooncake 的部署文档会强调网卡与 GPU 的亲和性绑定。第二步按 block 流水发送而不是攒齐再发,是为了让「传输」和「decode 首步计算」重叠:decode 侧拿到前若干层的 KV 就可以开始注意力计算的预备工作。第三步的地址表来自 Conductor 的元数据目录,decode 侧事先分配好显存 block,传输任务里直接携带目标地址,避免到了再分配的停顿。
工程上还有两个不那么显眼但很要命的细节。一个是多网卡条带化:一台 8 卡 prefill 机通常配 4~8 张 200G/400G 网卡,Transfer Engine 会把一个大请求的 block 流拆到多张网卡并行发送,单卡故障时也能降级运行而不是整条流中断。另一个是传输与计算的并发控制:RDMA 发送会占用 GPU 的拷贝引擎和 PCIe 带宽,如果和 prefill 的下一轮计算抢通道,两头都变慢,所以传输任务要按 QoS 限速排队,宁可 KV 晚到 20 毫秒也不能让在算的 prefill 批次掉速。
四、带宽瓶颈的量化测算
谈优化之前先会算账,Mooncake KV 传输层的瓶颈测算有个简洁的心算模型:
每 token 产出对应的 KV 传输字节数 = 2 × 层数 × KV 头数 × 头维度 × 精度字节数(对 prefill 完即迁走的请求,这是一次性流量;按集群稳态吞吐折算成带宽)。
沿用第一节的 70B 模型参数(每 token 约 327 KB)。假设集群稳态要支撑全系统每秒新完成 30000 token 的 prefill(注意是 prefill 完成的 token,不是 decode 产出的 token——长上下文场景前者往往更大),那么传输层需要持续搬运 30000 × 327 KB ≈ 9.8 GB/s,即约 78 Gbps。这是稳态下限;突发(一批长请求同时完成 prefill)时峰值可能是稳态的 3~5 倍。
| 场景 | 每 token KV | prefill 完成速率 | 稳态传输带宽 | 需要网卡(200G 实效率 70%) |
|---|---|---|---|---|
| 7B 短上下文聊天 | 约 80 KB | 50000 token/s | 约 32 Gbps | 1 张富余 |
| 70B 混合流量 | 约 327 KB | 30000 token/s | 约 78 Gbps | 1 张紧张 2 张稳妥 |
| 70B 长上下文(128K) | 约 327 KB | 60000 token/s | 约 156 Gbps | 2 张起步 |
| MoE 大模型 256 层 | 约 600 KB | 40000 token/s | 约 192 Gbps | 2 张以上 |
表里的「实效率 70%」是个重要修正:RDMA 虽然零拷贝,但链路上仍有报文头开销、拥塞控制回退、以及 block 大小不整页时的对齐浪费,实测有效带宽通常打不到线速。Mooncake 论文里给出的优化手段——拓扑感知选路、block 合并成大消息、多轨道(rail)并行——本质上都是把这 70% 往 90% 推。
另一个常被忽略的瓶颈轴是时延而不只是带宽。KV 搬运是 TTFT 的关键路径:prefill 算完到 decode 吐第一个 token 之间,传输时延是硬加项。8K 上下文的 2.6 GB 在单张 200G 网卡上理论要 100 毫秒以上,这就是为什么必须多卡条带化加流水化——把「全量搬完再 decode」改成「边搬边 decode」,首 token 等待就能从百毫秒级压回十毫秒级。对 SLO 的分解方法可以对照 分离式推理集群 里 TTFT 预算的拆法。
这张图对比的两种方案就是传输层调优的主线:方案 A 把传输做成串行的搬家,方案 B 把它做成流水的传送带。Mooncake 的 Transfer Engine 按 B 设计,配合 GPU/网卡拓扑绑定,把 TTFT 里的传输项压到接近首 block 的单次 RTT 量级。
五、瓶颈出现时的调优顺序
真到瓶颈压顶时,按代价从低到高的顺序动这几个旋钮。
第一档,拓扑与亲和性核对:确认每张网卡和服务的 GPU 组在同一 NUMA/PCIe 域,跨 socket 传输立刻修。这一档不花钱,收益经常是最大的——实测跨 NUMA 绕行能把单流带宽从 180 Gbps 打到 60 Gbps。
第二档,block 与并发参数:调大传输 block 的合并粒度(更大的 RDMA 消息摊薄报文开销)、提高每请求的并行流数、打开多网卡条带化。代价是显存里要预留更多传输缓冲。
第三档,缓存层吸收峰值:把突发流量先写进 CPU 内存池甚至 NVMe 池,decode 侧异步拉取,用容量换带宽削峰。代价是命中远端层时 ITL 略增,需要按 SLO 定各层容量配比。
第四档,流量整形:Conductor 侧按 QoS 给传输任务限速排队,保护在算的 prefill 批次;同时把长上下文请求的路由倾向调度到「同机架、少跳数」的 decode 节点,减少跨交换机流量。
第五档,动架构:减 KV 体积本身——GQA/MQA 头数压缩、KV 量化到 FP8 甚至 INT8(每 token 字节数直接减半再减半)、或者用 MLA(Multi-head Latent Attention,把 KV 压成低秩潜向量的注意力变体)这类结构级压缩。这一档要动模型,代价最大,但它是唯一能让带宽需求本身缩水的手段。
五档之间的关系概括成一句话:先确认没走错路,再把路修宽,然后削峰,再限流,最后才考虑少拉货。动手顺序别倒过来——见过团队在没查 NUMA 拓扑的情况下直接上 KV 量化,模型精度掉了两个点,带宽却只省了一半,而真正的跨 socket 绕行问题原封不动地留在那里。
六、和同类方案摆在一起看
Mooncake KV 传输层不是孤立的设计,把它和另外两条常见路线摆在一起,选型逻辑会更清楚。
| 方案 | 传输语义 | 缓存形态 | 优势 | 短板 |
|---|---|---|---|---|
| 请求级转发(朴素 PD) | prefill 完把 KV 整包推给 decode | 无全局缓存 | 实现最简单 | 无前缀复用 无削峰层 带宽峰值硬扛 |
| vLLM 加 NIXL / LMCache 插件 | block 级 RDMA 拉取 | 本地加共享池 | 生态内即插即用 | 全局调度弱 跨机分层有限 |
| Mooncake 传输层 | block 级 加 全局元数据目录 | GPU 加 内存 加 NVMe 三级 | 前缀跨节点复用 削峰能力强 | 组件多 运维复杂度高 |
从表里能读出一个梯度:三种方案在「全局性」上逐级增强,代价是系统复杂度同步上升。选型判据其实就两条:一看流量里公共前缀的占比——多轮对话、RAG、agent 场景前缀重复率常常在 50% 以上,这时 Mooncake 的全局缓存能直接省掉一半 prefill 算力,复杂度的代价就值;二看上下文长度——8K 以内的短上下文业务,KV 总量小、传输压力温和,朴素请求级转发就够,上全套分层缓存属于过度设计。反过来,128K 长上下文加高重复前缀的组合(典型如长文档问答),基本只有第三种形态扛得住成本。
还有一个趋势值得留意:传输层正在和调度层融合。Mooncake 的 Conductor 做路由时已经在参考 KV 元数据目录(哪台机器缓存了哪些前缀),下一代系统大概率会把「传输代价」直接写进调度目标函数——把请求调度到 KV 已经在本地或同机架的节点,从根上少搬数据。到那时,传输层的优化就不再是「搬得更快」,而是「尽量不用搬」。
这一篇在知识体系里的位置
本篇是 PD 分离专题的传输层深挖篇。上游:chunked prefill 与 PD 分离(为什么要拆)、分离式推理集群(集群角色与调度)。同层配套:KV Cache 管理全景(KV 的分页与复用机制,传输层搬的就是它)、RDMA 与 GPUDirect 推理加速(传输层底下的网络原语)。读完后建议按「集群设计 → KV 管理 → 传输实现 → 网络原语」的顺序回链复习,四层正好构成 PD 分离数据面的完整栈。
总结
Mooncake KV 传输层的本质是:PD 分离把 KV Cache 从「本地显存里的临时状态」变成了「跨网络搬运的 GB 级主流量」,Mooncake 用以 KV 为中心的分布式缓存分层加 RDMA/GPUDirect 零拷贝传输来扛住它——每 token 约 327 KB(70B GQA 模型)的传输单价决定了带宽测算的公式,多网卡条带化加分层流水化把传输时延藏出 TTFT,瓶颈出现时按「拓扑核对 → 参数调宽 → 缓存削峰 → 流量整形 → KV 压缩」五档从低到高动手,而最根本的解法永远是用量化或 MLA 让 KV 本身变小。