UVM 寄存器镜像值:desired 与 mirrored 的语义、更新时机与常见错位
更新时间:2026-09-29。在 UVM RAL 前门与后门访问 里我们讲了访问路径怎么选,在 寄存器块与地址映射结构 里讲了 reg/block/map 的组织方式,在 寄存器模型集成 里讲了 adapter 与 predictor 怎么接线。接线都对了之后,真正让工程师半夜挠头的是另一个问题:
uvm_reg里其实存着两份值——你想写下去的 desired 和你认为硬件当前是的 mirrored,搞混它们,scoreboard 比对、自动预测、后门检查会连环出错。这一篇把两份拷贝的语义和更新时机彻底讲透。
本文要回答的问题
- desired value 和 mirrored value 各代表什么,为什么不合成一份?
set()、get()、get_mirrored_value()、predict()各自动哪份拷贝?write/read/update/mirror四种操作之后,两份拷贝分别何时被改写?- 自动预测(auto prediction)和显式 predictor 下,mirrored 的更新链路有什么差别?
- scoreboard 里该拿
get()还是get_mirrored_value()跟 DUT 对?
一、为什么一个寄存器要存两份值
软件世界里一个变量就是一份值,为什么 UVM 寄存器模型里每个 field 要存两份?因为寄存器模型不是普通的变量,它是对一块真实硬件的影子:硬件里的值随总线事务和 DUT 内部逻辑随时在变,验证环境对它的「认知」和「意图」是两回事。
- desired value(期望值):验证环境打算让硬件成为的值。
set()改的就是它。它是「下一次写操作的载荷」,也是update()判断「要不要发总线写」的依据。 - mirrored value(镜像值):验证环境认为硬件当前实际的值。它只能由「观察到的事实」更新——一次前门读返回的数据、predictor 抓到的总线写事务、一次
mirror()检查。你不能用set()直接改它。
分开存的好处在一个典型场景里立刻显现:你想把 CTRL 寄存器的 enable 位置 1,于是 set(1)。但硬件当前 enable 是 0(mirrored=0)。update() 一比对:desired≠mirrored,才需要发起总线写;如果两者本来就相等,update() 什么都不发,省掉一次冗余总线事务。这个「按需下发」的优化,没有两份拷贝根本做不出来。
再往深想一层,两份拷贝还解决了「多主异步」问题。验证环境不是唯一改寄存器的人:DUT 内部逻辑会自清状态位、固件会改写配置、中断来了硬件自动置位。如果只有一份值,环境根本分不清「这个值是我写的还是硬件自己变的」,比对逻辑无从谈起。有了 mirrored 专门承接「观察到的事实」,desired 专门承接「我的意图」,两者的差异本身就携带信息——差异存在,要么是我还没下发,要么是硬件在我不知道的时候动了手脚,这正是寄存器级 scoreboard 的立身之本。
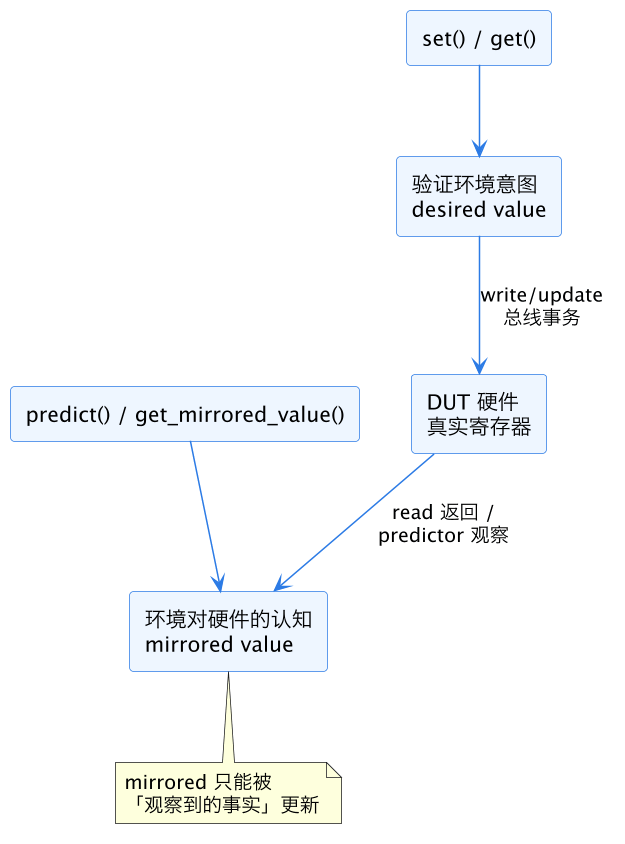
上图是整篇的骨架:desired 在左、mirrored 在右、DUT 在中间。意图从左流向硬件,事实从硬件流回右边。所有 API 的归属都可以在这张图上定位。
再补一张速查表,后面各节逐个展开:
| API | 改/读 desired | 改/读 mirrored | 发总线事务 |
|---|---|---|---|
set(v) | 写 desired | 不动 | 否 |
get() | 读 desired | 不动 | 否 |
get_mirrored_value() | 不动 | 读 mirrored | 否 |
predict(v) | 视 kind | 写 mirrored | 否 |
write(v) | 写 desired | 成功后同步 | 是(写) |
read() | 不动 | 更新为返回值 | 是(读) |
update() | 不动 | 成功后同步 | 仅当 desired≠mirrored |
mirror() | 不动 | 读回后更新 | 是(读)+ 可选比对 |
二、set/get:只碰意图,不碰事实
set(v) 是最容易被误解的 API。它的语义仅仅是「把期望值摆好」,不发总线事务、不改 mirrored、甚至不检查这个 field 能不能写。连续两次 set(),后一次覆盖前一次,desired 以最后一次为准。
ctrl_reg.enable.set(1);
ctrl_reg.mode.set(2'h3);
// 此时:desired 已改,mirrored 未动,总线上一字节都没发
ctrl_reg.get_parent().update();   // 比对出差异,才发一次总线写
get() 返回的是 desired。这导致一个经典面试题:前门 write(0x55) 之后立刻 get() 是多少?答案 0x55——因为 write() 内部先 set() 再发事务。再问:write 之后没做任何读,get_mirrored_value() 是多少?如果开了自动预测或者 predictor 抓到了这次写,是 0x55;如果是后门写的、又没调 predict(),mirrored 还是旧值。get() 和 get_mirrored_value() 的差异,就是「我想写的」和「我认为硬件是的」之间的差异。
什么时候用 set() 而不是 write()?当你想攒一批字段一次写下去的时候。十个 field 逐个 write() 会发十次总线事务、把其他字段也顺带刷新;逐个 set() 再 update() 只发一次,而且未 set() 的字段按 mirrored 原样回填,不打扰硬件。
这个「按 mirrored 回填」的细节值得单独强调。update() 拼写载荷时,对你 set() 过的字段用 desired,对没碰过的字段用 mirrored。也就是说,update() 写出来的整个字是「你的新意图 + 环境对旧事实的认知」的混合体。如果 mirrored 本身是过期的(比如硬件刚刚异步改了某个你没 set() 的位),这次 update() 会把过期值写回去,覆盖硬件的新状态。所以在中断处理这类硬件高频自改的场景里,set() + update() 之前先 mirror() 刷新认知,是防止「配置回写踩掉硬件状态」的标准动作。
还有一个粒度问题:set() 在 field 级和 reg 级都能调。reg 级 set(v) 会把整个值按 field 布局拆开,逐 field 摆 desired,遇到 RO 或保留位直接跳过——这也是为什么推荐尽量在 field 级表达意图,寄存器里那些访问策略各异的位才不会被你的整字赋值误伤。
三、predict():mirrored 的唯一正规写入口
predict(value, kind) 是把「一个已经发生的事实」灌进 mirrored 的接口。它不发总线,纯粹更新影子。三个要点。
第一,kind 参数决定语义:UVM_PREDICT_WRITE 表示「我观察到一次写」,UVM_PREDICT_READ 表示「我观察到一次读返回」,UVM_PREDICT_DIRECT 表示「我直接知道它现在等于这个值」(后门 peek 之后用)。kind 会影响 field 的访问策略判定——比如 W1C(写 1 清零)field 在观察到写时不能简单把值抄进 mirrored,要按访问类型换算实际结果。
第二,谁会替你调 predict:两条路。自动预测(set_auto_predict(1),默认开)下,前门 read/write 完成后寄存器模型自己调;显式预测下,总线 monitor 把 transaction 广播给 uvm_reg_predictor,由 predictor 经 adapter 反解出地址和数据后调。后门访问两者都不覆盖,必须自己手动 predict()。
第三,desired 也会被间接影响。predict 观察到一次写时,如果该 field 的 desired 还没被显式 set() 过,部分访问策略下 desired 会跟随 mirrored 对齐,避免下一次 update() 把刚观察到的事实又写回去。这个细节各家仿真器实现略有出入,别依赖它,关键字段显式 set()。
第四,predict 是 field 级策略换算的执行点。寄存器模型之所以能为 W1C、WO、RO 这些访问类型给出正确的 mirrored,全靠 predict 内部按 field 的 access policy 做换算:观察到一次写 1 到 W1C 位,换算结果是「该位清零」而不是「该位变 1」。如果你绕过 predict、直接手工给 mirrored 赋值(比如改句柄内部成员),就丢掉了这层策略保护,写出来的比对代码只对自己见过的那一两种访问类型正确。
// 后门 poke 之后,必须手动同步 mirrored
ctrl_reg.poke(status, 32'hA5);
ctrl_reg.predict(32'hA5, -1, UVM_PREDICT_DIRECT);
四、write/read/update/mirror:四种操作后的同步时机
这是全文的核心。四种总线操作对两份拷贝的作用各不相同,画成状态迁移最清楚。
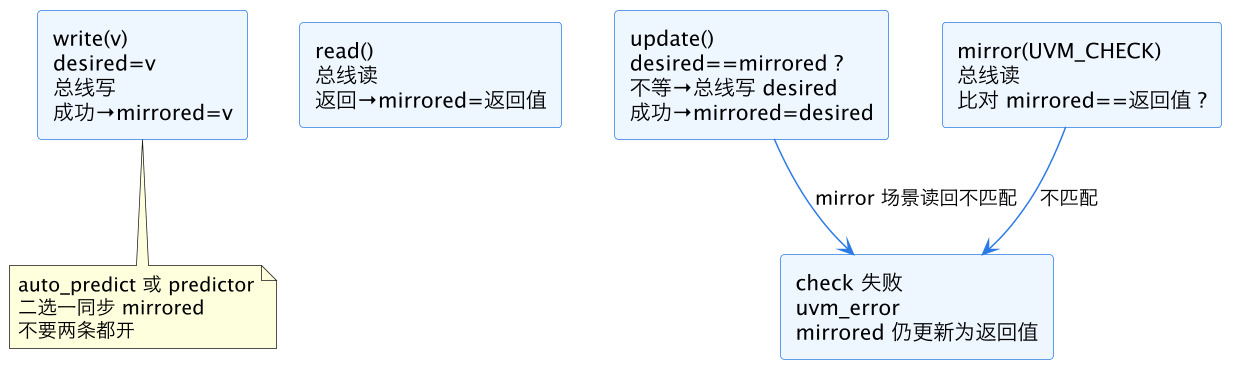
逐个说。
write(v):先 set(v)(desired=v),发前门写事务,事务完成后经预测链路把 mirrored 同步成 v。从调用者视角看,write 之后 desired 和 mirrored 相等——前提是 DUT 没有把写入值变换掉(比如只读位、保留位被强制为 0,这种要靠 predictor 按访问策略修正,而不是简单抄值)。
read():发前门读事务,把返回值灌进 mirrored,同时作为返回值交给调用者。desired 不动。所以 read 之后 get() 不一定等于 get_mirrored_value()——前者还是你上次 set 的意图,后者是硬件的真实回答。
update():惰性下发。desired==mirrored 就直接返回成功、零总线流量;不等才发写,成功后 mirrored 跟上。回归里大量寄存器初始化序列用 set() 攒好再 update(),比一串 write() 快得多。
mirror(check):是「带断言的 read」。发读事务,拿到返回值先更新 mirrored,再在 UVM_CHECK 模式下跟读之前的 mirrored 比对,不一致报 uvm_error。它是 scoreboard 之外做「环境认知 vs 硬件现实」自检的标准手段,典型用法是中断状态、状态机当前态这类被 DUT 异步改写的寄存器。
还有一个容易踩的点:update() 和 mirror() 都支持后门路径(指定 UVM_BACKDOOR),此时没有总线事务可抓,自动预测链路照走寄存器模型内部的同步,但不经过 predictor,外部 monitor 看不到这次访问——如果你的 scoreboard 靠 monitor 流对账,后门 mirror 造成的 mirrored 变化它是无感的。
把这四种操作的适用场景收拢成一张表,选操作时对号入座:
| 操作 | 一句话语义 | 典型场景 |
|---|---|---|
write(v) | 立即把 v 写进硬件并同步双份拷贝 | 单点配置、初始化少数寄存器 |
read() | 问硬件要当前值,刷新认知 | 调试打印、手工对账 |
update() | 攒好的意图按需一次性下发 | 初始化序列、批量改字段 |
mirror(check) | 读回并断言认知与现实一致 | 异步状态位、周期性健康检查 |
五、自动预测 vs 显式 predictor:mirrored 的两条补给线
mirrored 更新的两条链路不能同时开,这是集成阶段最容易犯的错误。
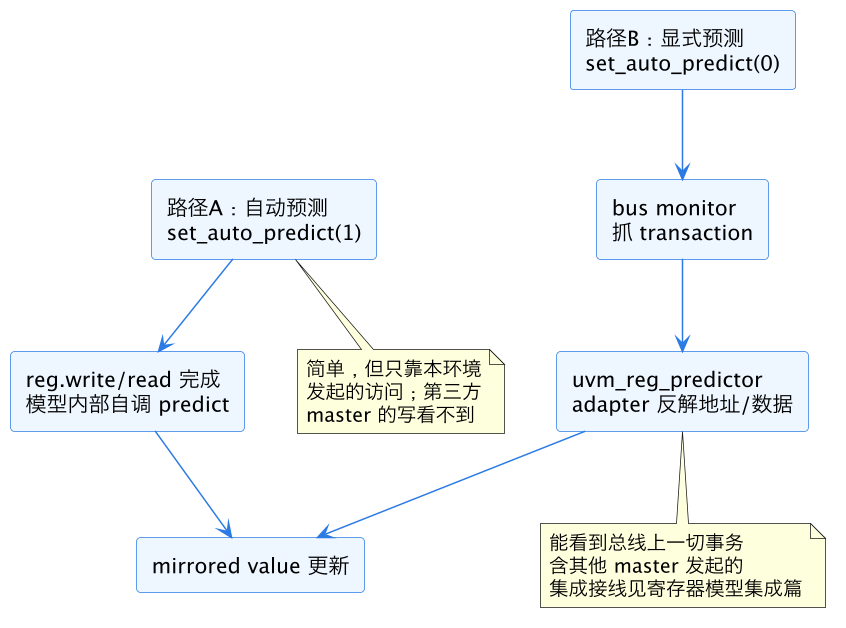
显式预测的接线细节——predictor 挂哪个 analysis port、adapter 怎么把总线 transaction 翻译成 uvm_reg_item——属于集成范畴,这里不展开,重要的是理解两条链路在「谁有资格改写 mirrored」上的分工。
选择标准一句话:DUT 的寄存器只被你的寄存器模型这一路访问,用自动预测;总线上可能有其他 master(比如另一个 VIP、固件模型)也在写寄存器,必须上 predictor。两条都开的后果是 mirrored 被重复 predict,对普通 RW 字段无害,但对 W1C、RC(读清零)这类访问策略敏感的字段会算出错误结果,而且 bug 时隐时现极难定位。
真实项目里更常见的是混合拓扑:主总线挂 predictor 抓一切可见事务,同时对几条「模型自留地」的辅助路径保留自动预测。判断标准仍然是「这条路径上的事务 predictor 能不能看到」——能看到就关自动预测交给 predictor,看不到就只能靠访问 API 自己同步。集成阶段把每条访问路径在这两个问题下过一遍,mirrored 来源就再不会是一笔糊涂账。
另一个被低估的差异是时序精度。自动预测在 write/read 任务返回的那一刻同步,时序上紧贴调用点;predictor 要等 monitor 观察到事务、广播、adapter 反解,晚若干个仿真 delta 甚至几个时钟。如果 testbench 里有「刚 write 完立刻在同一个 time slot 里读 mirrored」的代码,自动预测下能拿到新值,显式预测下可能拿到旧值。规范写法是 write 之后要么用返回值、要么等一个明确的同步点再查 mirrored,别赌预测链路的延迟。
六、scoreboard 该比对哪份值
最后落到实战。scoreboard 里拿寄存器模型跟 DUT 对账,三个准则。
第一,对「软件可见状态」用 get_mirrored_value()。比如中断挂起位、FIFO 计数,这些是硬件事实,你的认知只能来自 mirrored。
第二,对「我发起的配置有没有生效」用 mirror(UVM_CHECK),让它自己报 mismatch,别手工 read() 再跟 get() 比——get() 是 desired,write 之后它恒等于你写的值,这种比对永远通过、毫无意义。这是新手最常见的假阳性测试:「我写了 0x5A,get 回来是 0x5A,PASS」——其实总线根本没通。
第三,访问策略要参与换算。RO 字段写下去硬件不理会,desired≠硬件值是合法的;W1C 字段 mirrored 的换算规则在 predict 里完成。比对这些字段时要么按访问类型过滤,要么直接靠 mirror() 内建的策略感知比对。
// 反模式:永远 pass
ctrl_reg.write(status, 32'h5A);
if (ctrl_reg.get() == 32'h5A) `uvm_info("SB", "PASS?", UVM_LOW)

// 正确:跟硬件事实对
ctrl_reg.mirror(status, UVM_CHECK, UVM_FRONTDOOR);
常见坑
- 用
get()验证 write 是否成功——get()返回 desired,write 之后恒等于写入值,比对永远通过,总线断了也发现不了。 - 后门
poke()改完寄存器忘了predict(),mirrored 还是旧值,后续update()把旧值写回去,poke 白做。 - 自动预测和显式 predictor 同时开,W1C/RC 字段 mirrored 被双重换算,偶发比对失败。
- 对硬件异步更新的字段直接
set()+update(),把硬件刚置的状态位用过期 mirrored 覆盖掉。 mirror()忘了传UVM_CHECK,默认UVM_NO_CHECK只更新不比对,以为是断言其实是静默刷新。- 在 predictor 链路下 write 完立刻同一时刻查 mirrored,拿到的是尚未同步的旧值。
这一篇在知识体系里的位置
- 向上承接:UVM RAL 前门与后门访问 讲访问怎么发到硬件,本篇讲访问之后环境内部的两份值怎么同步;寄存器块与地址映射结构 提供 reg/field/map 的组织背景。
- 横向相关:寄存器模型集成 里 adapter 与 predictor 的接线,是本文第五节显式预测链路的工程落地。
- 落地延伸:搞清 desired/mirrored 语义后,
uvm_reg_sequence里的寄存器扫描、复位检查、位翻转测试等内建序列的行为才能读得懂、改得动。
总结
UVM 寄存器镜像值机制把每个 field 拆成 desired(我想写的意图)和 mirrored(我认为硬件是的事实)两份拷贝:set/get 只碰意图,predict/get_mirrored_value 只碰事实;write/read/update/mirror 四种操作在意图与事实之间按各自时机同步,update 靠两者差异实现惰性下发;mirrored 的补给线有自动预测和显式 predictor 两条、只能开一条;scoreboard 比对永远跟硬件事实对,用 mirror(UVM_CHECK) 而不是 get(),才不会写出恒通过的假测试。