AXI4 完整协议:五通道、burst、outstanding 与 ID 保序
更新时间:2026-09-06。本文是「集成电路大类 · 芯片设计」**进阶层(intermediate)**第六篇新正文(#08)。上一篇 AXI4-Lite 从机设计 练了五通道握手,这一篇讲完整 AXI4 为什么能扛内存带宽——三个 Lite 没有的机制:burst、outstanding、ID 保序。入门铺垫见 AMBA 入门 与 片上总线 AMBA 枢纽页。
本文要回答的问题
- burst 怎么传?INCR/FIXED/WRAP 三种模式各用在哪?
- outstanding 是什么,为什么它让总线变快?
- 多笔事务在途,返回顺序乱了怎么办?ID 规则怎么说?
- AXI4 比 AHB/AXI3 强在哪?
一、burst:一个地址带一串数据
Lite 每传一个字都要走一次「地址握手 + 数据握手」,访问 DDR 这种连续地址时一半带宽浪费在地址上。burst 只发首地址,随后连续传 AxLEN+1 拍(AXI4 最长 256 拍):
| 信号 | 含义 |
|---|---|
| AxLEN | 拍数 − 1(0–255) |
| AxSIZE | 每拍字节数(2^SIZE,如 3'b011 = 8 字节) |
| AxBURST | INCR:地址递增(访存主流);FIXED:地址不变(FIFO/寄存器);WRAP:递增到边界回绕(cache line 回填) |
| WLAST / RLAST | 最后一拍拉高,标志 burst 结束 |
例:首地址 0x0、LEN=15、SIZE=3(8B)、INCR → 传 16 拍共 128 字节,地址 0x0,0x8,…,0x78,正好一个 cache line。WRAP 与 INCR 的区别在于跨 16 拍边界后地址回绕到首地址——供 CPU 只缺 cache line 中一个字时「先给缺的那个」用。
二、outstanding:把延迟藏起来
即使有 burst,一笔事务仍要等「地址到内存 → 内存访问 → 数据回来」的往返延迟(DDR 可达几十拍)。若发一笔等一笔,总线大部分时间在空等。**outstanding(未决事务)**允许主机不等响应连续发多笔地址,N 笔事务同时在途:
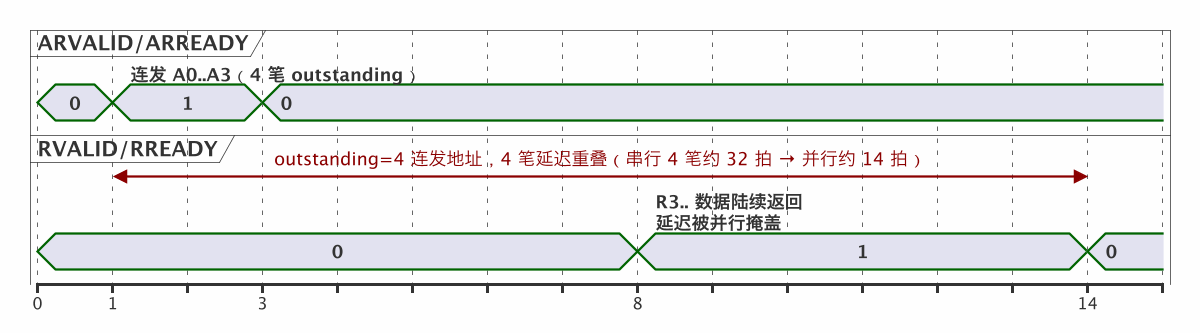
这就是「带宽 = 频率 × 位宽」能跑满的前提——latency 被 outstanding 深度掩盖。从机/interconnect 必须为每笔在途事务维护缓冲(存地址、ID、控制信息),所以「支持多少 outstanding」是接口配置参数(通常 4–32)。写侧同理:AW 与 W 可以分开发,B 响应最后统一回来。
三、ID 与保序:多笔在途的交通规则
多笔事务同时在途,返回顺序可能与发出顺序不同(慢的从机、interconnect 路由),用 AxID 给每笔贴标签,规则:
- 读:同一 ARID 的数据必须按地址发出顺序返回;不同 ID 之间允许乱序(completion 可以先回)——主机靠 ID 把数据对回原请求;
- 写:同一 AWID 的 W 数据必须按序;不同 ID 的数据允许交织(interleave)(AXI4 其实已禁止写数据交织,interconnect 不再支持,但协议概念要懂);
- 写响应 BID 对应 AWID。
ID 还有个妙用:interconnect 可以扩展 ID 位宽加上「主机号」前缀,实现多主机路由。不允许乱序的简单从机可以把所有响应按 FIFO 序回、ID 透传,牺牲一点性能换简单。
四、属性信号与独占访问
| 信号 | 作用 |
|---|---|
| AxCACHE | 可缓存/缓冲/写分配等属性,告诉 interconnect 和 cache 这笔访问怎么处理 |
| AxPROT | 特权级、安全/非安全(TrustZone)、指令/数据访问 |
| AxLOCK + 独占监控 | exclusive access:先读某地址,再条件写,期间被别人改过则失败——无锁队列/信号量的硬件原语 |
| WSTRB | 写字节使能,burst 中逐拍可部分字节有效 |
五、为什么是 AXI4 赢了
对比老一代 AHB(见 AHB/APB 与桥接 #09):AHB 是单通道、共享总线、三态驱动,同一时刻只能一对主从通信、无法 outstanding、仲裁靠中央 mux;AXI 五通道分离 + valid/ready 点到点 + 多 outstanding,天然适合多 master、高频率、宽数据(128/256/512 位)互连,所以今天从 MCU 到服务器 SoC 内部全是 AXI 骨架。AXI3→AXI4 的主要变化:burst 上限 16→256、去掉写数据交织、新增 QoS(AxQOS)。
带宽估算:理论峰值 = 位宽 × 频率(如 128bit @ 1GHz = 16GB/s);实际效率取决于 burst 长度(越长越好)、outstanding 深度(够深才能掩盖 DDR 延迟)、反压气泡(见进阶 #06)。性能建模与实测是进阶 #41 的专题;更大规模的互连进化为 NoC(#42),多核共享内存还要在 AXI 上加缓存一致性(ACE/CHI,#43)。
相关与延伸
上一篇:AXI4-Lite 从机设计。下一篇:AHB/APB 与桥接:低速外设总线怎么挂。入门铺垫:AMBA 入门、片上总线 AMBA;握手机制见 valid/ready 握手;DMA 怎么用 AXI 搬数见 中断与 DMA 与进阶 #27 DMA 引擎设计;性能建模见进阶 #41,NoC 见 #42,一致性见 #43。
总结
AXI4 靠三件套扛带宽:burst(一个地址传 256 拍)、outstanding(多笔事务在途用并行掩盖访存延迟)、ID(同 ID 保序、异 ID 可乱序);五通道点到点 valid/ready 取代 AHB 共享三态总线,是现代 SoC 数据面的通用骨架。