UVM RAL 前后门访问:frontdoor/backdoor 数据通路、mirror 同步与 HDL 路径全解
更新时间:2026-09-28。在 UVM 寄存器模型集成 里,我们把 RAL(Register Abstraction Layer,寄存器抽象层)挂进了 env:reg model、adapter、predictor 各就各位。但只回答了一个问题——模型怎么建。这一篇往下走一层:建好模型之后,sequence 里一句
reg.write()到底走了哪条路把数据送进 DUT,UVM RAL 前后门访问的两条通路差异在哪,模型里的 mirror 值和 desired 值又靠什么保持同步。
本文要回答的问题
- frontdoor 和 backdoor 两条访问通路,从 sequence 到 DUT 寄存器各自经过哪些环节?
- 同一个
write()调用,为什么有时耗几十拍、有时零拍完成? - uvm_reg 里的 desired value 和 mirrored value 是两份什么数据,谁在什么时候更新它们?
- backdoor 访问绕过了总线,那 monitor 和 predictor 看不见这笔事务,mirror 会不会失真?
- HDL 路径(hdl_path)是怎么把抽象寄存器映射到 DUT 内部信号的,路径写错会出现什么症状?
一、为什么要有两条通路:寄存器访问的两个世界
寄存器验证天然面对一个矛盾:你既要验证「软件从总线写一个寄存器」这条真实路径本身对不对(总线时序、地址译码、字节使能都要被激励到),又要在成百上千个用例里高频读写寄存器做配置和检查。后者如果每笔都走总线时序,一个配置序列几万拍起步,仿真时间先顶不住;前者如果只走后门直达,你又根本没在验证硬件。
UVM RAL 的答案是同一个寄存器对象开两扇门。**frontdoor(前门)**走完整总线协议:sequence 发出 uvm_reg_item,寄存器模型把它转成总线事务(经 adapter),sequencer 发给 driver,driver 一拍一拍驱动地址/写数据/握手信号,最后真的从 DUT 管脚写进去。**backdoor(后门)**则完全绕开协议:通过 HDL 层次路径直接对 DUT 内部寄存器信号做 uvm_hdl_deposit / uvm_hdl_read,零拍完成,总线上看不到任何活动。
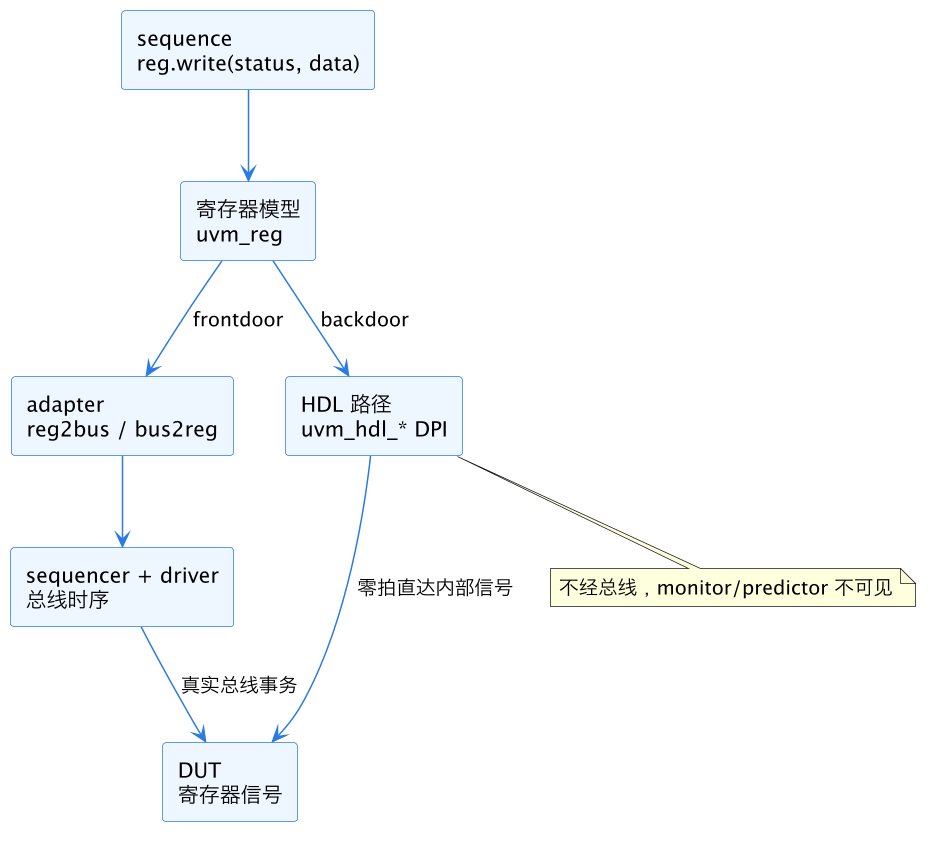
这张图是全篇的骨架:左边一支走 adapter 和 driver,是「协议可见」的通路;右边一支走 HDL 路径直插 DUT 内部,是「协议不可见」的通路。后面所有问题——mirror 同步、自动预测、调试症状——都源于这两条通路的可见性差异。
两条通路的成本与覆盖目标完全不同,选型前先看清差异:
| 维度 | frontdoor | backdoor |
|---|---|---|
| 路径 | adapter → sequencer → driver → 总线 | HDL 路径 → DUT 内部信号 |
| 耗时 | 一笔事务数十拍 | 零拍(不消耗仿真时间) |
| 总线上可见 | 是,monitor/predictor 能抓到 | 否,完全静默 |
| 验证到什么 | 地址译码、时序、协议、字段交互 | 仅验证寄存器功能逻辑 |
| 典型用途 | 功能验证主路径、协议检查 | 快速配置、初始化、大面积遍历 |
二、frontdoor:一笔 write 的完整旅程
以 ctrl_reg.write(status, 32'h5, .path(UVM_FRONTDOOR)) 为例,数据从 sequence 出发要换四次「交通工具」。
第一棒在寄存器模型内部:write 先把期望值写进 uvm_reg 的 desired value(期望值寄存器——sequence 想让硬件变成什么样),然后生成一个 uvm_reg_item,里面带着操作类型(write)、地址、数据。
第二棒是 adapter。寄存器世界说的是「地址 + 数据 + 读写」,总线世界说的是「AXI 的一次 AW/W/B 握手」或「APB 的 setup/access 两拍」。adapter 的 reg2bus 负责把 uvm_reg_item 翻译成具体总线 transaction,交给 sequencer 发给 driver。driver 按协议驱动信号,若干拍后事务完成,响应回来时 adapter 的 bus2reg 再把总线响应翻译回寄存器语义。
第三棒在 DUT 内部:地址译码命中目标寄存器,字段被更新。第四棒回到模型——这就是 mirror 的故事,留到第三节讲。
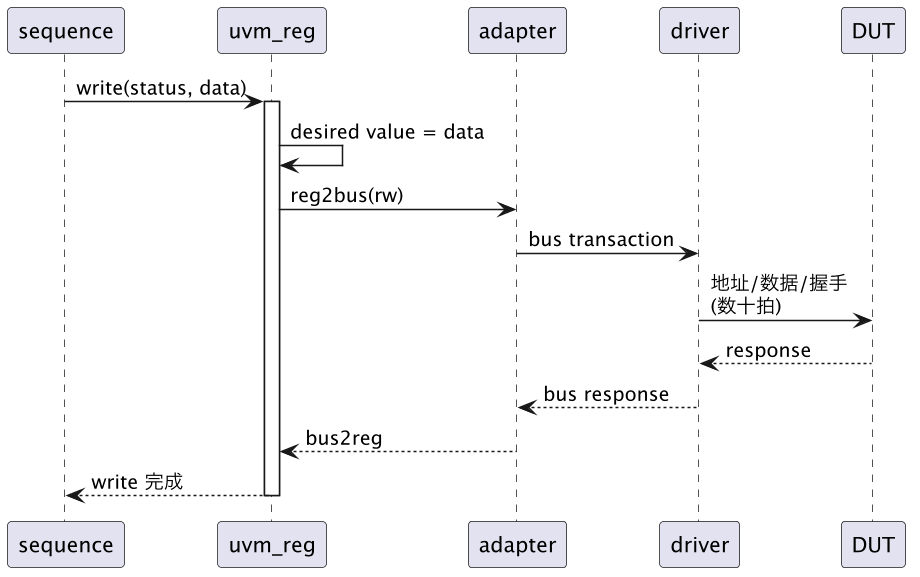
时序图里要注意 write 是阻塞调用:它一直挂到响应回来才返回。所以 frontdoor sequence 天然和总线节奏同步,写多个寄存器就是串行的一串事务。这也是为什么纯配置型 sequence 用 frontdoor 跑回归会很慢——不是模型慢,是总线时序一拍都不能省。
frontdoor 的读操作 read 同理,但返回值有个细节:DUT 里读出的数据会同时更新 desired 和 mirror(对 frontdoor 而言,读回来的就是刚刚总线上看到的,没有歧义),函数参数里那份是拷贝给调用方的。
三、backdoor 与 HDL 路径:零拍直达怎么实现
backdoor 的核心是一句质问:既然仿真器本来就能通过层次路径看到 DUT 内部任何信号,为什么还要绕总线?ctrl_reg.write(status, 32'h5, .path(UVM_BACKDOOR)) 不生成任何总线事务,而是直接调用 DPI(Direct Programming Interface,SystemVerilog 与 C 交互的标准接口)里的 uvm_hdl_deposit("tb.dut.ctrl_reg", 32'h5),一个 time step 内完成。
路径从哪里来?寄存器模型构建时,每个 uvm_reg 通过 add_hdl_path 登记它对应的 RTL 信号路径,寄存器块通过 add_hdl_path_slice 或 configure 时的 hdl_path 参数挂上层次前缀。模型里存的是「相对路径 + 位段」,仿真时拼接 testbench 顶层前缀得到完整层次路径。
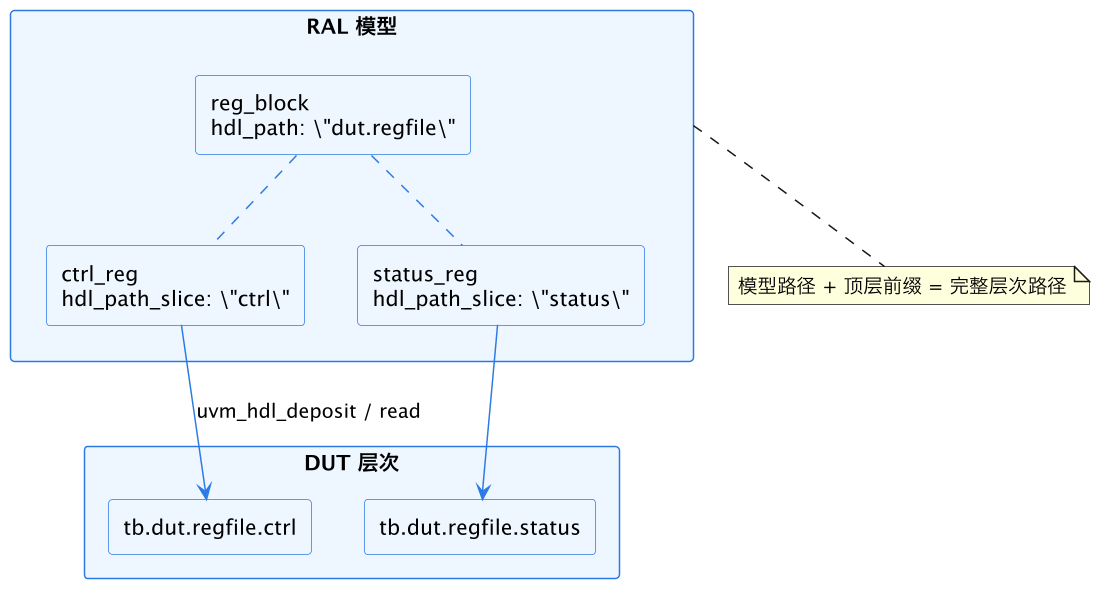
上图的拼接关系是 backdoor 一切故障的根源。路径拼错(比如 RTL 重构后信号改名、generate 块层次变化),backdoor 读写不会报「地址不存在」,而是 uvm_hdl_read 返回 0,数据静默错误——写进去的值 DUT 根本没收到,读回来的永远是 0 或上一次残留。遇到「backdoor 写的配置好像没生效」,第一检查项就是打开 +UVM_HDL 相关 verbose 或直接对路径做一次 uvm_hdl_check_path,确认路径真实存在。
backdoor 还有一对更直白的原语:peek 和 poke。peek 等价于 backdoor read、poke 等价于 backdoor write,但语义上更强调「我只是探查/强注,不走任何协议」。实际工程里常用 poke 做故障注入(直接翻转寄存器某一位看错误处理逻辑),用 peek 做低开销的轮询检查。
一个容易忽略的点:backdoor write 用 deposit 语义,不会触发 RTL 里的 always 块对写事件的正常响应之外的副作用——它就是把信号值放下去了。如果真实总线写这个寄存器会连带清中断、触发状态机,backdoor 写完这些副作用照样发生(因为信号变了组合逻辑会动),但「写脉冲」类的逻辑(写 1 清零)可能因为 deposit 的保持语义而表现不同,调试写清寄存器类 bug 时要意识到这个差异。
四、desired 与 mirror:寄存器模型里的两份数据
每个 uvm_reg 字段内部其实存着三份东西里最要紧的两份:desired value(期望值)——sequence 最近一次要求硬件变成的值;mirrored value(镜像值)——模型认为硬件「现在实际是」的值。拿 mirrored value 做检查是 RAL 的核心收益:scoreboard 比对寄存器状态时不用重新发总线读,直接 reg.get_mirrored_value() 就行。
问题在于:mirror 凭什么知道硬件变了?答案分两条线。
frontdoor 访问:sequence 自己的 write 完成后,bus2reg 回来的数据更新 mirror(对可预测的字段)。更通用的是自动预测——总线上 monitor 抓到任何一笔事务(哪怕是别的 master、别的 sequence 发的),predictor 把总线事务反查地址映射,更新对应寄存器的 mirror。这条链路在 UVM 寄存器模型集成 的 predictor 接线里有完整描述。
backdoor 访问:总线上没有任何事务,predictor 完全看不见。backdoor write 完成后由模型自己同步 mirror——写入的数据直接更新 desired 和 mirror。这在「模型发起」时是闭环的;但如果硬件自己改了寄存器(状态寄存器被内部逻辑更新、中断标志被置位),mirror 就停在旧值上,模型和硬件悄悄分叉。
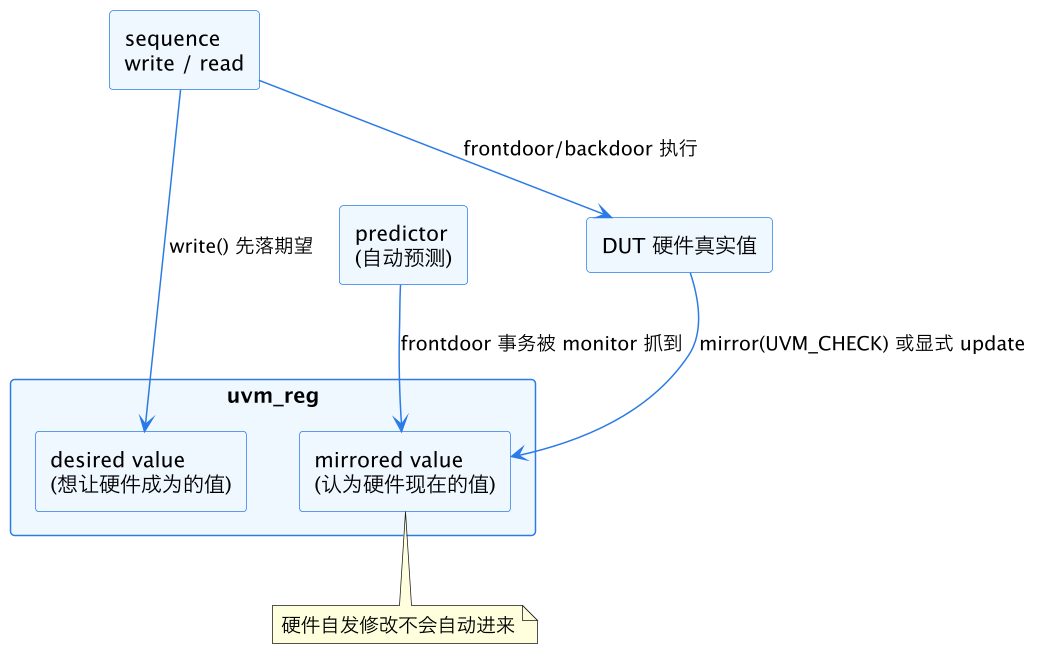
这张图解释了 RAL 调试里最高频的问题:「mirror 值和 DUT 实际值不一致」。同步义务在验证环境一侧,模型提供两个补救动作:
reg.mirror(status, UVM_CHECK):发起一次实际读(默认 frontdoor,可指定 backdoor),把读回值和 mirror 比对,不一致报 UVM_ERROR,同时刷新 mirror。适合对「不应被硬件改」的配置寄存器做抽查。reg.update(status):当 desired 与 mirror 不同(sequence 写了多次 desired 但还没下发),把 desired 真正写进硬件。批量配置场景里可以先set()一堆字段最后一次 update,省掉中间事务。
对会被硬件自发修改的字段(中断状态、FIFO 水位),建模时就要选对比较模式:UVM_NO_CHECK 关掉自动比对,检查责任交给 scoreboard 按协议语义判断,而不是指望 mirror 永远正确。
predict 与 mirror 检查怎么选时机
predict() 是「我知道发生了什么,直接改账本」——predictor 从总线事务推出新值,不访问硬件,零开销,适合每笔可见事务后的例行同步。mirror(UVM_CHECK) 是「我不确定,去硬件看一眼」——要真发一次读事务,有总线开销,但它是唯一能发现「模型整个链路都漏了」的手段(比如某条旁路逻辑改了寄存器,monitor 根本没抓到)。工程上的节奏是:高频同步靠 predict,低频抽查靠 mirror——每个用例收尾对关键配置寄存器做一轮 mirror(UVM_CHECK),复位后对状态寄存器做一次 backdoor mirror,其余时间信任 predictor 链路。反过来全用 mirror 会把回归拖慢,全用 predict 则predictor 接错地址映射时错得无声无息。
frontdoor 挂起与超时纪律
write/read 是阻塞调用,总线侧一旦出问题(driver 卡死、从设备不响应、复位中途打断了握手),sequence 会永久挂起,用例最后靠全局超时兜底,报出来的错误离根因很远。纪律有两条:一是凡 frontdoor 访问的 sequence 都挂 watchdog——fork 出并行线程计时,超时即 uvm_fatal 并打印当前地址,把「挂在哪个寄存器」留在日志里;二是寄存器模型层的 uvm_reg_map 可以配合 sequence 的 set_response_queue 观察在途事务,回归里见到 response queue 深度只涨不落,就是 driver 或总线通路死锁的早期信号。
把模型上最常用的几个调用摆在一起,它们的差异全在「动 desired、动硬件、动 mirror」这三个动作的组合上:
| 调用 | 动 desired | 动硬件 | 动 mirror | 说明 |
|---|---|---|---|---|
set() | 是 | 否 | 否 | 只改期望值,纯软件侧操作 |
write() | 是 | 是(一次事务) | 是(可预测字段) | 立即下发,frontdoor/backdoor 可选 |
update() | 否 | 是(desired≠mirror 时) | 是 | 把攒下的期望值一次落硬件 |
read() | 否 | 是(一次读事务) | 是 | 读回值同时刷新 mirror |
mirror(UVM_CHECK) | 否 | 是(一次读) | 不一致时报错并刷新 | 校验「硬件 == 模型认为的值」 |
peek() / poke() | 否 | 是(backdoor) | 否 | 纯探查/强注,不碰任何账本 |
注意最后一行:peek/poke 是四个主流 API 里唯一完全不记账的,poke 完之后 mirror 不会跟着变。这正是它被定位成「调试与注入原语」而非「常规访问方式」的原因——用它改了寄存器,同步责任就落回你自己头上,要么随后补一次 mirror 刷新,要么在 scoreboard 侧明确豁免。曾有的真实漏测就是把初始化脚本从 write 批量改成 poke 提速,mirror 停在复位值,后面所有依赖 get_mirrored_value 的检查全部比对错对象,回归红了一片却查不到 RTL 问题。
五、通路怎么选:工程实践里的决策
实际项目里两条通路不是二选一,而是按用例目标分配。决策逻辑可以压成一张图:
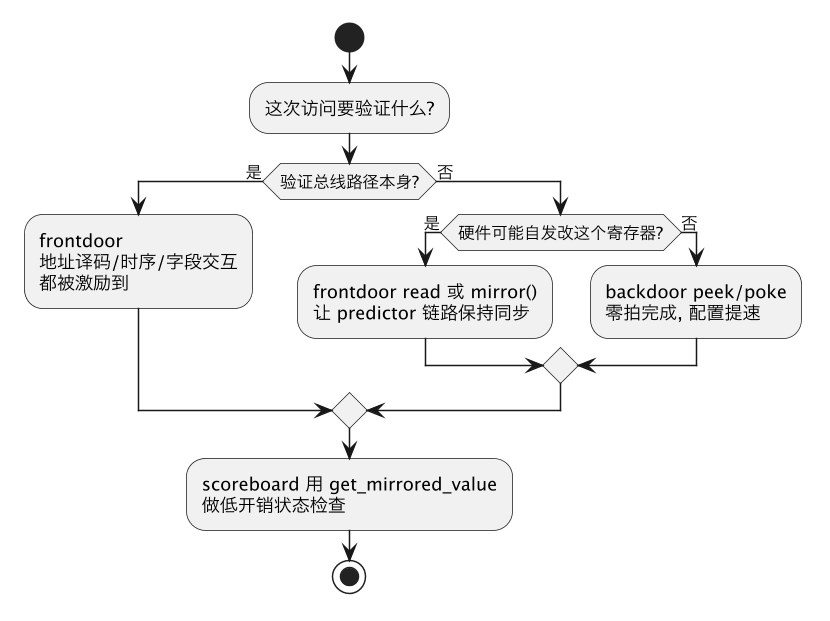
按场景落地时有几条经验结论。上电后的大面积寄存器初始化(几百个配置寄存器)用 backdoor poke 灌入,能省掉 90% 以上的仿真时间,但要留一个用例走 frontdoor 验证这些寄存器确实可从总线访问——否则「寄存器根本映射错了地址」这类 bug 会被后门完全掩盖。中断和状态寄存器读走 frontdoor,因为要同时验证读清(read-to-clear)语义;配置寄存器的回读抽查用 mirror(UVM_CHECK, UVM_BACKDOOR) 既快又能比对。故障注入用 backdoor poke 是唯一现实选择——总线协议通常不允许你写出非法字段组合。
混用时最要紧的一条纪律:backdoor 修改过的寄存器,如果它也会被总线访问,要意识到 mirror 已经由 backdoor 路径同步过一次,别让 scoreboard 拿旧 mirror 误判。复杂的混合场景可以参考 后门访问与 scoreboard 配合 的思路,把「哪条通路改的值」在检查侧记账记清楚。
六、常见坑
- HDL 路径拼错静默失败:RTL 重构、generate 层次变化后 backdoor 全挂但无报错。回归里加一个 smoke 用例对关键寄存器做
uvm_hdl_check_path,路径断了立刻暴露。 - backdoor 写配置后 frontdoor 读回来比对失败:先查字节序和位段映射(adapter 里 reg2bus 的数据宽度拼接),再查是不是寄存器块在模型里挂错了地址偏移。
- mirror 与硬件分叉:硬件自发更新的字段没标 UVM_NO_CHECK,predictor 又看不见 backdoor 活动,scoreboard 拿 mirror 比对报一堆假错误。按字段语义逐个设定比较模式。
- peek/poke 当 frontdoor 用:poke 不经过 adapter,写非法值、保留位都能成功,功能覆盖率里「总线侧写保留位」的 bin 永远打不上。
- 多 master 环境只挂一个 predictor:另一条总线上的写没人预测,mirror 漏更新。每条能访问寄存器的总线都要有自己的 monitor→predictor 链路。
- update/mirror 混用出错:
set()只改 desired 不发事务,忘记 update 就用例结束时「配置没生效」;反过来 mirror(UVM_UPDATE) 会无条件刷新 mirror 不比对,想当检查用就写成 UVM_CHECK。
这一篇在知识体系里的位置
- 向上承接:UVM 寄存器模型集成 建好 reg model / adapter / predictor 三件套,本篇解释建好后数据怎么流动。
- 横向相关:SystemVerilog TLM 通信 讲 monitor 到 predictor 的事务通路,正是 frontdoor 自动预测的传送带。
- 落地延伸:后门访问与 scoreboard 配合 展示 backdoor 数据如何在检查侧正确入账;UVM 组件与 phase 给出这些组件驻留的骨架。
总结
UVM RAL 前后门访问是同一个寄存器对象的两条数据通路:frontdoor 经 adapter 和 driver 走真实总线时序、可被 predictor 自动同步 mirror,用来验证协议路径本身;backdoor 经 HDL 层次路径零拍直达 DUT 内部信号、协议不可见,用来快速配置与故障注入——desired value 记「想写什么」、mirrored value 记「认为是什么」,凡硬件可能自发修改的字段必须靠 frontdoor 读、mirror(UVM_CHECK) 或显式 update 把两份值对齐,否则模型与硬件静默分叉就是回归假错误的最大来源。