SoC 功耗预算入门:从工艺库参数到各模块配额
本篇是芯片功耗主题里「管钱」的那一篇:功耗入门讲了功耗从哪来,低功耗设计入门讲了省功耗的手段,本篇讲的是动手设计之前,怎么把整机功耗指标拆成每个模块头上的数字——也就是功耗预算(power budget)。后续的 UPF 低功耗设计 与 功耗签核分析 都以这份预算为基准。
做 SoC 功耗预算入门这件事,本质和做家庭月度开支预算一样:先有一个总额(来自封装散热、电池、电源轨的硬上限),再按科目拆下去(CPU、GPU、DDR、IO、漏电),每个科目留裕量,执行中按月对账。区别只在于,芯片的「账本」是工艺库参数和活动率,「超支」的代价是降频、降性能甚至封装重来。
本文要回答的问题
- SoC 的总功耗上限是谁定的,为什么不能「做完再量」?
- 动态功耗、静态功耗、IO 功耗三大块各自怎么估算,公式里的参数从哪来?
- 工艺库里哪些数字直接决定预算的底色(leakage、单位翻转能耗)?
- 顶层指标怎么拆成各模块配额,裕量(margin)留多少、留给谁?
- 开源工具链做功耗估算能到什么精度,哪些地方必须诚实标注「这是演示口径」?
一、功耗上限是谁定的
功耗预算不是设计团队拍脑袋定的,它是被三条物理约束夹出来的:
- 封装与散热:一颗普通塑封 BGA 在自然对流下大概只能散掉 2-3 W;带散热片和风冷能到 10-15 W;服务器芯片上液冷才有几百 W 的空间。封装选型的那一刻,功耗天花板就定死了。
- 供电能力:板级电源轨(VRM/PMIC)能供多少电流、片内电源网络的压降(IR drop)允许多少,都是硬约束。
- 电池与续航:移动设备直接由电池容量和目标续航反推平均功耗,比如 4000 mAh 电池要撑 10 小时视频播放,平均整机功耗就必须压在 1.5 W 上下。
这三条取最小值,得到整颗芯片的功耗总额度,然后才有「预算」可谈。这也是为什么功耗预算必须在架构阶段做——等到 RTL 写完才发现超了 30%,能砍的只有频率和功能,代价惨重。
二、功耗的三大部分:动态、静态、IO
任何一块 CMOS 电路的功耗都可以拆成三个来源。先把这三大块的关系看清楚,后面所有的估算方法都只是给它们填参数。
读这张图抓住一条主线:三块功耗的「旋钮」完全不同。动态功耗的旋钮是活动率 α(clock gating、power gating 都作用在它身上)和电压频率;静态功耗的旋钮是工艺阈值电压和温度,设计上只能靠关断电源域来压;IO 功耗的旋钮是接口协议本身,改不动协议就只能在摆幅和片外端接上做文章。做预算时三块必须分开估,用一把尺子量必然失真。
动态功耗:α·C·V²·f
动态功耗的公式人人都见过:P = α · C · V² · f。预算阶段的关键不是公式,而是每个参数从哪来:
| 参数 | 含义 | 预算阶段从哪拿 |
|---|---|---|
| α(活动率) | 每个时钟周期平均有多少比例的节点翻转 | 架构仿真/经验值:逻辑 0.1-0.15,数据通路 0.2-0.3 |
| C(负载电容) | 被翻转的总电容 | 按门数/寄存器数 × 工艺库单门电容外推 |
| V(电压) | 工作电压 | 工艺节点标称值,DVFS 场景取各档分别算 |
| f(频率) | 时钟频率 | 架构规格书定的目标频率 |
注意 V 是平方项:电压从 0.9 V 降到 0.75 V,动态功耗直接省 30%。这就是为什么低功耗设计里电压是最狠的一招,也是 低功耗设计入门 里 DVFS 排在第一位的原因。
四个参数里活动率 α 的水最深。它是「平均每拍有多少比例的节点翻转」,同一段 RTL 跑不同软件差出数倍:CPU 跑整数负载和跑 memcpy 完全不是一个量级。预算阶段拿不到仿真向量时的常见做法,是从上一代产品或竞品拆解报告里抄经验值,再对关键模块(CPU、GPU、视频核)留出单独的 α 谈判空间。这也是为什么预算表里的活动率列必须写成「假设」,而不是「事实」。
静态功耗:漏电是工艺给的底色
静态功耗 P = V · I_leak,I_leak 主要来自亚阈值漏电和栅极漏电。预算阶段它完全由三个外因决定:工艺节点(越先进漏电越凶,直到 FinFET 才缓住)、阈值电压选择(HVT 单元漏电低但慢,LVT 相反)、温度(漏电随温度近似指数上升,25°C 和 100°C 结温下可以差一个数量级)。预算表里静态功耗务必标注温度条件,否则数字没有可比性。
IO 功耗:最容易漏算的一块
IO 驱动片外走线,负载电容动辄几皮法(片内连线是它的百分之一),DDR 这类高速接口在全速训练、读写时的功耗经常是「芯片内部算得挺好、一加 IO 就超支」的元凶。预算里 IO 要单列一行:接口类型 × 速率 × 摆幅标准(LVCMOS、LVTTL、SSTL…)查对应功耗系数再乘端口数。有一个容易漏的细节:片外端接电阻的直流功耗走的是板级电源,未必算在芯片额度里,但 LPDDR 这类片内端接(on-die termination)的方案,端接功耗是实打实烧在芯片上的,必须计入。
三、工艺库参数:预算的原材料
预算阶段还没有网表,估算的精度上限取决于工艺库(liberty 文件、技术文档)里能查到的那几个数:
- 单位翻转能耗:库文档会给典型门(如 1x 驱动的 NAND2、DFF)在标称电压下每次翻转的内部能耗,乘上估算的等效门数和活动率,就是动态功耗的一阶近似。
- leakage power:每个标准单元的 .lib 里都有 leakage_power 字段,分 best/typical/worst 三种工艺角。预算一般按 typical 取值、按 worst 验上限。
- 多阈值库配比:库里 HVT/SVT/LVT 单元的比例假设(比如 80/15/5)直接决定静态功耗估算落在哪一档。
下面这张封面卡给出一个演示口径的预算速览:一颗假想的中端 SoC 在 28 nm 工艺、typical 工艺角、55°C 结温下的功耗拆分示例。注意这些数字是用库参数粗算出来的演示值,不是任何真实芯片的实测,只用于说明「预算表长什么样、各部分大致量级」。
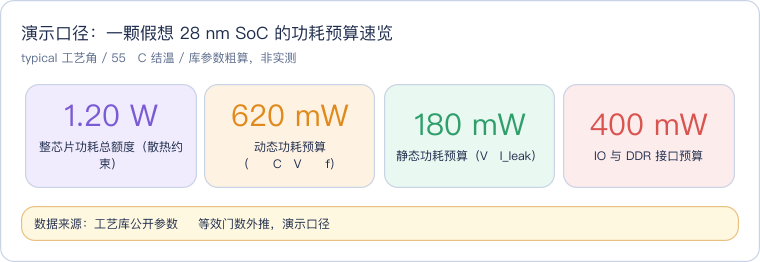
四个数字加起来正好 1.2 W,这不是巧合——预算就是「先定总额再往下分」的约束满足过程。其中动态占 52%、IO 占 33%、静态占 15%,这个比例在 28 nm 档位很典型;换到 7 nm,静态那一项会明显抬升,IO 占比则取决于外挂 DDR 的数量。
四、从总额度到模块配额:自顶向下拆分
有了总额度,下一步是把它拆到每个模块头上。拆分的输入是三份东西:架构规格书(每个模块的规模、频率、电压域)、工艺库参数(上一节的三个数)、以及场景定义——功耗预算永远要写明是「哪个使用场景」的预算,因为 SoC 不可能所有模块同时满载。
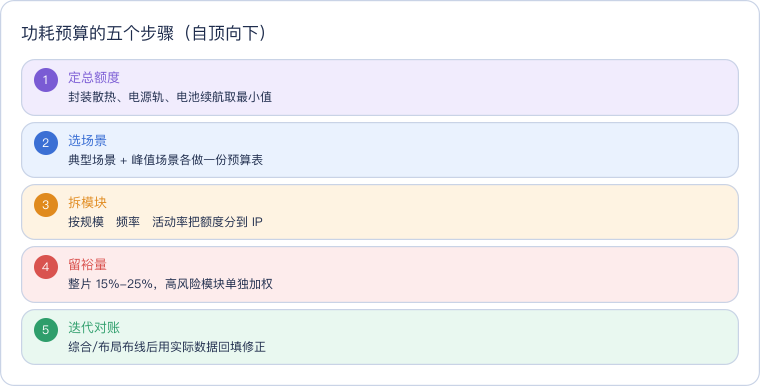
这个流程里最容易被跳过的是第二步「选场景」。视频播放、游戏、待机三个场景下,同一颗芯片的活动模块和活动率完全不同,只做一个「最坏情况」预算会把每个模块都饿死,只做典型场景又会埋下峰值过热的雷。工程上至少做两份表:典型场景定模块配额,峰值场景验证散热与电源轨。
拆到模块层面,预算表大致长这样(同样是演示口径的示例数字):
| 模块 | 频率 | 活动率假设 | 动态预算 | 静态预算 | 合计配额 |
|---|---|---|---|---|---|
| CPU 双核簇 | 1.5 GHz | 0.20 | 260 mW | 45 mW | 305 mW |
| GPU | 600 MHz | 0.25 | 200 mW | 30 mW | 230 mW |
| DDR 控制器+PHY | — | 0.40 | 180 mW | 15 mW | 195 mW |
| 视频编解码 | 500 MHz | 0.30 | 90 mW | 12 mW | 102 mW |
| NoC 互连 | 1.0 GHz | 0.15 | 70 mW | 28 mW | 98 mW |
| 外设与其他 | — | 0.10 | 50 mW | 50 mW | 100 mW |
| 小计 | 850 mW | 180 mW | 1030 mW | ||
| 裕量(约 15%) | 170 mW | ||||
| 总额度 | 1200 mW |
裕量那一行是预算表的灵魂。15%-25% 是常见的工程取值,它的去向有讲究:早期估算误差(活动率全靠猜)、工艺离散性(同一颗设计流片出来漏电可以差 20%)、以及需求变更(市场部中途加功能)。裕量不是「浪费」,是预算能在流片后依然成立的保险。
五、预算不是一次性文档:三个对账点
功耗预算在架构阶段定稿后,会在三个里程碑被「对账」:
- RTL 完成后:用 RTL 级功耗估算(门级前仿真 + 翻转率统计)回填实际活动率,偏差超过 20% 的模块要重新谈判配额。开源工具链下可以用 Yosys 时钟门控对比实验 里演示的思路做一阶估算,但要清楚它的边界——没有版图寄生参数、没有精确的时钟树电容,结果只能看相对趋势。
- 综合后:有了真实门数和初步时钟树,动态功耗估算误差收敛到 ±30% 以内。
- 布局布线后:寄生参数提取完成,进入 功耗签核分析 阶段,这是预算的最终审判。
诚实地说一句精度问题:开源链路(Yosys + 免费 PDK)可以做演示级和教学级的估算,足够讲清方法、验证相对量级;但商用芯片的功耗签核依赖代工厂签核级 PDK、带版图寄生的功耗分析工具和仿真向量,两者不是替代关系。本文所有数字表都是演示口径,读方法、别抄数字。
不同估算手段能到的精度,大致是这样一张对照表,做预算时应清楚自己手里是哪一种:
| 估算手段 | 阶段 | 典型误差 | 依赖 |
|---|---|---|---|
| 电子表格外推(门数×单位能耗) | 架构 | ±50% 甚至更多 | 库参数 + 经验活动率 |
| RTL 级功耗估算 | RTL 完成 | ±30%-40% | 仿真翻转率(SAIF/VCD) |
| 门级 + 寄生参数 | 布局布线后 | ±10%-20% | 完整 PDK + 版图数据 |
| 样片实测 | 流片后 | 基准真值 | 测试向量覆盖真实场景 |
这张表同时回答了「为什么不一开始就做准」:准的方法都依赖后阶段才有的数据,预算的价值恰恰是在没有数据的时候给出一个可问责的锚点。
六、预算做砸了的三种典型死法
- 漏算 IO/DDR:内部逻辑精打细算,DDR PHY 一开就吃掉三分之一额度。对策:IO 单列一行,按接口协议查系数。
- 忘了温度对漏电的影响:按 25°C 估的静态功耗,85°C 结温下翻倍,高温场景直接超预算。对策:静态功耗必须带温度条件,峰值场景用高温工艺角;有条件的话让系统团队给一份真实结温曲线,而不是拍一个「环境温度加二十度」。
- 裕量被提前花光:架构阶段大家来「认领」裕量,流片前发现没剩的。对策:裕量归架构负责人统一管理,模块要超配必须走变更评审,并在预算表里留一条「裕量已用/剩余」的流水记录,谁花的、为什么花,一目了然。
电源域划分、retention、isolation 这些「预算超了怎么办」的手段,属于 电源域、保持与隔离设计 的话题;用 UPF 把这些意图写成可验证的约束,则见 UPF 低功耗设计。
这一篇在知识体系里的位置
本篇处于功耗主题的「承上启下」位:上游是 功耗入门(功耗从哪来)与 低功耗设计入门(省功耗手段);本篇把这些概念落成一份可执行的预算表;下游分支到 UPF 低功耗设计(预算意图的形式化)、功耗签核分析(预算的最终对账)与 电源域、保持与隔离设计(超预算时的结构手段)。在 芯片设计总览 的流程图里,功耗预算属于架构阶段的交付物。
一句话总结
SoC 功耗预算入门就四步:散热/供电/续航三条物理约束夹出总额度;动态(α·C·V²·f)、静态(V·I_leak)、IO 三块用工艺库参数分开估;按场景把额度拆到模块并留 15%-25% 裕量;然后在 RTL、综合、布局布线三个里程碑反复对账——预算是活的文档,不是一次性的表格。