uvm_mem 存储器建模:前后门访问与 scoreboard 衔接
更新时间:2026-09-29。SV 存储器建模:关联数组与后门加载 讲了用 SystemVerilog 原语自建存储模型的路子,UVM RAL 前门后门访问:语义与选择 讲了寄存器层的两条访问通道;这一篇把两件事合起来:当 DUT 里躺着一块几 MB 的 SRAM、DDR 或 eFIFO,验证平台该怎么用
uvm_mem把它建模成一等公民,并让它跟 scoreboard 的期望数据共用同一份存储。
本文要回答的问题
uvm_mem和uvm_reg分工边界在哪?为什么大容量存储不该拆成一堆寄存器?uvm_mem的前门(burst 读写)和后门(poke/peek)各自怎么落地,HDL 路径怎么配?- scoreboard 要校验存储器内容时,期望模型该直接引用 uvm_mem,还是另建一份影子数组?
- 用 uvm_mem 做存储器测试时有哪些专属 sequence 和常见坑?
一、为什么需要 uvm_mem:uvm_reg 撑不住大容量
先看一个直觉错误:把一块 1MB 的 SRAM 声明成 262144 个 32 位 uvm_reg。寄存器抽象层的每个 uvm_reg 都是完整对象,带 mirror、field 列表、回调钩子,几十万个对象实例化下来仿真内存直接爆炸,编译时间以小时计。更根本的问题是语义不匹配——寄存器模型管的是「每个地址有独立含义的控制状态字」,而存储器是「同构单元的规则阵列,地址只是索引」。
UVM 的答案是 uvm_mem:一个对象描述整块阵列,参数只有三个维度——单元位宽、单元个数、访问属性(RW/RO/WO 及其变体)。它不维护逐地址的 mirror 值(存储器太大,镜像一份既贵又常过期),而是提供访问接口,数据存取真实发生在 DUT 或测试平台侧。
| 维度 | uvm_reg | uvm_mem |
|---|---|---|
| 建模对象 | 控制/状态寄存器,每地址语义独立 | 同构存储阵列,地址只是索引 |
| 典型规模 | 每块几十到几千个 | 几万到几十亿单元 |
| mirror 机制 | 有,desired/mirrored 双值 | 无逐地址镜像,靠显式访问 |
| field 划分 | 支持位域拆分 | 不支持,单元是同质的 |
| 典型用途 | 配置、状态、中断 | SRAM、DDR 窗口、报文缓冲、eFIFO |
工程判据一句话:软件会把某个地址 +#define 成名字的地方用 uvm_reg,软件用循环遍历、当数据池用的地方用 uvm_mem。边界场景如「带 ECC 状态位的存储器」——数据体走 uvm_mem,ECC 使能/错误注入控制位仍走 uvm_reg,两者挂在同一个 uvm_reg_block 下和平共处。
二、uvm_mem 的结构:map、offset 与访问接口
uvm_mem 在寄存器模型里的位置如下图所示:它和 uvm_reg 一样挂进 uvm_reg_map,靠 map 里的地址偏移对外可见。
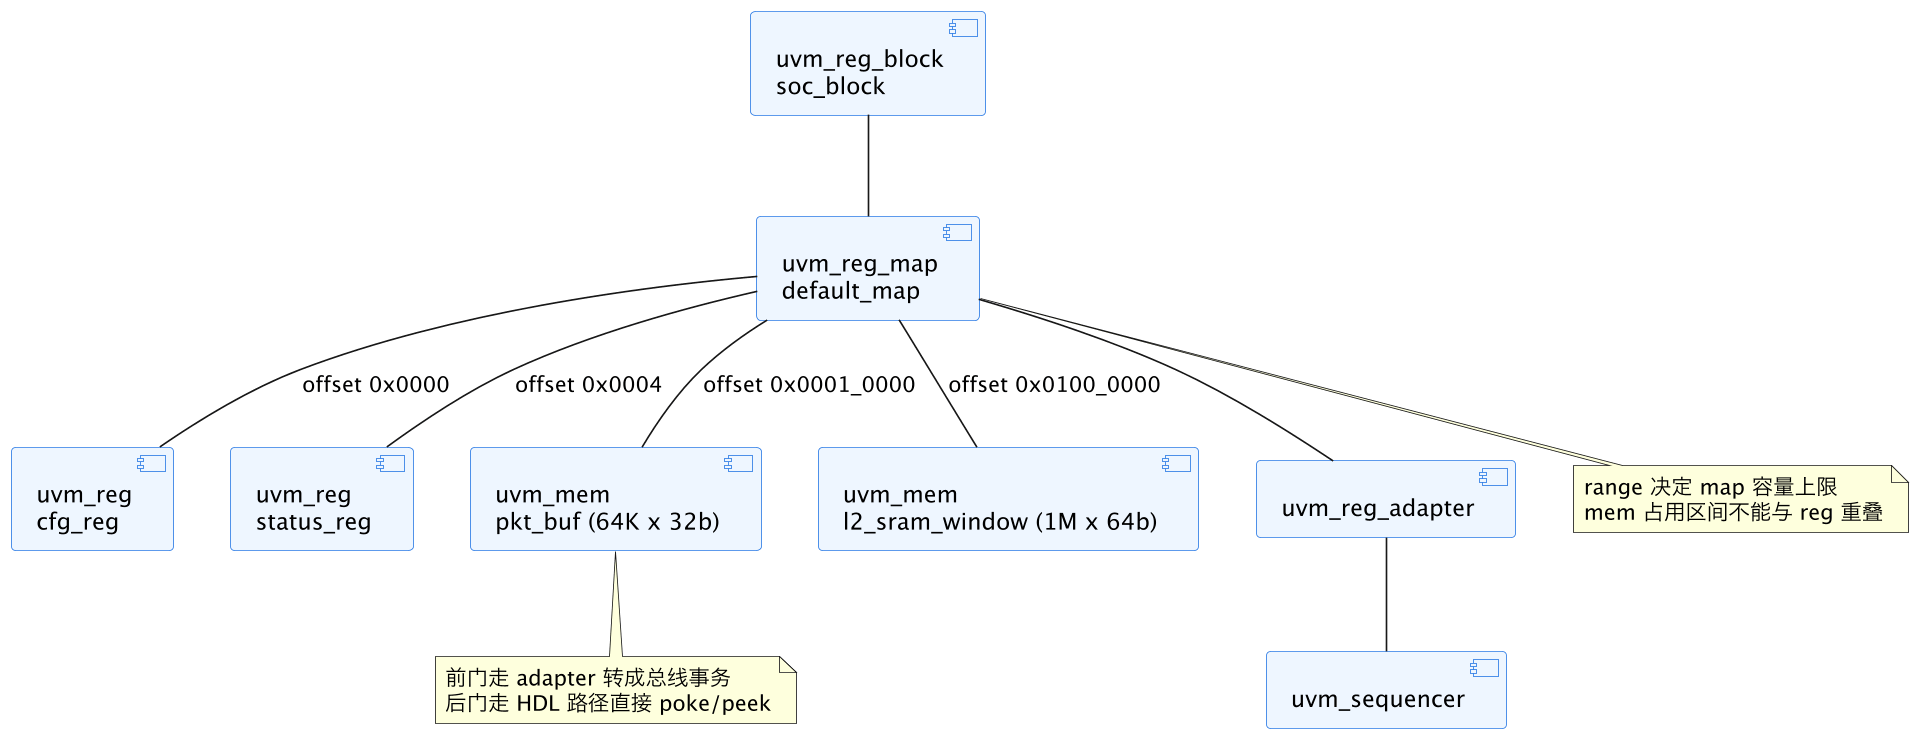
读这张图抓三个点。第一,uvm_mem 在 map 里占的是连续地址区间,区间长度 = 单元数 × 单元字节数(默认按系统地址步进对齐),与 map 里其他寄存器偏移不得重叠,重叠在 lock_model 时才报错——很多人模型建完忘了调 lock_model(),地址冲突到了仿真才炸。第二,前门访问走和寄存器完全相同的 adapter→sequencer 通道,区别只在于事务类型:寄存器是单拍 rw,存储器往往展开成 burst。第三,后门不走 map 的地址翻译,而是拿 HDL 层级路径直达 DUT 内部数组,这就是为什么 pkt_buf 和 l2_sram_window 各自挂着独立的 HDL 路径配置。
建模代码骨架:
class pkt_buf_mem extends uvm_mem;
  function new(string name = "pkt_buf_mem");
    // 单元 32 位、64K 深度、读写属性 RW
    super.new(name, 64'h10000, 32, "RW");
  endfunction
endclass

// 在 reg_block 的 build() 里:
pkt_buf = pkt_buf_mem::type_id::create("pkt_buf");
pkt_buf.configure(this, "dut_top.u_buf.u_ram.array");  // 后门 HDL 路径
default_map.add_mem(pkt_buf, 32'h0001_0000, "RW");     // 前门偏移
configure 的第二个参数就是后门锚点,路径语义与 UVM RAL 前门后门访问 里寄存器后门完全一致——相对 reg_block 的 HDL root 拼接,跨 generate 作用域时注意工具对索引路径的展开差异。
三、前后门访问:burst 展开与 poke/peek
uvm_mem 的访问 API 成对出现:write / read(前门)、poke / peek(后门),外加批量后门 burst_write / burst_read。
前门 write(offset, value) 的本质:RAL 把存储器访问封装成一个或多个 uvm_reg_item,经 adapter 翻译成总线 sequence_item 发出去。当单元位宽 64 位而总线只有 32 位数据口时,一次 write 会自动拆成两拍——这正是 map 里 n_bytes 与总线宽度协商的结果。对存储器做长连续写入时,逐单元前门调用开销很大(每次调用都过一遍 adapter 和 sequence 仲裁),性能敏感场景应该自己写 burst sequence 直接发整段 burst,再用 predict 语义同步期望值,而不是依赖 RAL 逐拍展开。
后门 poke(offset, value) 则零耗时:VPI/DPI 调用直接改写 DUT 数组元素,不消耗任何仿真拍、不经过总线。典型用途有三个:测试初始化(往报文缓冲预置几百 KB 的背景流量,前门要写几万拍,后门一拍内完成);故障注入(往 ECC 保护位里翻一个 bit 看 DUT 纠错逻辑反应);以及只写侧校验时的「干净通道」——DUT 只暴露读口给验证,写口完全靠 poke 灌激励。
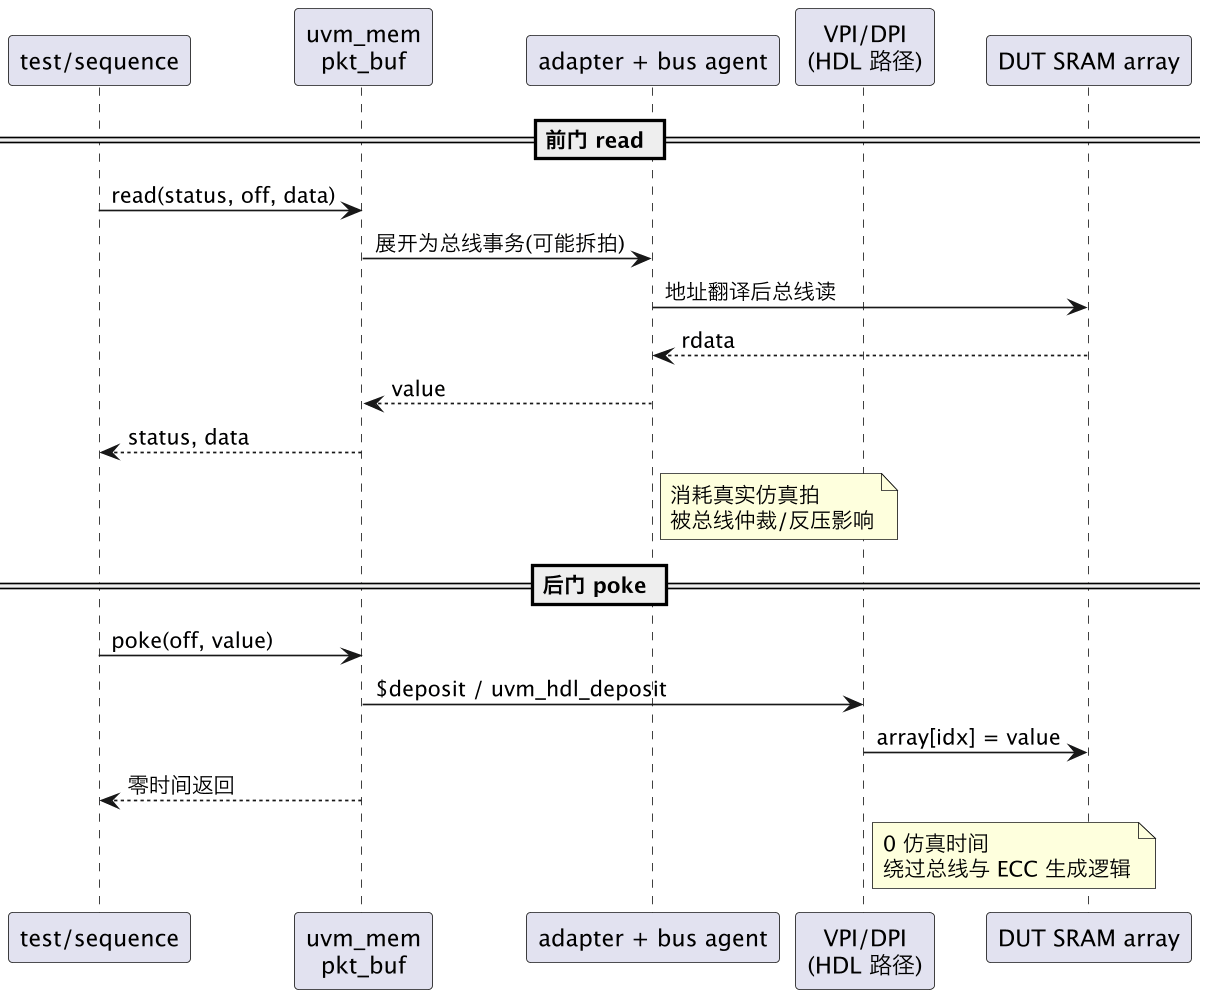
这张时序图的关键对照是代价模型:前门读消耗真实仿真拍、被总线反压影响、看到的是「软件视角的数据」(含 ECC 纠后值);后门 poke 零时间直达物理阵列,写进去的是原始比特(含校验位原始值)。踩坑点正在于此——如果 DUT 的 ECC 校验位是写入时由硬件生成的,poke 只写数据域会造成阵列里「数据已改、校验位未更新」的不一致,DUT 读出时反而报 ECC 错。处理办法是 poke 后触发一次 DUT 的 dummy 写回,或干脆把校验位也按相同算法 poke 进去。
四、与 scoreboard 衔接:一份数据,两个视角
存储器验证的 scoreboard 场景很典型:激励从某端口灌进 DUT 的处理流水线,最终落到存储阵列;scoreboard 要对照「预期该写什么」与「阵列里实际是什么」。问题是期望模型放哪。
反模式是另起炉灶:scoreboard 里再开一个 bit [31:0] exp_mem [longint],激励侧手工维护它,检查侧拿它跟 poke 出来的 DUT 数据比对。两份存储模型意味着两套初始化逻辑、两次内存开销,以及永远同步不上的 bug 温床。
推荐做法是让 uvm_mem 本身承载期望数据流:后门写激励时不用裸 poke 到 DUT,而是先 burst_write 到 uvm_mem 维护的期望侧(或通过 predictor 从总线监视事务更新期望值),检查阶段 scoreboard 调 uvm_mem 的镜像接口取期望值,再与 poke 出的 DUT 实际值逐地址 diff。scoreboard 与寄存器模型的衔接模式详见 UVM scoreboard 与 predictor:期望模型怎么建 里对显式预测的讨论。
落地结构:
| 环节 | 数据写入 | 数据读出 |
|---|---|---|
| 期望侧 | predictor 监听总线写事务 → 更新期望存储 | scoreboard 比对时逐段读取 |
| 实际侧 | DUT 流水线真实写入 | 后门 peek / burst_read 零耗时抽取 |
| 比对策略 | 检查点(如帧结束中断)触发分段 diff | 差异地址打 log,允许掩码(时间戳域等) |
两个工程细节。其一,比对时机:存储阵列内容随流水动态变化,不能随机抽测,要用 DUT 事件(帧完成中断、描述符 done 位)作为同步点,在「软件承诺不再改写该区间」的窗口内比对。其二,稀疏存储:1MB 阵列实际被激励触碰的可能只有几个区间,期望侧用关联数组 data[addr] 而非全量数组,配合 SV 存储器建模 里的稀疏化技巧,内存开销与仿真速度都立省一个量级。
五、存储器测试 sequence 与常见坑清单
uvm_mem 自带一批内建测试 sequence,通过 uvm_mem_walk_seq、uvm_mem_access_seq 等直接对存储器做走步 0/1、棋盘格、地址唯一性(address uniqueness,检测地址译码粘连)测试,寄存器模型建好即可 start(),零额外成本。对自研存储控制器,这些内建 sequence 应当进回归必跑项。
常见坑按出现频率排:
- 单元位宽与总线宽度不匹配导致前门拆拍错位——读回数据高低半字互换,根因是 map 的
byte_addressing设置与总线地址粒度不一致。 - 忘调 lock_model——地址区间重叠、后门路径拼错全部延迟到运行时才报。
- poke 破坏 ECC/parity 一致性(见第三节)。
- 前后门混用造成期望模型撕裂——前门写走了 predictor 更新期望,后门 poke 绕过 predictor,期望侧不知道数据变了;纪律是激励统一从一侧进,或后门操作后手工同步期望值。
- 把 uvm_mem 当无限容量用——在 map 里声明的区间超出 DUT 实际阵列深度,前门访问落到空洞地址,有的总线返 DECERR,有的静默回 0,后者最难查。
这一篇在知识体系里的位置
- 上游建模原语:SV 存储器建模:关联数组与后门加载 提供不依赖 UVM 的底层手段,本篇的 uvm_mem 是其标准化封装。
- 同层机制:UVM RAL 前门后门访问:语义与选择 讲透了前门/后门的通用语义与 HDL 路径写法,本篇
configure的路径规则即沿用该篇。 - 下游衔接:UVM scoreboard 与 predictor 模式 给出期望模型与寄存器模型协同的整体框架。
总结
uvm_mem 存储器建模用一个对象描述整块同构存储阵列:靠 map 偏移获得前门 burst 通道、靠 HDL 路径获得零时间 poke/peek 后门,与 uvm_reg 按「控制语义 vs 数据池」分工;scoreboard 校验时让期望数据流经 uvm_mem 统一承载、在 DUT 同步点用后门抽实比对,再警惕 ECC 一致性、前后门期望撕裂与 lock_model 缺失这三个高频坑,就能把大容量存储器验得既快又准。