位冲击序列:UVM 内建 bit-bash 序列做寄存器逐位读写自动化检查
更新时间:2026-10-02。寄存器验证里有一条最朴素也最累人的检查:芯片里几百个寄存器、几千个比特位,每一位写 1 能不能读回 1、写 0 能不能读回 0。手写定向用例逐位点一遍,一个中等模块就要写上千行,还容易漏。UVM 寄存器抽象层(RAL)内建了一条现成序列——
uvm_reg_bit_bash_seq,中文社区常称它「位冲击序列」,干的就是这件事的自动化:遍历寄存器模型里的每个寄存器、每个字段、每个位,按读写属性逐位写值读回比对。本站的 UVM 寄存器内建序列库 总览了 UVM 自带的整套寄存器序列(HW reset、bit bash、access test 等),寄存器读写属性检查 讲了字段访问属性(RO、RW、W1C 等)本身的语义,UVM RAL 前门后门访问 解释了前门与后门两条通路的差别。这一篇聚焦位冲击序列本身:它内部怎么跑、哪些字段会被跳过、为什么全绿了还可能漏 bug。
本文要回答的问题
- 位冲击序列对单个寄存器、单个位具体做了什么检查动作,比「写读比对」多在哪?
- 序列怎么决定哪些字段要测、哪些字段跳过,字段的 access policy 起什么作用?
- 跑位冲击序列前,寄存器模型和环境要满足什么前提,adapter 接错了会怎样?
- 位冲击全绿之后还有哪些坑:特殊属性字段的误报、后门镜像不同步造成的漏报?
一、位冲击序列在检查什么
「bit-bash」这个词直译是「比特猛击」——对着每一位粗暴地写 1、写 0,看硬件接不接得住。位冲击序列的核心检查逻辑对每个 RW(可读可写)位做四步:先写 1 读回,期望读到 1;再写 0 读回,期望读到 0。读写都走前门(frontdoor,即真实总线事务),所以这条序列顺带检查了:寄存器地址译码对不对(写 A 地址不能把 B 改了)、总线读写时序通不通、寄存器实现的每一位是不是真的接上了触发器而不是被优化成常量。
它和一个朴素 for 循环的区别在于「感知属性」。位冲击序列从寄存器模型里读每个字段的访问策略(access policy):RW 字段做完整的写 1 写 0 检查;RO 字段跳过(只读位写了也白写,比对它只会制造误报);WO 字段没法读回,按实现版本做写侧动作或跳过;W1C、RC 这类「读清」「写清」字段有特殊语义,通用 bit-bash 对它们要么跳过要么需要定制处理。属性标错了,序列的检查结论就错了——所以位冲击序列的质量上限是寄存器模型属性的准确度,这一点在 寄存器读写属性检查 里有展开。
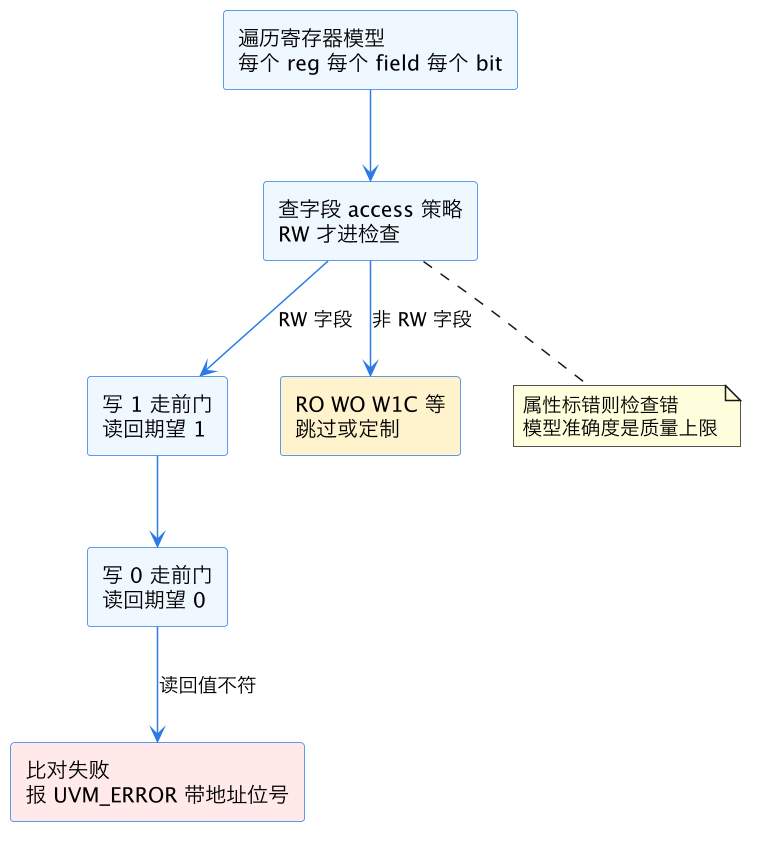
上图是位冲击序列的单字段检查流程。注意「报错带地址和位号」这一点:序列失败信息会指出是哪个寄存器的哪一位读回不对,triage 时不用从波形大海里捞针——这是它比手写脚本友好的地方之一。
二、执行前提:模型、adapter 与复位检查的顺序
位冲击序列不是拿起来就能跑的,它依赖一套已经接好的 RAL 基础设施。第一,寄存器模型要建对:寄存器块(reg block)、地址映射(map)、字段属性都要和 spec 一致,建模型与集成的完整流程见 UVM 寄存器模型集成。第二,前门通路要通:sequencer 上要有把 uvm_reg_item 翻译成总线事务的 adapter,adapter 与 predictor 的接法见 寄存器 adapter 与 predictor 接线。adapter 接错的典型症状是:位冲击序列第一位就报错,且报错的读回值全是 0 或全 X——多半不是 DUT 坏了,是事务根本没发到总线上。第三,环境里要有一个可用的 default map 和挂着总线 sequencer 的句柄,序列启动时靠 model.default_map 找到往哪个 sequencer 发事务。
使用上极简,在测试里三行就能起来:
uvm_reg_bit_bash_seq bash = uvm_reg_bit_bash_seq::type_id::create("bash");
bash.model = ral_model;   // 顶层 reg block
bash.start(null);         // sequencer 由 map 决定,传 null 即可
顺序上有一条铁律:先跑 HW reset 序列,再跑位冲击。HW reset 序列(uvm_reg_hw_reset_seq)检查复位后每个寄存器的默认值和模型里登记的 reset value 是否一致——如果复位值就不对,位冲击的读回比对会报一堆真假难辨的错,先把复位值校准再做逐位冲击,triage 成本差一个数量级。整个执行顺序与环境结构的关系,可以对照 UVM sequence driver scoreboard 里 sequence 启动的标准姿势。
三、工程化坑:全绿不等于查完,报错不等于真错
位冲击序列最容易踩的坑分两类:误报和漏报。
误报的高发源头有三个。一是字段属性标宽了:spec 里明明是 W1C 的状态位,模型里标成 RW,位冲击对它写 1 读回检查,硬件语义却是「写 1 清零」,读回 0,序列报错——这是模型的错不是 DUT 的错。二是 volatile 字段:计数器、状态标志这类硬件自己会变的字段,写完到读回之间值已经变了,比对必然失败。这类字段要在模型里用 set_volatile(1) 标注,或干脆从位冲击的候选集里排除,易变字段的访问语义见 volatile 字段访问。三是访问副作用:读某个寄存器会清中断、读 FIFO 状态会弹数据——位冲击的「读回」动作本身改变了 DUT 状态,这类寄存器要单独写定向序列,别指望通用序列兜住。
漏报更隐蔽。最常见的是「后门镜像骗过了前门比对」:如果你的环境开了自动预测(auto predict)或者比对路径混用了后门读,检查可能拿的是模型的镜像值而不是总线真实读回值,前门断了也发现不了。镜像值(mirror)与期望值(desired)的语义差别见 desired 与 mirror 语义。对策是确认位冲击的读走的是真前门事务,必要时用 寄存器后门 HDL 路径 做交叉验证:前门写、后门 peek 比对,前后门结果一致才算这位真的通了。第二个漏报点是「被跳过的字段没人管」:RO、W1C 这些被位冲击跳过的字段不是不用验,而是要靠 UVM 寄存器内建序列库 里的 access test(uvm_reg_access_seq)和定向序列补齐——位冲击只覆盖 RW 位这一格,把它当寄存器验证的全部是最典型的覆盖错觉。
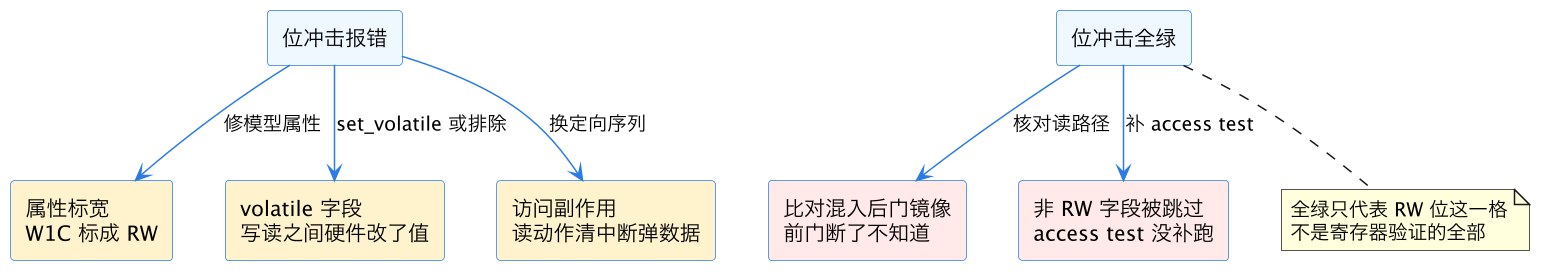
这张分诊图建议贴在寄存器验证的 run 脚本旁边:左边是「报错先怀疑模型」的三个误报源,右边是「全绿先怀疑覆盖」的两个漏报口。位冲击序列的价值是廉价的自动化底线——它几分钟就能点完几千个位,把地址译码错、位没接、属性实现反了这类低级错误批量筛掉,让工程师把时间花在真正有语义的特殊字段上。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录下 UVM 寄存器验证线的一篇长尾专题,向上承接 UVM 寄存器内建序列库 的序列总览,把其中 bit-bash 这一条拆细讲透。横向依赖四篇基础文:UVM 寄存器模型集成 解决「模型怎么建」,寄存器 adapter 与 predictor 接线 解决「前门怎么通」,UVM RAL 前门后门访问 与 寄存器后门 HDL 路径 解决「前后门怎么交叉验证」。字段属性层的语义细节在 寄存器读写属性检查 与 volatile 字段访问,镜像机制在 desired 与 mirror 语义。
总结
位冲击序列(uvm_reg_bit_bash_seq)是 UVM 内建的寄存器逐位读写自动化检查:它遍历寄存器模型,对每个 RW 位走前门写 1 写 0 读回比对,报错自带地址位号,几分钟筛掉地址译码错、位悬空这类低级 bug。用对它的三条纪律是:先跑 HW reset 校准默认值再做位冲击;字段 access 属性与 volatile 标注必须准确,否则误报淹没真错;全绿只代表 RW 位这一格,RO、W1C 等特殊字段要靠 access test 和定向序列补齐,且比对路径必须确认走真前门,防止后门镜像把断掉的前门通路伪装成全绿。