iverilog UDP 原语定义错误:表项输入数不匹配的定位与修复
UDP(User-Defined Primitive,用户自定义原语)用真值表描述一个小型逻辑单元。表格紧凑,却很容易在复制、增删输入时把某一行的列数写坏。这篇聚焦 iverilog UDP 原语定义错误 中的「输入端口数与表项输入数不匹配」,用 Icarus Verilog 13.0 的完整诊断定位到多写的一列,再比较修表与改用 always 两种写法。一般语法错误的行号定位可配合 iverilog syntax error 排查 阅读。
本文要回答的问题
UDP input port count (2)与input table entries (3)分别指什么?- 报错落在
primitive第一行,怎样找到真正写错的表项? - 输出端口是否也算冒号前的输入列?顺序 UDP 能照搬同一数法吗?
- 修正真值表后如何自检,什么情况下改用
always更合理?
先说答案:对组合 UDP,冒号左边每个符号对应一个输入端口,冒号右边是输出,不计入输入数。两个输入端口就必须逐行保留两个输入符号;报错里的 2 和 3 已经把「少一列还是多一列」说清楚了。
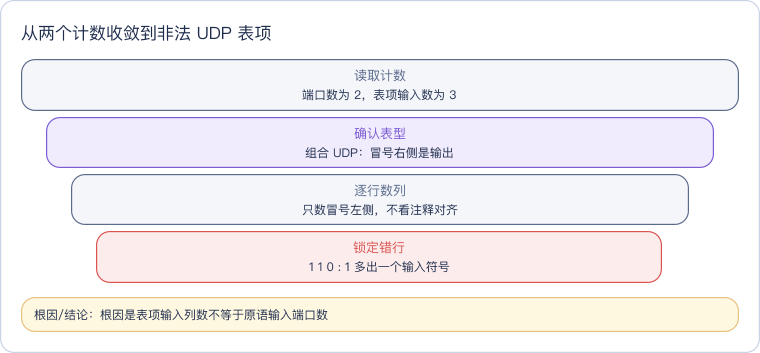
这张漏斗刻意先利用编译器给出的两个整数,而不是从第一行盲目重读全文。中间「确认表型」很重要:本文是组合 UDP,只有一组输入与输出;顺序 UDP 还有当前状态列,不能直接套这个列数公式。
一、完整报错与工具版本
反例定义两输入与门,前三行正常,最后一行在 1 1 后又写了 0:
primitive udp_and2_bad(y, a, b);
  output y;
  input a, b;

  table
    // a  b  :  y
     0  0  :  0;
     0  1  :  0;
     1  0  :  0;
     1  1  0  :  1;
  endtable
endprimitive
下面记录包含原始诊断、各阶段退出码和后续自检;当前只需看第 5 行的两个计数与第 6 行的失败状态。
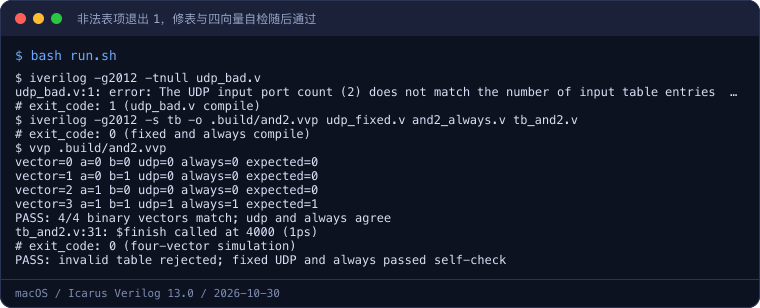
诊断原文是 The UDP input port count (2) does not match the number of input table entries (3),编译退出码为 1。版本为 Icarus Verilog version 13.0 (stable) (v13_0)。注意位置指向 udp_bad.v:1,也就是原语声明,而非最后一行:iverilog 在检查整张表时发现结构不一致,把错误归属到原语定义,具体错行仍要靠计数回去找。
二、根因:冒号前的符号数不等于输入端口数
这份原语声明了 a、b 两个输入和 y 一个输出。组合表项应读作「当 a、b 取某组值时,y 得到什么值」,所以合法行是 1 1 : 1;。错误行 1 1 0 : 1; 在冒号前提供三个符号,编译器无法决定多出的 0 应绑定哪个端口。
| 表项 | 冒号前输入符号数 | 对两输入组合 UDP 的判断 |
|---|---|---|
0 1 : 0; | 2 | 合法,a=0、b=1 时 y=0 |
1 1 : 1; | 2 | 合法,a=1、b=1 时 y=1 |
1 1 0 : 1; | 3 | 非法,多出一个输入符号 |
1 : 0; | 1 | 非法,缺少一个输入符号 |
对齐空格和注释只是排版,不参与计数;? 等合法通配符号也占一个输入位置,不会因为匹配多个值就少算一列。另一个边界是顺序 UDP:其表项还包含当前状态与下一状态,列数规则不同,不能把「两个输入就只看两列」机械套过去。
这类错误之所以容易被肉眼漏掉,是因为注释中的 a b : y 会诱导读者只检查缩进是否整齐。多个空格同样能让三列表项在屏幕上排得很漂亮,却不会改变符号数量。复制旧行再修改值时也常把上一列残留下来。更稳的读法是暂时忽略输出与注释,从左到右给每个输入符号编号:本例每一行都应当只数到 2,数到 3 的那一行就是候选根因。若所有表项都写成三列,还要反查端口声明是否本来漏声明了一个输入,而不是一味删列。
三、按计数排查,而不是逐行猜
排查顺序可以保持很短:先确认端口声明,再扫描冒号前列数,修完后必须重新编译并跑行为自检。
红色是报错入口,蓝色是两项核对,橙色与紫色分别代表修表和改写,绿色要求用结果收尾。实际检查清单只有四条:输入声明有没有漏写或多写;每个表项是否都有分号与冒号;冒号前符号数是否逐行一致;修完后原来的错误是否消失。若报错从 3 变成 1,方向就从「多列」换成「缺列」,方法不变。
四、修复代码与 always 对照
最小修复只删除末行多出的 0,保持真值表语义不变:
primitive udp_and2(y, a, b);
  output y;
  input a, b;
  table
     0  0  :  0;
     0  1  :  0;
     1  0  :  0;
     1  1  :  1;
  endtable
endprimitive
如果这个 UDP 只是在教学代码里表达普通与逻辑,always 更直观,也不必维护逐行真值表:
module and2_always(
  input  wire a,
  input  wire b,
  output reg  y
);
  always @(*) begin
    y = a & b;
  end
endmodule
两种写法不是任何场景都能随意互换。选择时看建模目的,而不是只看哪边行数少。
| 情况 | 更合适的选择 | 原因 |
|---|---|---|
| 保留原语接口、做小真值表模型 | 修正 UDP | 表格直接对应输入组合,局部修复成本低 |
| 普通 RTL 组合逻辑、表达式很清楚 | always 或连续赋值 | 逻辑关系可读,增删输入不必改整张表 |
| 多分支优先级或条件行为 | always | case、if 比铺开真值表更易维护 |
| 依赖 UDP 特定未知态查表语义 | 保留 UDP | 改成运算符前必须重新定义并验证未知态行为 |
always @(*) 会自动覆盖右侧信号的敏感项,本例每条路径都给 y 赋值,不引入锁存意图。单一表达式其实用 assign y = a & b; 还更短;需要 case 分支时,always 的优势才更明显。
五、复跑 PASS:数值自检覆盖到哪里
测试平台把相同的 a、b 同时送给修复后的 UDP 和 always,逐个检查 00、01、10、11,既对照预期值,也对照两种实现。原始输出如下:
$ iverilog -g2012 -s tb -o .build/and2.vvp udp_fixed.v and2_always.v tb_and2.v
# exit_code: 0 (fixed and always compile)
$ vvp .build/and2.vvp
vector=0 a=0 b=0 udp=0 always=0 expected=0
vector=1 a=0 b=1 udp=0 always=0 expected=0
vector=2 a=1 b=0 udp=0 always=0 expected=0
vector=3 a=1 b=1 udp=1 always=1 expected=1
PASS: 4/4 binary vectors match; udp and always agree
# exit_code: 0 (four-vector simulation)
这里能下的结论是:非法版本退出 1,修复版编译退出 0,四个二值向量仿真退出 0 且结果一致。它没有覆盖 x、z,也没有做综合实验;尤其 UDP 未覆盖的输入组合与按位运算符的未知态传播可能不同,不能拿这四个向量推出全四态等价。
实验环境
- 机器/系统:MacBook Pro x86_64 / macOS(Darwin 25.5.0)
- 工具版本:Icarus Verilog 13.0 stable(
v13_0),使用同一安装附带的vvp - 日期:2026-10-30
- 完整命令:
bash run.sh,脚本依次执行iverilog -g2012 -tnull udp_bad.v、iverilog -g2012 -s tb -o .build/and2.vvp udp_fixed.v and2_always.v tb_and2.v、vvp .build/and2.vvp;标准输出与标准错误合并记录。
代码获取
反例、修复版、always 对照、四向量测试平台、运行脚本和真实日志均在公开仓 https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/ts-iverilog-primitive-udp-error。安装 iverilog 后进入该目录运行 bash run.sh,即可复现退出码 1 的非法表项诊断以及修复后的 PASS。
这一篇在知识体系里的位置
本篇属于 EDA 排错目录 中「iverilog 编译期原语校验」节点:它处理语法能读出、但 UDP 表结构与端口声明不一致的问题。若编译器只给出笼统的 syntax error,应先按 iverilog 语法报错行号定位 检查分号、括号和关键字,再进入本篇的表项计数排查。
总结
遇到 iverilog UDP 原语定义错误,先看报错中的输入端口数和表项输入数:组合 UDP 的冒号前每一列对应一个输入,输出不占输入列,报错指向 primitive 行也不妨碍逐行找到错表项。局部错列就修表,真值表难维护且不需要 UDP 特定语义时改用 always;无论哪条路径,都以重新编译和覆盖目标输入空间的自检收尾。