CUDA 统一内存:一个指针两边用,页面随缺页自动迁移
更新时间:2026-09-25。在第一个 CUDA 程序里,kernel 本身只有几行,但把数据送进 GPU 的样板代码往往比计算还长:分配主机内存、分配显存、拷贝、同步、再拷回。本篇讲 CUDA 从 2013 年(Kepler + CUDA 6)起提供的另一条路——Unified Memory(统一内存):只分配一次,CPU 和 GPU 拿到同一个指针,页面在谁缺页时就搬到谁那里。它消灭的是拷贝代码,不是数据搬运的物理成本。
本文要回答的问题
- 传统
cudaMalloc+cudaMemcpy模式到底痛在哪,为什么指针要分「主机籍」和「设备籍」? cudaMallocManaged给出的指针为什么两边都能解引用,底层谁在搬页面?- page fault 驱动的页面迁移按什么粒度进行,4KB 和 2MB 两种页对性能差多少?
- prefetch、
cudaMemAdvise、over-subscription、多 GPU 按需迁移分别解决什么问题? - 统一内存为什么反而可能更慢,thrashing(乒乓抖动)长什么样、怎么规避?
一、传统模式的痛点:两套指针、三段拷贝、两份数据
先回忆没有统一内存时的标准写法。要让 GPU 对一个数组做平方,代码骨架是这样的:
int *h_a, *d_a;
h_a = (int*)malloc(N * sizeof(int));          // 主机指针:CPU 能访问
cudaMalloc(&d_a, N * sizeof(int));            // 设备指针:只有 GPU 能访问
for (int i = 0; i < N; ++i) h_a[i] = i;       // CPU 准备数据
cudaMemcpy(d_a, h_a, N * sizeof(int), cudaMemcpyHostToDevice);  // 显式搬入
square<<<grid, block>>>(d_a);                 // kernel 只能吃设备指针
cudaMemcpy(h_a, d_a, N * sizeof(int), cudaMemcpyDeviceToHost); // 再搬回痛点不在多敲几行字,而在它逼程序员同时管理两个地址空间。主机指针传给 kernel 解引用,得到的是 GPU 地址空间里的非法地址,直接挂掉;设备指针在 CPU 上 dereference 同样是段错误。同一份逻辑数据必须存两份(主机一份、显存一份),生命周期要手动对齐:先 H2D(Host to Device)再算再 D2H,方向参数写反、拷贝字节数算错、释放顺序颠倒,每一个都是经典 bug。
第二个痛点是拷贝边界必须提前知道。数据要在 kernel 启动之前整块搬好,结果要在 kernel 结束之后整块搬回,无法表达「GPU 算到一半发现需要某个数据结构,临时读一下主存」这类动态访问。链表、树、稀疏哈希这类指针密集的数据结构,在独显上几乎没法用——你没法把一串主机指针逐一翻译成设备指针,除非自己序列化重建。
第三,拷贝是真实占用 PCIe 时间和两端资源的同步动作。PCIe 4.0 x16 单向约 32 GB/s,PCIe 5.0 x16 约 64 GB/s,而 HBM 显存带宽在 2~3.35 TB/s 量级,桥比仓库门窄一到两个数量级(详见独显与集显的内存路径)。1 GB 数据过 PCIe 4.0 理论上就要约 30 ms,小批量高频拷贝还会被启动开销进一步摊薄带宽。
还有一个隐藏的工程细节:malloc 给的普通可分页内存(pageable memory)不能被 GPU 直接 DMA,cudaMemcpy 时驱动要先把数据拷进一块锁页暂存区(pinned/staging buffer)再发起 DMA,等于暗中多搬一次。想跑到接近峰值带宽必须自己用 cudaMallocHost 分配锁页内存,而锁页内存占多了操作系统无法换页、整机响应变差。传统模式连「数据先放进哪种主机内存」都要程序员操心。
二、cudaMallocManaged:一个指针,两边解引用
统一内存把上面的骨架改成这样:
int *a;
cudaMallocManaged(&a, N * sizeof(int));       // 只分配一次
for (int i = 0; i < N; ++i) a[i] = i;         // CPU 直接写
square<<<grid, block>>>(a);                   // GPU 直接用同一指针
cudaDeviceSynchronize();
printf("%d\n", a[0]);                          // CPU 直接读结果
cudaFree(a);
cudaMallocManaged 返回的是一个托管指针(managed pointer):它落在统一的虚拟地址空间里,CPU 和 GPU 的页表都能解析这个地址,但任一时刻物理页只待在一处——主机内存或某块 GPU 的显存。代码里再也没有 h_a 和 d_a 的区分,没有 cudaMemcpy,没有方向参数。分配时页面甚至不必立刻落到任何物理位置,首次触碰时才就位。
把两种模式摆在一起对比:
| 对比维度 | 显式拷贝(cudaMalloc + cudaMemcpy) | 统一内存(cudaMallocManaged) |
|---|---|---|
| 指针数量 | 主机、设备两个指针,不能混用 | 一个托管指针,CPU/GPU 两边解引用 |
| 数据副本 | 主机和显存各一份,手动保持一致 | 任一时刻物理上只有一份,按需放置 |
| 数据移动 | 程序员显式发起,需指定方向和字节数 | page fault 驱动,运行时自动迁移 |
| 启动前要求 | 数据必须整块提前搬好 | 不要求,访问到哪里搬到哪里 |
| 指针型数据结构 | 需手动序列化/重建指针 | 可直接透传链表、树等宿主数据结构 |
| 首次访问开销 | 拷贝成本已提前一次付清 | 首次触碰触发缺页,延迟高且分散 |
| 容量上限 | 受显存容量硬限制 | 可 over-subscription,用主机内存兜底 |
| 性能可控性 | 传输时机和大小完全可控 | 依赖运行时判断,可能乒乓抖动 |
| 适用心智 | 批量、规整、数据驻留 | 原型开发、不规则访问、动态数据结构 |
托管分配还接受一个附加参数,表达页面的默认可见范围:cudaMemAttachGlobal 表示对设备上任何流的 kernel 都可见(默认值),cudaMemAttachHost 表示只与当前主机线程关联、配合流使用。日常代码几乎只用默认值,但这个参数的存在提醒我们:统一内存仍是在明确的执行上下文里共享,不是「全局随便访问」。设备属性里另有一个 concurrentManagedAccess 标志,标明 GPU 是否支持 kernel 运行期间 CPU 同时访问托管内存;不支持的老设备上,运行时会在 kernel 边界直接做整段同步,并发收益归零。
需要说明代际前提。Kepler(CUDA 6,2013)的初代统一内存还不支持缺页,本质是启动 kernel 时自动整段迁移;从 Pascal(2016,GP100)起 GPU 硬件加入了可恢复缺页(recoverable page fault)和 49 位虚拟地址,统一内存才真正变成「访问到哪、迁移到哪」;Pascal 配合 POWER9 + NVLink 还支持 ATS(Address Translation Services),GPU 直接复用 CPU 页表。所以下文描述的完整行为对应 Pascal 及之后的显卡,2020 年后的数据中心卡和消费卡全部在此之列。
三、缺页驱动迁移:一次页面迁移的时序
核心机制和 CPU 上的按需调页(demand paging)是同一个思想,只是缺页者可能是 GPU。GPU 的访存请求经过自身的 MMU 查页表,发现目标页不在本地显存(页表项标记为不在或在另一端),触发一次可恢复的 page fault。出错的 warp/warp 组被暂停——注意不是整个 GPU 停摆,其他 warp 照常调度,这正是warp 调度器用并发隐藏延迟的机制——CUDA 运行时批量收集缺页,向另一端发起页面迁移。
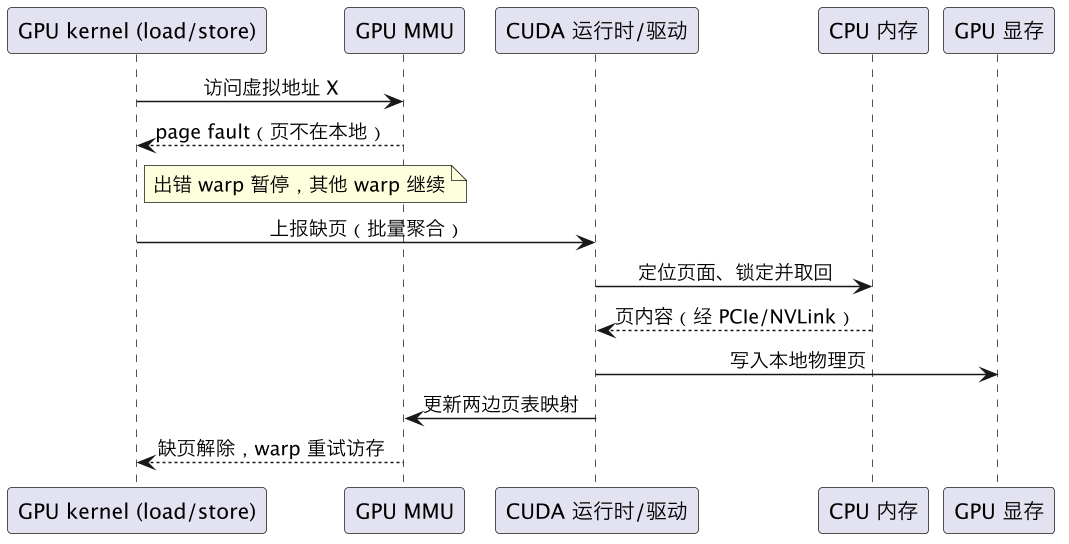
几个细节决定了真实性能。其一,缺页是批量处理的:驱动不会一页一中断,而是把一段时间窗口内的缺页聚合成一次迁移列表,所以连续区域的首次访问效率远好于随机点刺。其二,迁移是有方向的所有权转移:页面迁到 GPU 后,CPU 侧旧映射被标记为无效;之后 CPU 再访问,对称地触发一次反向缺页、页面迁回。其三,迁移期间的数据通道就是 PCIe 或 NVLink:PCIe 4.0 约 32 GB/s、PCIe 5.0 约 64 GB/s,NVLink 3/4 可做到约 600~900 GB/s,通道带宽直接决定缺页恢复的快慢。
还有一个一致性边界值得记住:默认配置下,托管内存在 kernel 运行期间不允许 CPU 并发访问,kernel 启动相当于一道隐式栅栏,运行时借此避免两端同时写同一页的复杂同步;需要 CPU 与 GPU 细粒度并发时,要通过 attach 标志、流关联和显式的同步事件自行划分安全区间。这也说明统一内存是「单一地址空间」而非「放开所有竞争」,缓存一致性的边界仍由驱动和硬件协议把守。
四、迁移粒度:4KB 基页与 2MB 大页
页面迁移按页进行,页多大是关键参数。x86 标准基页是 4KB,这也是 CUDA 统一内存默认的迁移粒度:缺一个 4 字节的 int,搬的也是整个 4KB 页。听起来浪费,但页内其余数据随后访问就是本地命中,访问连续数组时反而高效;真正吃亏的是随机稀疏访问——每碰一个 4KB 区域就要付一次缺页税。
更大的粒度是 2MB 大页(x86 huge page,Linux transparent huge page)。应用通过 cudaMemAdvise 配合系统大页配置,或在较新 CUDA 版本中让托管分配自动获得 2MB 对齐的大页,迁移单元就从 4KB 放大 512 倍。收益有两层:单次迁移的协议开销被摊薄,大区块顺序迁移更容易吃满通道带宽;TLB 覆盖范围扩大 512 倍,缺页和 TLB miss 双双减少。代价是稀疏访问时的内部浪费同样放大,以及大页要求分配对齐且内存碎片紧张时可能分配不到。
给一组量级直觉:单次缺页从上报到页面在另一端可用,在 PCIe 上常见为几十微秒量级的延迟(其中协议和同步开销占大头,4KB 字节的纯传输时间在 32 GB/s 通道上本不到 0.2 微秒)。这解释了为什么「零散首次访问」极慢、而大块连续迁移的有效带宽能逼近 PCIe 峰值——固定开销被字节数摊薄了。反过来算笔账:同样过 PCIe 4.0,一次搬 2MB 大页的有效带宽可以接近通道峰值,而每次只缺一个 4KB 页、页间还要重新走一遍几十微秒的协议,有效带宽可能只剩峰值的百分之一二。迁移粒度对性能的杠杆,比大多数人直觉中的大得多。IBM POWER 平台基页为 64KB、大页 16MB,ARM 常见 4KB/16KB/64KB 可配,机制相同数字不同。
五、把猜测变成提示:prefetch、advise、超分与多 GPU
运行时靠缺页推断意图,但程序员往往早就知道数据接下来归谁用。CUDA 提供两类提示把信息显式交出去。
预取 cudaMemPrefetchAsync(ptr, bytes, device, stream) 在不触发缺页的情况下,把一段托管内存主动搬到指定设备,可以塞进流里和别的操作并行:
cudaMemPrefetchAsync(a, N * sizeof(int), 0, 0);   // kernel 前先搬到 0 号 GPU
square<<<grid, block>>>(a);
cudaMemPrefetchAsync(a, N * sizeof(int), cudaCpuDeviceId, 0);  // 算完预取回 CPU
预取把分散在 kernel 执行中的几十微秒级缺页停顿,换成一次连续、可与计算重叠的大块传输,是把统一内存程序从「能跑」调到「跑得快」的头号手段。建议 cudaMemAdvise 则传递不改变正确性的偏好:SetReadMostly 允许多个 GPU/CPU 对同一只读页各留副本(读后不撤销映射,省掉只读共享场景的来回搬运);SetPreferredLocation 指定页面偏好的驻留端,适合「数据主要在 GPU、CPU 偶尔瞄一眼」的情形。配合异步拷贝流水的做法见 CUDA Stream 与异步拷贝。
**Over-subscription(超分/超额订阅)**让分配大小可以超过显存物理容量:托管缓冲总量大于显存时,GPU 不碰的冷页面退回主机内存驻留,工作集在显存和主存之间按需滚动。这让「模型差一点塞不进显存」的程序能跑起来,也简化了超大缓冲区的原型开发。可以拿 CPU 的虚拟内存类比:进程申请的地址空间远大于物理内存,靠的是页框在内存和磁盘间滚动;统一内存只是把「磁盘」这一层换成了主机内存(而主机内存自己不够时才继续下沉到 swap),滚动的触发者从 CPU 缺页换成了 GPU 缺页。但要清楚慢通道的位置:走 PCIe 的页面滚动约 32~64 GB/s,相对 HBM 的 2~3.35 TB/s 慢约三五十倍;若主机内存也不够、落到磁盘 swap,则是几千倍的降速,性能呈阶梯式崩塌。超分保证的是功能正确,热工作集仍应压在显存之内。
多 GPU 场景下,每个 GPU 都能缺页。一页被二号卡首次访问,就迁到二号卡;之后一号卡再访问,会通过 GPU 间互联(NVLink 或 PCIe P2P)迁回,不必绕道 CPU。结合 SetReadMostly,只读数据(典型如模型权重)可在多卡各留副本,只有写访问才引发所有权迁移。反过来,切分数据集做并行(每卡各自负责一块不相交的区域)时,最好用 SetPreferredLocation 或预取把每页的归属提前固定,否则运行时按首次缺页就近分配,负载一旦不均衡,页面会在卡际频繁搬家——本质仍是抖动,只是发生在 GPU 与 GPU 之间。
六、代价与反模式:thrashing 乒乓及规避
统一内存最典型的性能事故是乒乓抖动(thrashing):同一页面被 CPU 和 GPU(或两块 GPU)高频交替写,每次切换访问者都触发一次反向迁移。迁移通道再宽也架不住一个 4KB 页在几微秒内来回过 PCIe——固定的缺页协议开销(几十微秒级)远超实际传输字节,有效带宽可能跌到不足 1 GB/s,比手写 cudaMemcpy 还差。
抖动的根源是数据归属与访问模式不匹配,规避思路都围绕重建归属。第一条:按阶段归边,组织成「CPU 批量准备 → 预取到 GPU → GPU 批量计算 → 预取回 CPU → CPU 批量消费」,杜绝在 kernel 运行期间让 CPU 逐页改写同一数组。第二条:只读共享用 SetReadMostly,让两端各持副本,避免读后迁移;权重、查找表这类一次写入、多处反复读的数据最适用。第三条:单边偶尔访问用 SetPreferredLocation,页面常驻主用方,偶尔访问的一端经互联直接读而不抢所有权。第四条:连续大区块访问优先开启 2MB 大页并在 kernel 前预取,把缺页风暴降级为一次流式传输。第五条:用 profiler 验证——Nsight Systems 时间线上的 page fault 与 migration 事件会直接显示停顿位置和迁移方向,别凭感觉判断,先看数据再动手改。
另一个常被忽视的代价是首次访问延迟不可预测:同一个 kernel,第一次跑在还冷的托管内存上可能慢数倍,预热后才进入稳态;做性能测量时必须把迁移阶段和稳态计算分开计时,否则结论全错。
用一个具体场景收尾。假设 kernel 每处理一个元素都要回头让 CPU 更新一个计数器(原子加在同一页上),那么这页在每轮交替访问里来回过 PCIe:几十微秒的迁移协议,换一次几纳秒的本地加法,万倍的开销浪费在搬家路上。改造方法不是放弃统一内存,而是把计数器改成每个 GPU 线程块的本地累加、kernel 结束后只归并一次——页面归属于是变成「kernel 期间归 GPU、收尾时归 CPU」,迁移次数从百万次降到个位数。这个例子代表了通用心法:减少的不是计算,而是访问者切换的次数。
这一篇在知识体系里的位置
本篇是 GPU 编程模型系列中关于「数据怎么放、怎么搬」的一篇:上承第一个 CUDA 程序的 kernel 基本形态和 GPU 架构:warp 调度器的缺页暂停/延迟隐藏机制;与集成 GPU 统一内存互为软硬件两面——那篇讲物理上共用内存的 UMA 机器,本篇讲物理上仍有显存/主存之分、靠页面迁移营造统一地址空间的独显路线;传输与计算重叠的工程手段见 CUDA Stream 与异步拷贝。往底层看,页表与 TLB 的 CPU 侧原理可对照 MMU/TLB 虚拟内存。
总结
CUDA 统一内存用 cudaMallocManaged 返回一个 CPU 和 GPU 两边都能解引用的托管指针,把传统模式下「两套指针、两份副本、cudaMemcpy 三段式显式拷贝」替换成 page fault 驱动的自动页面迁移:GPU 缺页页面经 PCIe(约 32~64 GB/s)或 NVLink(约 600~900 GB/s)搬到显存,CPU 再访问则迁回,默认按 4KB 基页、可放大到 2MB 大页以摊薄每页几十微秒级的固定缺页开销;cudaMemPrefetchAsync 预取和 cudaMemAdvise(ReadMostly/PreferredLocation)把运行时的猜测变成确定提示,over-subscription 允许显存超分、用主机内存兜底,多 GPU 间按缺页按需迁移、只读页可各留副本;代价是首次访问缺页慢、测量需区分冷启动与稳态,以及 CPU/GPU 高频交替写同一页导致的乒乓抖动——规避之道是让数据按阶段归一边、预取成块传输、只读共享留副本,记住统一内存消灭的是拷贝代码,从来不是数据物理流动的成本。