LUT 当移位寄存器 SRL:一个 LUT6 如何变出 32 拍延迟
本篇属于 FPGA 入门资源原理篇。前置阅读:LUT 与 FF 深入:6 输入 LUT、触发器与 slice 给出了 CLB/slice 的全景,本篇把其中一句话带过的 SRL 单独展开;相关资源选型见 BRAM vs 分布式 RAM,资源报告里 SRL 在哪一行见 读懂资源利用率报告。
本文要回答的问题
- 数据要延迟 32 拍再用,除了级联 32 个触发器,FPGA 还提供了什么更省的物理资源?
- 一个本来用来实现组合逻辑真值表的 LUT6,为什么能变身 32 位移位寄存器(SRL32)?
- SRL 的「动态地址抽头」是什么意思,为什么说移位是时序行为、读抽头却是组合行为?
- RTL 怎么写,综合器才会推断成 SRL 而不是一串 FF?什么写法会让它放弃推断?
- SRL 为什么不能整体异步复位?级联 SRL32 做几十上百拍延迟线时要注意什么?
一、没有 SRL 的世界:32 拍延迟要 32 个 FF
数字设计里到处是「把数据推迟 N 拍」的需求:同步电路里对齐时序的流水线、滤波计算里的历史数据窗、串行协议里的位计数、按键消抖里的等待计数。最朴素的实现是触发器级联——第一拍 FF 记住输入,第二拍 FF 记住第一拍的输出,数据每过一个时钟沿往前走一级,32 拍延迟就需要 32 个 FF 首尾相连。
在 7 系列 FPGA 里,一个 slice 只有 8 个 FF。32 个 FF 意味着占用相当于 4 个 slice 的全部寄存器配额,外加这些 FF 之间的本地布线;延迟线拉长到 128 拍、256 拍,就是十几、几十个 slice。更麻烦的是,这些 FF 的 D 输入端只连前一级 Q,干的是天底下最单调的活:原样搬运一个比特。
Xilinx 从 4 输入 LUT 时代(SRL16)起就为这种单调活准备了专用用法:把 LUT 内部的存储位接成一条移位链。到 6 输入 LUT,一个 LUT6 就能实现最多 32 拍延迟(SRL32),这就是 LUT 当移位寄存器 SRL 的用法。下面这张对照卡给出两种实现同一条 32 拍延迟线的资源量级。
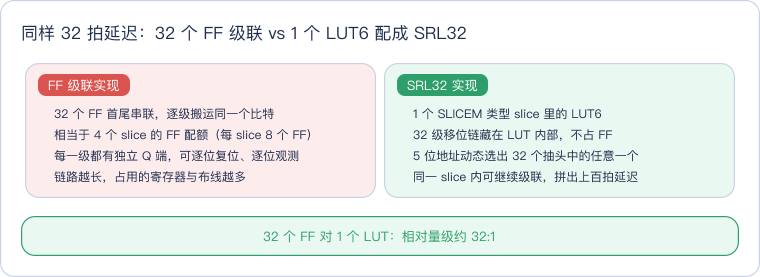
读这张卡要抓住一点:对比的不是两种电路写法,而是同一份 RTL 语义在硅片上的两种落地形态。综合器既可以把逐级延迟摊成 32 个 FF,也可以识别出「这只是一条移位链」然后收进一个 LUT。资源报告中对应的行叫做 LUT as Shift Register,它涨了多少,就说明有多少延迟线被收进了 SRL。
二、LUT6 的真身:64 个存储位,凭什么能移位
要看懂 SRL,先破除一个常见误解:LUT 不是一块「组合逻辑电路」,它的本体是一小片存储器。一个 6 输入 LUT 内部有 64 个 1 位配置存储位,加一个 64 选 1 多路器。普通逻辑模式下,6 个输入是逻辑函数的自变量,64 个存储位里写的是真值表(由比特流配置),多路器按输入组合选出对应的那一位输出——任何 6 输入布尔函数都不过是一张 64 行的真值表。
SRL 模式下,这批存储位换了一种活法:它们不再是静态的真值表,而是被接成一条首尾相接的移位链。每个时钟沿,链上的位整体向后移动一级,串行输入 D 被移入第一级;5 个原作用址端的输入改作抽头地址 A[4:0],控制一个 32 选 1 多路器,从链中 32 个节点里选出一个送到输出端 Q。于是同一个物理 LUT,对外呈现为一个 32 位深、1 位宽的移位寄存器,这就是 SRL32 这个名字的来历(SRL = Shift Register LUT)。4 输入 LUT 时代对应 16 位深的 SRL16,命名规律一致。
这张结构图里蓝色是输入与控制,紫色是移位链本体,灰色是选择器,橙色是两个输出。有两个细节值得注意。其一,SRL 只能用 SLICEM 类型的 slice(M = Memory),SLICEL 里的 LUT 只做逻辑;7 系列大约一半 slice 是 SLICEM,所以 SRL 资源不是无限的,但远比 FF 级联省地。其二,LUT 有两个内部输出,除了经地址选通的 Q,末级还有一个专用的 Q31(级联输出),专门用于把多个 SRL 不用外部布线直接串起来;双输出结构在拆成 16 位模式时还能让同一 LUT 同时承担 SRL16 与一点相关逻辑。UltraScale 架构延续了同名 SRL32 用法,细节以对应族的 Libraries Guide 为准,本篇只定性。
三、移位是时序的,读抽头是组合的
SRL 的行为可以拆成两条完全独立的路径,理解这条分界是用好它的关键。写路径(移位)是时序的:只在时钟沿、且 CE 有效时发生,链上各位向后挪一格;CE 为低时整个链冻结,多少拍都不丢数据。读路径(抽头)是组合的:A[4:0] 是一组普通选择信号,地址一变,32 选 1 多路器立刻换一路输出,不占时钟沿,也没有读出使能。
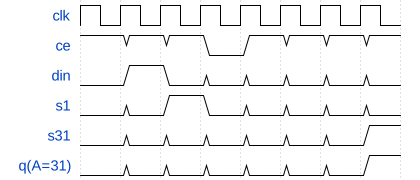
这张波形示意了一个比特在链内的旅程(中间级数已省略):din 在第二个时钟沿被采入,一级之后出现在 s1;CE 在第四个周期被拉低,该周期整链保持、数据不前进;最终这个比特抵达最后一级 s31,此时若抽头地址 A[4:0] = 31,Q 端就输出它。改变地址不需要任何时钟配合——把地址从 31 改成 7,Q 立刻变成链中第 7 级的现值,这就是「动态地址抽头」:一个 SRL32 同时藏着 32 个不同延迟的版本,你用地址当场点一个出来。
这条分界带来一个工程推论:Q 到下游触发器之间隔着一个 32 选 1 多路器加布线,是组合路径。长链满档使用、且地址动态变化时,这条路径可能成为时序收敛的负担。常见做法是在 SRL 输出端再放一个普通 FF 收口(原语层面即 SRL + FF 的固定搭配),把组合读变成「下一拍可见」,时序立刻干净。
四、32 个 FF 与 1 个 LUT:资源与时序全面对比
数量对比之外,两种实现还有一系列行为差异,这些差异决定了什么场景该选谁。
| 维度 | 32 个 FF 级联 | 1 个 SRL32(LUT6) |
|---|---|---|
| 资源占用 | 32 个 FF,约 4 个 slice 的寄存器位 | 1 个 SLICEM 的 LUT,FF 不动 |
| 位宽扩展 | 每加 1 位数据宽度,整条链复制一遍 | 同样每位一个 LUT,但每 LUT 顶 32 级 |
| 任意级读出 | 每级 Q 都在布线上,可并行全部读出 | 一次只能读 1 个地址抽头(另有 Q31) |
| 动态抽头 | 要加 32 选 1 MUX 自己选 | 5 位地址原生支持,零额外逻辑 |
| 复位/预置 | 每级可独立同步/异步复位 | 无复位端口,不能整体清零 |
| 保持 | CE 控制(省 FF 时要自己写使能) | 原生 CE,为低时整链保持 |
| 输出时序 | 每级 Q 都是寄存器输出,干净 | 抽头 Q 是组合输出,常加 1 个 FF 收口 |
| 上电初值 | 取决于 INIT/复位设计 | 可由比特流给配置初值,但非运行时复位 |
| 典型场景 | 需要逐位访问、要复位的流水线 | 固定/可变深度延迟线、历史窗、对齐缓冲 |
表中最反直觉的是「任意级读出」这一行:FF 级联虽然费,但 32 个节点的信号物理上都存在,想并行看任意几级都可以;SRL 极省,但链内节点只有被地址选中的那一个走到了引脚,它本质上是一条串行链而不是一个寄存器堆。这也是后面选型边界的核心依据。
五、RTL 怎么写,综合器才推断 SRL
综合器推断 SRL 的模式很固定:识别出一组只做「逐级搬运、没有逐位复位、按旧值赋新值」的寄存器。下面给出三种典型写法。
第一种是拼接赋值,最常见也最不容易出错。每拍把整个向量左移一格、新比特补在最低位,读的时候用变量索引抽头:
module srl_dyn_tap #(
    parameter WIDTH = 32
)(
    input  wire              clk,
    input  wire              ce,
    input  wire              din,
    input  wire [$clog2(WIDTH)-1:0] addr,  // 动态抽头地址
    output wire              q
);
    reg [WIDTH-1:0] sr;

    always @(posedge clk) begin
        if (ce)
            sr <= {sr[WIDTH-2:0], din};     // 整链后移,新位进最低位
    end

    assign q = sr[addr];   // 变量索引读 = 动态地址抽头
endmodule
只要 WIDTH 不超过单个 LUT 的 32 级,综合器就会把 sr 收进一个 SRL32;固定读最后一级 sr[WIDTH-1] 同样会推断,区别只是抽头地址被常数传播掉。
第二种是 parameter 化的长延迟线,用 for 循环描述任意深度,超出 32 级时工具会自动级联多个 SRL:
module delay_line #(
    parameter W = 8,        // 数据位宽
    parameter N = 65        // 延迟拍数
)(
    input  wire          clk,
    input  wire          ce,
    input  wire [W-1:0]  din,
    output wire [W-1:0]  dout
);
    reg [W-1:0] sr [0:N-1];
    integer i;

    always @(posedge clk) begin
        if (ce) begin
            sr[0] <= din;
            for (i = 1; i < N; i = i + 1)
                sr[i] <= sr[i-1];          // 逐级搬运
        end
    end

    assign dout = sr[N-1];
endmodule
第三种是数组形式的索引赋值,语义与循环等价,也是合法的推断模板:
always @(posedge clk) begin
    if (ce) begin
        sr[0] <= din;
        sr[1] <= sr[0];
        sr[2] <= sr[1];
        // ……固定深度时可逐行展开
    end
end如果设计意图明确、又担心被优化策略干扰,可以用属性显式表态。SHREG_EXTRACT 控制「要不要把移位寄存器收进 SRL」,SRL_STYLE 进一步控制 SRL 与 FF 的排布(例如首尾各保留一个 FF,便于加复位和收敛时序):
(* SHREG_EXTRACT = "yes" *) reg [31:0] sr;   // 强制允许推断 SRL
(* SRL_STYLE = "reg_srl_reg" *) reg [63:0] long_sr;  // 首 FF + SRL + 末 FF
属性只点到这里,取值与优先级以所用 Vivado 版本的综合属性手册为准。写完后务必和资源报告对账:LUT as Shift Register 是否如期增加、FF 是否如期下降,报告读法见 读懂资源利用率报告。
六、复位语义坑:SRL 为什么不能整体清零
SRL 最常见的坑是复位。很多工程师给延迟线顺手加上系统复位,结果综合后发现 SRL 一个没推断出来,FF 数量照旧——因为 SRL 原语根本没有复位端口。回看第二节的结构图:32 个存储位是一条首尾相咬的链,硅片上没有一根能同时触及所有级的清零线。要给它加复位,只有一条路:放弃 SRL,改用 32 个带复位端的 FF。
下面这行代码就是「推断杀手」,它一出现,整个移位向量回退成 FF 阵列:
always @(posedge clk) begin
    if (rst)
        sr <= 32'b0;        // 有了这句,工具只能用带复位的 FF 实现
    else if (ce)
        sr <= {sr[30:0], din};
end工程上按三档处理。不需要复位的纯延迟/对齐(绝大多数延迟线都属于此类——数据在流通过程中本就不需要「清零的历史」):直接不写复位,享受 SRL。只要求出口确定:用前面提过的 reg_srl_reg 风格,SRL 主体不复位,只在末级那个 FF 上复位,延迟线在复位释放后若干拍自然排空。内部每一级都要可控、可观测:不要犹豫,用 FF,并接受资源代价——这通常意味着它其实不是一条延迟线,而是一组工作寄存器。另外,SRL 可以通过比特流配置给上电初值(INIT),但那是配置态行为,不是运行时复位,别拿它当清零用。复位设计的一般原则见 时钟与复位:同步复位、异步复位与复位树。
七、级联 SRL32:65 拍、128 拍与更长延迟线
超过 32 拍怎么办?SRL 为此留了专用的级联通道:上一个 SRL 的 Q31 直接进下一个 SRL 的 D 输入,走 slice 内部的专用连线,不占通用布线资源;同一个 slice 里的多个 SLICEM LUT 可以串成 128 级一条链,跨 slice 再继续延伸。综合器看到 N > 32 的 parameter 延迟线时,会自动完成这种级联。
这张图画的是 65 拍延迟线的典型落地:两个 SRL32 串联承担 64 拍,末尾一个 FF 承担第 65 拍并收口时序,紫色是 SRL、绿色是收口寄存器。若需要在长链中间取抽头(比如可配置深度的延迟缓冲),对每段 SRL 分别给地址、再加一个小 MUX 选段即可,如图中灰色支路。实践中有两个注意点:链越长,数据从第一级走到最后一级的时间不变(始终是 N 个时钟周期),但每段抽头的组合路径都要单独过时序,抽头越多越要认真约束;超长延迟线(成百上千拍、多位宽)在 LUT 里铺开后会和逻辑抢 SLICEM,这时应该算一笔账——也许一块 BRAM 搭成的循环缓冲或 FIFO 更划算,异步 FIFO 的存储选择见 异步 FIFO 与跨时钟域。
八、边界:什么时候不该用 SRL
SRL 省资源,但它省的是「移位」这一个动作。以下几种需求看似也是「存几个数」,实则不该用 SRL。
需要并行读出多个历史值。 滑动求和、FIR 滤波器的数据窗要同时拿到最近 N 个样本——SRL 一次只给一个抽头,硬用就得配大量多路器,反而不划算。短窗用 FF 阵列(综合器还能用折叠结构优化加法),深窗换 BRAM 缓存;FIR 的数据组织见 FIR 滤波器入门。
需要按任意地址读写的小存储。 多拍写、随机读、还可能读改写,这是 RAM 语义而不是移位语义:浅表选分布式 RAM,深表选 BRAM,二者的推断规则与属性见 BRAM vs 分布式 RAM。记住三者的分工——FF 管可逐位控制的状态,分布式 RAM/BRAM 管随机访问,SRL 管先进先出的纯延迟。
需要整体清零、预置或位独立可见。 上一节讲过,这类需求直接用 FF。反过来,流水线中的打拍寄存器如果既不需要复位中间级、也不需要观测每一级,恰恰是 SRL 的好目标,CE 语义可参考 计数器与时钟使能。
深度极大的位流式延迟。 数百上千拍的延迟(视频行缓存、网络包缓冲)应当评估 BRAM 地址指针方案:一块 18Kb BRAM 的深度是上千个 SRL 级联的量级,还天然双端口。SRL 适合几十拍以内、位宽不大、要求零等待零控制开销的延迟。
这一篇在知识体系里的位置
本篇是 LUT「第二副业」的深讲,向上承接 LUT 与 FF 深入:6 输入 LUT、触发器与 slice 中 CLB 与 slice 的物理结构。它和存储家族的另外两篇构成三角:BRAM vs 分布式 RAM 解决「数组落到哪」,本篇解决「纯延迟落到哪」,更深入的存储组织在 BRAM/URAM 存储设计。验证综合结果靠 读懂资源利用率报告,复位与 CE 的通用纪律分别在 时钟与复位 和 计数器与时钟使能。应用侧,长延迟线与抽头会在 FIR 滤波、异步 FIFO 与跨时钟域 等场景反复出现。
总结
LUT 当移位寄存器 SRL,本质是把 LUT6 内部的存储位从「静态真值表」改接成「32 级可寻址移位链」:移位在时钟沿按 CE 时序进行,5 位地址用 32 选 1 多路器组合读出任意抽头,Q31 专供片内级联。于是一条 32 拍延迟线从 32 个 FF(约 4 个 slice 的寄存器位)收缩为 1 个 SLICEM LUT。让综合器推断 SRL 的关键是写出纯粹的逐级搬运语义(拼接、for 循环、索引赋值皆可),且不给链加整体复位——SRL 物理上没有复位端口,需要复位时只在首尾 FF 上做。级联 SRL32 可得上百拍延迟,末级加 FF 收口时序;但要并行读历史、随机访问、整体清零或极深缓冲时,分别回到 FF、分布式 RAM/BRAM——SRL 只为「先进先出的纯延迟」而设计。