FPGA 进阶 44:资源优化实战——砍 LUT/BRAM/DSP 的系统方法
本文是
fpga/进阶层第 48 篇。原理基础:流水线与资源优化、DSP48、BRAM、定点位宽、HLS 数组分区;资源-速度-时序联动见时序收敛案例。
本文要回答的问题
- 利用率报告怎么读、瓶颈资源怎么定位?
- 时分复用、存储合并、DSP 复用各自怎么做、代价是什么?
- 位宽/深度这些参数旋钮怎么按需求收紧?
- 砍资源的边界和风险在哪?
一、先定位:utilization 报告按层次看
| 超标资源 | 常见大头 | 首要手段 |
|---|---|---|
| DSP48 | 多通道乘法器/FIR、并行算法 | 时分复用、位宽收窄、级联累加 |
| BRAM/URAM | FIFO/帧缓存过深、小 RAM 散落 | 深度重算、小 RAM 合并、位宽收窄 |
| LUT | 复杂 mux/状态机、除法、LUTRAM | 存储推 BRAM、常数运算换移位、死代码 |
| FF | 冗余流水、超大寄存器组 | 平衡流水级、状态编码、位宽 |
二、四大策略
1. 时分复用(时间换空间)
N 个并行单元 → 1 个单元 N 倍时钟轮转:
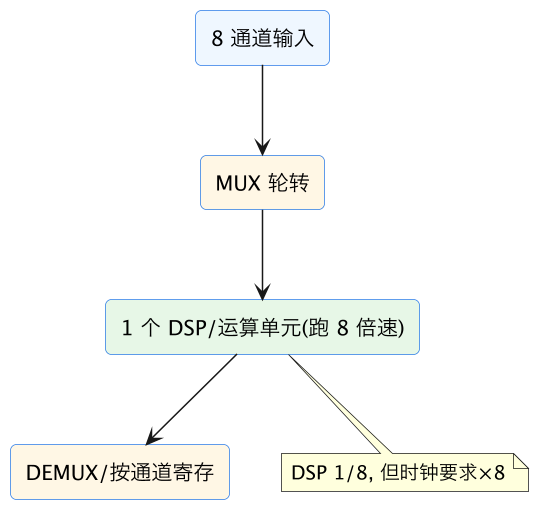
前提:时钟 ≥ N × 数据率;代价:频率要求、控制 mux、延迟。
2. 存储优化
- 深度重算:FIFO 按深度公式来,不拍脑袋;
- 小 RAM 合并:散落小缓冲 → 一块大 RAM + 地址偏移时分访问;
- 同步读写风格让工具推 BRAM,别让数组退化成 LUTRAM;
- ROM/系数表进 BRAM,位宽按量化精度收窄。
3. DSP 复用与推断
- 乘法确保推断进 DSP48(有符号、流水级匹配),加法用 DSP 级联链;
- 多通道共享 DSP(同策略 1);
- 大乘法拆分对位 DSP 的 25×18 位宽;
- 位宽收窄是根本(见下)。
4. 逻辑层
- 常数除法/取模 → 移位或乘法移位(变量除法极费 LUT);
- 状态机编码(独热 vs 紧凑)、去死代码/不可达分支;
- 宽总线按算法最小位宽;
- 去掉不必要的流水级(FF 省了且延迟降)。
三、参数旋钮与流程
位宽、FIFO 深度、并行度全部参数化,用参考模型和自检 TB 支撑收缩:
- 报告定位最大头;
- 定点分析收位宽(定点 DSP)、重算缓冲深度;
- 改架构(复用/合并);
- 综合对比资源和时序(拥塞改善时序常一起变好);
- 自检 TB 回归保证功能/精度。
四、权衡边界
- 时分复用提频率要求——时序贴顶时慎用;
- 资源率 >85% 后布线拥塞,时序和构建时间恶化,目标留 15%~20% 余量;
- 砍资源别伤接口带宽和 FIFO 防丢能力;
- 降资源也常降动态功耗(功耗估计)。
常见坑对照
| 坑 | 后果 | 正确做法 |
|---|---|---|
| 不看报告到处优化 | 白费功夫 | 按层次找最大头 |
| FIFO 深度拍脑袋 | BRAM 浪费/不够 | 按突发公式算 |
| 小数组退化成 LUTRAM | LUT 被吃光 | 同步风格/显式 BRAM/合并 |
| 变量除法/取模 | 巨量 LUT | 常数化/移位近似 |
| 位宽一刀切 32bit | DSP/BRAM 翻倍 | 定点分析收窄+TB 验证 |
| 复用后频率跟不上 | 时序崩 | 先算时钟裕量 |
| 资源用到 95%+ | 拥塞、构建慢 | 留 15~20% 余量 |
相关与延伸
原理:流水线与资源优化、DSP48、BRAM/URAM。 支撑技术:定点设计、FIFO 深度、HLS 分区/资源、参数化。
一句话总结
资源优化先看 utilization 按层次定位最大头再对症:DSP 满→时分复用(N 个乘法器变 1 个跑 N 倍时钟轮转)+位宽收窄+级联累加;BRAM 满→FIFO 深度按公式重算、散落小 RAM 合并成大块时分访问、同步读写风格防退化成 LUTRAM;LUT 满→查存储推断、常数除法取模换移位、状态机和死代码清理;FF 满→平衡冗余流水。位宽是最省的旋钮(数据通路从 32bit 收到 16bit,DSP/BRAM 近减半),但必须靠定点分析和自检 TB 防精度溢出。纪律:时分复用的代价是时钟频率要求(时序贴顶慎用)、资源率留 15%~20% 余量防拥塞、每次改动对比资源+时序并回归功能——资源/速度/功耗是三角权衡,按瓶颈类型选刀。