SV wait_order:内建事件顺序断言的语义边界、常见误用与 fork/join 表达力对比
更新时间:2026-10-04。SystemVerilog 的进程同步工具箱里,
wait_order是一个存在感很低却语义独特的成员:它接收一组事件标识符,按声明顺序依次阻塞等待,只有事件严格按照这个顺序触发才放行,任何一个「插队」触发都会立刻抛运行时错误。很多验证工程师第一次遇到它是在 scoreboard 的乱序匹配调试里——想用一行语句表达「必须先发 req 再发 ack」,写下了wait_order(req_ev, ack_ev),结果仿真莫名其妙报了一堆 order violation,或者反过来,明明失序了却安安静静地通过。这两种症状背后都是对wait_order语义边界的误解。站内的 SV event triggered 与 wait 对比 讲了事件等待的两种基本形态,SV 进程 fork/join 控制 讲了并发分支的三种 join 语义,SV wait 与事件同步模式 梳理了常见同步套路。这一篇聚焦wait_order这一个语句:它到底承诺什么、不承诺什么,什么时候该用它、什么时候必须换成 fork/join 手写。
本文要回答的问题
wait_order的精确语义是什么,它和「依次 @ 事件」等价吗?- 事件在
wait_order注册之前触发,会被算进去还是被吞掉? - 同名事件重复出现在参数里、事件带
persist状态时,行为有什么坑? wait_order失败时报什么错,怎么在 testbench 里优雅地捕获而不是让仿真崩掉?- 顺序检查场景下,
wait_order、@链、fork/join、SVA 四种写法各适合什么场合?
一、精确语义:顺序匹配,失序即错
wait_order 的语法极简:wait_order (event1, event2, event3);,可选尾部跟一个 else 分支。LRM 定义的语义是:当前进程挂起,开始按参数顺序监视这些事件的触发;event1 先触发则转入等待 event2,依次推进,全部按序触发后语句通过、进程继续;任何一个「还没到它」的事件提前触发(比如 event3 在 event2 之前触发),整个语句失败,执行 else 分支——没有写 else 时,仿真器报运行时错误(多数工具是 error 级别,仿真中止或按 $error 处理)。
event req_ev, ack_ev, done_ev;

initial begin
  wait_order(req_ev, ack_ev, done_ev)
    $display("顺序正确");
  else
    $display("失序:有事件插队");
end关键在「监视」二字:wait_order 不是「先等 event1、再等 event2」的两段式阻塞,而是从语句执行的那一刻起就同时盯着所有参数事件。这是它和 @event1; @event2; 这种 @ 链写法的本质区别——@ 链在等待 event1 期间,event2 触发多少次都无所谓(没人看),等轮到等 event2 时只看它之后的触发;而 wait_order 在等待 event1 期间就把 event2、event3 的提前触发判为失序。
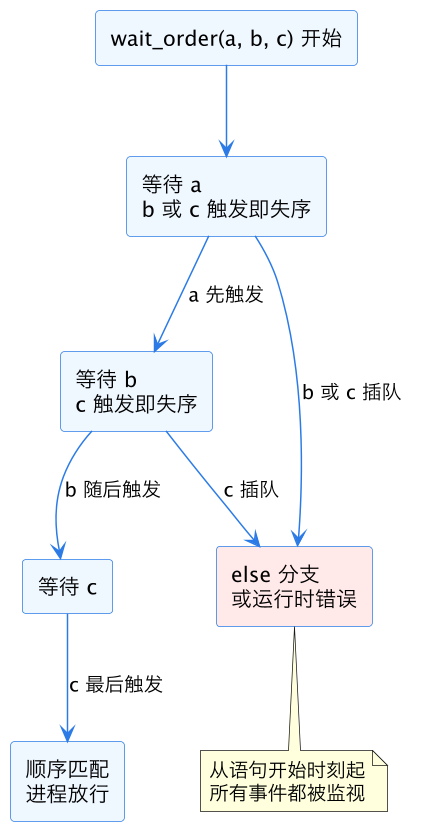
上图把 wait_order 的状态推进画清楚了:每通过一个事件进入下一个等待态,但在任何等待态里,「未轮到」的事件触发都直接落入失败分支。理解这一点,后面所有误用案例都能自己推出来。
二、三个语义暗坑
第一个坑,语句执行前触发的事件一律不算。wait_order 从进程执行到这一行才开始监听,之前触发过的事件(包括命名事件这种没有持久状态的)完全被忽略。如果 testbench 里事件由另一个进程触发,而 wait_order 进程因为调度顺序晚启动了一个时间片,第一个事件就丢了——轻则失序报错,重则死等(第一个事件再也不会来,进程永久挂起)。这正是 SV event persistent trigger 里讨论的命名事件「触发即消散」问题在顺序检查上的投影:事件没有记忆,监听者必须在场。工程对策是让触发方和等待方用 handshake 对齐,或者用 uvm_event 这类带持久语义的替代品,而不是裸 wait_order 跨进程赌调度顺序。
第二个坑,同名事件重复出现不等价于「触发两次」。wait_order(a, a) 的直观理解是「a 触发两次」,多数仿真器确实这么实现——第一次在 a 上触发推进到第二段,第二段再等 a 的下一次触发。但这里有个时序陷阱:如果 a 的两次触发在同一个时间步里连续发生(比如 -> a; -> a;),第一段匹配后进程还没有机会进入第二段的监听态,第二次触发可能直接被判失序或被吞掉,行为依工具而异。可移植的写法是定义两个不同事件分别触发。
第三个坑,失败路径的代价被低估。不写 else 时,失序是运行时错误,很多回归环境把任何 runtime error 都视为 testbench 崩溃,整轮回归标红——而你可能只想把它当一个 scoreboard mismatch 记录下来继续跑。写了 else 则完全静默,失序只是执行 else 分支,不在 UVM 报告体系里留任何痕迹,忘了在 else 里调 uvm_error 就等于把检查关掉了。两种形态都不是默认安全的,必须显式选择。
三、与 fork/join、@ 链、SVA 的表达力对比
顺序检查在验证里有四种主流写法,各自的语义和适用场合值得摆在一起看。
| 写法 | 语义 | 失序行为 | 适合场合 |
|---|---|---|---|
wait_order(a,b,c) | 严格顺序,全程监视 | else 分支或运行时错误 | testbench 内短序列、要显式处理失序 |
@a; @b; @c | 依次阻塞,不监视插队 | 失序被静默吞掉 | 只关心「都发生过」的宽松时序 |
| fork/join + 手写状态 | 并发等待,逻辑自定义 | 完全自己控制 | 乱序匹配、超时、部分序 |
SVA 序列 a ##1 b ##1 c | 时钟采样的严格时序 | assertion fail 进报告体系 | 接口级周期精确检查 |
@ 链的问题是「看不见失序」:b 在 a 之前触发十次,链式写法照样放行,这在 scoreboard 里就是漏检。fork/join 的问题是「什么都要自己写」:三个事件的严格顺序检查用 fork/join 写出来要维护状态变量和 disable fork,代码量翻几倍,但它的回报是表达力——乱序匹配(out-of-order)、超时窗口、部分序这些 wait_order 根本表达不了的场景,只有手写并发能覆盖。SV scoreboard 乱序匹配 里的关联数组按 ID 匹配方案,本质上就是 fork/join 表达力路线的工程化产物。SVA 则是另一条赛道:它工作在时钟采样域,表达的是周期级时序关系,适合接口协议检查;而 wait_order 工作在零时间的事件域,两者不重叠——想用 wait_order 检查「a 后三拍内 b」是做不到的,它没有拍的概念。
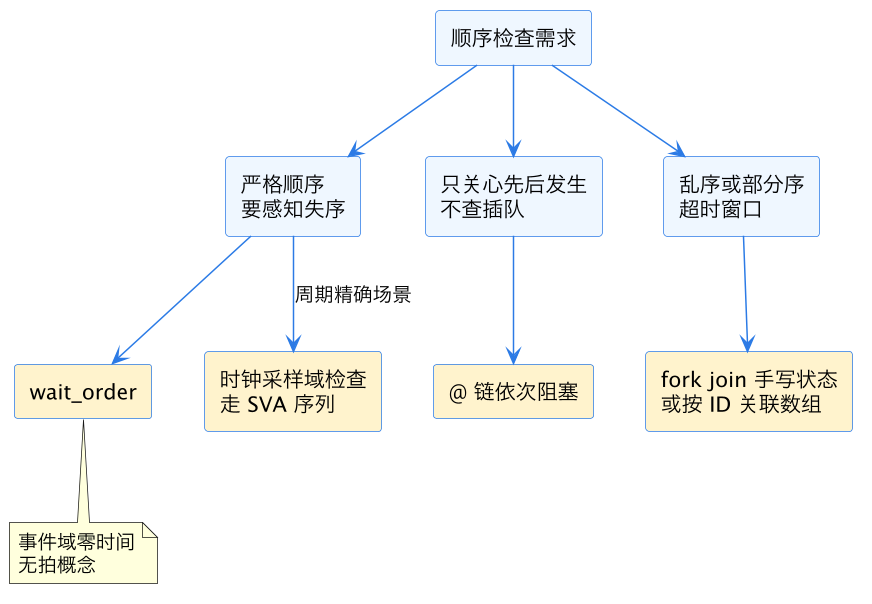
这张选型图的核心信息是:wait_order 占据的是一个很窄的生态位——事件域、严格顺序、需要感知失序、且不需要拍级精度。四个条件缺一个,就该往别的分支走。
四、工程实践建议
落到代码纪律上,四条。一,wait_order 永远写 else 分支,并在分支里显式调 `uvm_error 或 $warning,让失序进入报告体系而不是静默或崩溃。二,触发方与等待方之间用握手对齐启动时刻,杜绝「事件先于监听注册」的竞态;跨组件的顺序检查优先考虑 uvm_event_pool 的持久事件(见 UVM event pool 与 barrier)。三,参数列表里不出现重复事件、不依赖同时间步多次触发的行为,这类需求改手写。四,需求一旦超出「严格全序」——乱序、超时、可重复事件——直接走 fork/join 手写或 SVA,不要用 wait_order 打补丁式硬凑,凑出来的检查语义谁读谁误解。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录下 SV 语言机制线的一篇 L 层长尾文,主关键词 SV wait_order。向上承接 SV event triggered 与 wait 对比 的事件等待基础和 SV event、semaphore、mailbox 的同步原语谱系。横向与 SV 进程 fork/join 控制(并发分支语义)、SV wait 与事件同步模式(常见同步套路)、SV fork 清理与 objection(并发进程收尾)互为补充——本文讲清 wait_order 的窄生态位,把「超出全序检查」的需求分流到这几篇对应的方案。向下,scoreboard 顺序/乱序匹配的工程落地见 SV scoreboard 乱序匹配 与 SV scoreboard 队列实现。
总结
SV wait_order 的语义是「从语句执行时刻起全程监视所有参数事件、严格按序放行、失序走 else 或报运行时错误」,它与 @ 链的区别在于能感知插队、与 fork/join 的区别在于表达力只覆盖严格全序;使用时要避开三个暗坑——监听注册前的事件被吞、同名重复事件在同时间步的行为不可移植、失败路径默认要么崩回归要么静默——工程纪律是必写 else 并显式上报、触发等待双方握手对齐、超出严格全序的需求直接转 fork/join 手写或 SVA 序列,让每种顺序检查都落在语义匹配的工具上。