时钟 latency 标注:source latency、network latency 与 propagated 时钟的区别(STA 入门)
时钟树综合(CTS)的物理实现见 CTS 时钟树综合,签核阶段完整的 STA 方法学见 黄金 STA 与 PrimeTime;本篇聚焦其中一个入门必考、又最容易写错的小字段——时钟 latency 标注:
set_clock_latency写在哪、写多少、什么时候必须删掉换成set_propagated_clock。SDC 整体写法见 综合约束工程。
本文要回答的问题
- 静态时序分析(STA,Static Timing Analysis)里的时钟 latency 到底指哪一段时间?
- source latency 和 network latency 分工有什么不同,分别用什么命令标注?
- ideal clock 和 propagated clock 两种口径差在哪,CTS 前后为什么必须切换?
- 怎么用
report_clock_timing自查 latency 标注是否生效、是否写重?
一、时钟 latency 是哪一段时间
数据路径的延迟好理解:信号从触发器 Q 端出发,穿过组合逻辑到达下一级 D 端。但时钟信号自己也要「走路」——它从时钟源(比如芯片顶层的 PLL 输出或时钟输入端口)出发,经过时钟树上的一串 buffer 和走线,才到达每个触发器的 CK 引脚。这段时钟从定义点走到触发器时钟引脚所花的时间,就是时钟 latency。
STA 为什么要关心它?因为 setup/hold 检查比较的是「数据到达时刻」和「时钟到达时刻」:发射时钟沿走得慢,数据就有更多时间(对 setup 有利);捕获时钟沿走得慢,捕获窗口整体后移。两条时钟路径延迟的差值就是时钟偏斜(clock skew),直接进时序方程。latency 标错了,skew 就错,整条 signoff 结论都是虚的。
按 SDC 的惯例,这段路被切成两截:
| 分段 | 物理范围 | 标注方式 |
|---|---|---|
| source latency | 时钟源头(PLL/晶振)→ SDC 里 create_clock 的定义点(通常是芯片端口) | set_clock_latency -source |
| network latency | create_clock 定义点 → 每个触发器的 CK 引脚(芯片内部的时钟树) | set_clock_latency(不带 -source)或由工具实算 |
切分点在 create_clock 挂的那个端口/引脚上。记住一句话:source 段在芯片外或定义点之前,工具永远算不到,只能你告诉它;network 段在芯片内,CTS 之前只能估,CTS 之后可以让工具算。
还有一个容易混淆的概念要顺手区分:insertion delay(插入延迟) 在不少工具报告里泛指「时钟从源头到触发器的总延迟」,它约等于 source latency 加 network latency 之和。CTS 报告里说的「insertion delay 太长」通常指树内那一段偏大,提示时钟树要优化;而 STA 报告里的 clock network delay 往往只含定义点之后那截。读报告时先看清楚口径,否则会把两份报告里不同的数当成矛盾。
二、latency 构成图与两条命令
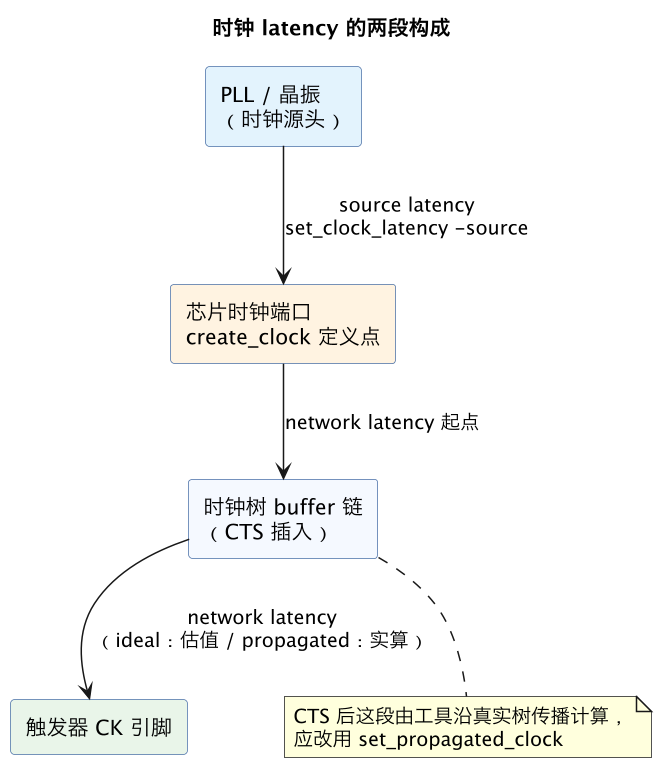
图里从左到右就是时钟的一次完整旅程。对应到命令只有两条:
# source 段:PLL 到芯片端口花了 0.8ns(上升/下降、min/max 可分设)
set_clock_latency -source -rise -max 0.85 [get_clocks CLK]
set_clock_latency -source -rise -min 0.75 [get_clocks CLK]

# network 段(仅 CTS 前的 ideal 模式用):树内估计 1.2ns
set_clock_latency -max 1.25 [get_clocks CLK]
set_clock_latency -min 1.15 [get_clocks CLK]
几个工程要点:
-source只修饰源头那一段,且它参与「时钟从绝对原点出发」的累计,对 generated clock 的源到主时钟源那段也生效;不带-source的 network latency 是加在定义点之后的。- min/max 要分开标。hold 检查走 min 角、setup 走 max 角,只标一个值等于假定另一角相同,会藏掉一部分悲观度。
- source latency 的数值来源是 PLL 规格书的锁定时间、输出到引脚的封装/板级走线预算,不是拍脑袋;它和 IO 预算一样,属于接口合同的一部分。
- 对 generated clock(分频、倍频、时钟 MUX 之后的派生时钟),一般不需要再单独标 network latency——派生时钟的延迟由主时钟的 latency 加上分频器/MUX 的单元延迟自然推出,再标一层就会重复计数。
再举一个具体数字的例子把整条账算一遍:PLL 到芯片端口 0.8ns(source),树内估计 1.2ns(network),那么 ideal 模式下每个触发器的时钟到达时间就是 2.0ns(相对时钟沿原点)。setup 检查时发射路径用这组数、捕获路径也用这组数,两者相减正好抵消——这就是 ideal 模式看不到 skew 的数学原因。CTS 之后假设某触发器实算 network 为 1.35ns,它的总到达时间就是 0.8 + 1.35 = 2.15ns,与另一个 1.10ns 的触发器之间形成 0.25ns 的真实 skew,这个差值会原样进入时序方程。
三、ideal 与 propagated:CTS 前后的口径切换
CTS 之前,时钟树还不存在,STA 只能拿 set_clock_latency 标的估值去给每个触发器「统一发配」一个到达时间——这叫 ideal clock 模式:所有触发器拿到完全相同的 network latency,skew 为零。这显然不真实,但综合和早期布局阶段只能这样,这也是为什么综合阶段要额外用 set_clock_uncertainty 给 skew 和抖动留余量(见 综合约束工程 的时钟表)。
CTS 之后,真实的 buffer 树、真实走线、真实的 RC 寄生都在网表里了。这时候必须切换成 propagated clock 模式:让工具沿着真实时钟树一级一级把延迟传播算出来,每个触发器的时钟到达时间各不相同,skew、insertion delay 都是算出来的而不是估出来的。切换命令就一行:
set_propagated_clock [all_clocks]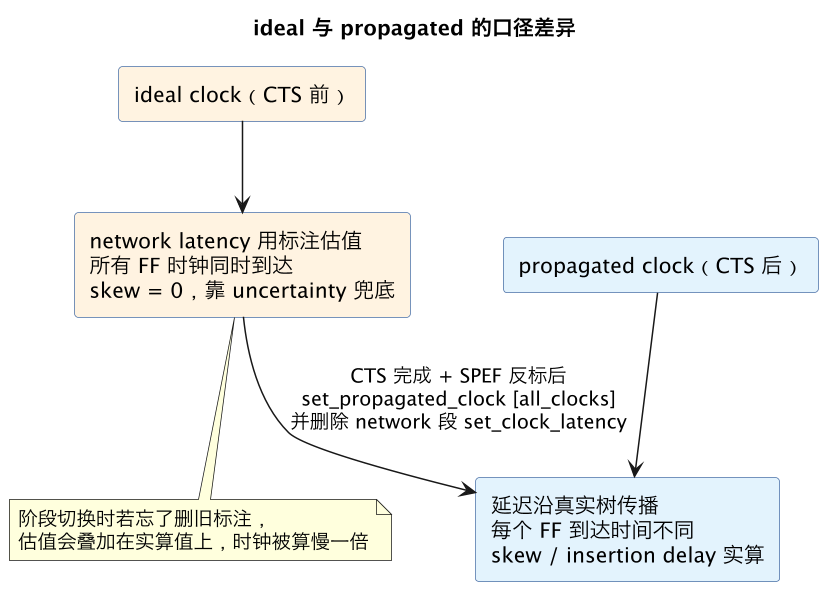
这张图里的黄色卡片是真实事故的高发点:切换模式时旧的 network latency 标注必须清掉(remove_clock_latency 或干脆换一份 CTS 后 SDC)。如果既标了 set_clock_latency 1.2 又开了 propagated,工具会把标注值和传播值叠加,时钟到达时间整体晚 1.2ns——后果是 setup 莫名大面积违例,而 hold 方向相反,查起来非常绕。source latency 则相反:它在两种模式下都保留,因为 PLL 到端口那段工具永远算不到。
四、常见错误与自查
| 症状 | 根因 | 处理 |
|---|---|---|
| CTS 后 setup 全面变差、hold 全面变好(或反之) | latency 标注与 propagated 叠加 | 删掉 network 段标注,只留 -source |
| 不同角之间 skew 报告为精确 0 | 还在 ideal 模式跑 signoff | 检查 SDC 是否有 set_propagated_clock |
| 同一时钟报出多个不一致的 latency | 多条 set_clock_latency 互相覆盖/叠加 | 用 -clock 限定对象,逐条 report_clock_latency 核对 |
| generated clock 的源延迟对不上 | source latency 标到了派生时钟而非主时钟 | source 标注挂主时钟,派生时钟靠传播 |
自查靠一条命令:
report_clock_timing -type latency -clock [get_clocks CLK]
report_clock_timing -type skew    -clock [get_clocks CLK]
多时钟设计还要为每个时钟域分别核对,尤其是同一物理时钟树上挂着多个 create_clock 的场景(比如测试模式时钟与功能时钟共享端口),标注对象写错时钟名会让另一个模式悄悄失去 latency 约束。
它会按触发器逐个列出时钟到达时间:ideal 模式下所有值应该整齐等于你的标注值;propagated 模式下应呈现一棵树状的分布——离根近的触发器 latency 小、叶子端大,且数值量级与 CTS 报告里的 insertion delay 一致。如果 propagated 模式下所有触发器 latency 仍然完全相等,十有八九是 set_propagated_clock 没生效;如果数值比 CTS 报告大约恰好多出你标注的那个数,就是叠加事故。签核阶段这套检查通常固化在 regression 里,与 黄金 STA 与 PrimeTime 的时钟完备性检查(check_timing 的 no_clock/generated_clock 项)一起跑。
这一篇在知识体系里的位置
本篇是 STA 入门链路上的一节:时钟树怎么长出来见 CTS 时钟树综合;latency 标注所在的整份 SDC 怎么写、怎么在综合到后端之间演化见 综合约束工程 与 F4 SDC 生命周期;CTS 之后还要叠加 OCV/多角分析,见 E2 MMMC 与寄生 和 E1 黄金 STA。
总结
时钟 latency 标注的核心纪律是「分段、分角、分阶段」:以 create_clock 定义点为界,源前段用 set_clock_latency -source 永久标注(数据来自 PLL 与封装预算,min/max 分设),源后 network 段在 CTS 前用估值、CTS 后必须删掉估值改用 set_propagated_clock 让工具沿真实树传播;切换时旧标注不清除就会与实算叠加、把整个 signoff 带偏,用 report_clock_timing -type latency 逐个触发器核对是成本最低的自查。