功耗分析是什么:设计侧的「估算」与验证侧的「实测」两条线
更新时间:2026-09-15。本文是「集成电路大类 · 低功耗设计与验证」入门层系统篇第 09 篇,也是本批的收尾。前 8 篇都在讲「怎么把功耗做下去」,这一篇回答另一个问题:我们怎么知道功耗是多少? 不知道就无从优化、无从做预算、也无从签核。「功耗分析」其实有两条目标不同的线——设计侧偏估算、验证/测量侧偏实测。设计侧深篇见《功耗分析与电源完整性》,实测侧见 DPA 动态功耗分析专题,地图见低功耗导读。
本文要回答的问题
- 「功耗分析」到底在分析什么?为什么说它分两条线?
- 设计侧估算是怎么把功耗算出来的?需要哪些输入?
- 验证侧的 DPA 和板级实测又在看什么?和估算差在哪?
- 为什么功耗结果强烈依赖「给什么激励」(向量)?
- 两条线、以及前面学的 UPF 低功耗结构,怎么在项目里配合闭环?
一、一个总问题,两条回答路径
回到动态功耗公式 P = α·C·V²·f(第 01 篇)。要算出功耗,得知道三类量:电压频率(设计给定)、电容(工艺与物理实现决定)、活动率 α(电路在干什么决定)。问题是,在芯片造出来之前,C 和真实的 α 都只能近似;造出来之后能量,却又很难改设计。于是形成两条互补的路径:
| 设计侧:功耗估算 / power analysis | 验证·测量侧:DPA 与板级实测 | |
|---|---|---|
| 核心目标 | 提前知道大概功耗、找热点、指导优化、做预算与签核 | 看清真实跑某场景时随时间变化的功耗曲线、峰值与毛刺 |
| 什么时候做 | 流片前,RTL 早期→门级→带寄生,逐步精确 | 仿真/仿真器上的动态分析,以及硅后板级实测 |
| 主要输入 | 网表/RTL、.lib 功耗模型、活动数据(SAIF/VCD)、寄生 | 真实激励产生的 VCD/SAIF,或探头/电源分析仪采的电流 |
| 输出 | 分模块/分单元的平均功耗表、热点排序 | 逐周期/瞬时功耗波形、平均/峰值电流、异常尖峰 |
| 精度与代价 | 越早越快越粗,越晚越慢越准 | 越接近真实越可信,但拿到时设计已基本冻结 |
一句话区分:设计侧回答「大概会耗多少、电花在谁身上、该优化哪里」,验证侧回答「真实跑起来功耗随时间长什么样、有没有尖峰和异常」。
二、设计侧:用模型 + 活动把每个单元的账加起来
设计侧功耗分析的基本思路是「查表累加」:
- 标准单元库里每个单元(与门、触发器、ICG……)都在
.lib时序/功耗模型里带着功耗数据——内部功耗、漏电功耗,以及不同输入翻转下的能耗(功耗模型本身见后续《功耗模型是什么》篇)。 - 用仿真或统计方法得到每个信号的翻转活动:完整波形用 VCD,更紧凑的翻转统计用 SAIF(二者关系见 DPA 的 VCD 与 SAIF 格式篇)。
- 工具把「单元功耗(查表)× 它实际翻不翻转(活动率 α)」逐单元算出来,再加上所有上电单元的漏电,汇总成模块级、层级级的平均功耗表。
随着设计推进,这笔账分阶段变精确:
- RTL 早期估算:还没有门级网表和真实电容,用综合前的推断模型粗估,数字不精确但改动最自由、最便宜,适合做架构权衡和热点预判(RTL 功耗分析在进阶层展开)。
- 门级分析:综合出门级网表后,用真实
.lib+ 门级翻转算,可信度大幅提高。 - 带寄生的签核分析:布局布线后有了真实连线电容(
.spef之类),功耗和 IR-Drop 算得最准,用于最终签核(见《功耗分析与电源完整性》)。
输出通常是一张「分模块功耗排序表」:哪块占比最高一目了然,热点(hotspot)就是优先优化对象——比如发现时钟和某块数据通路占了大头,就回头加强时钟门控、做操作数隔离。怎么读这张表,后续《功耗报告怎么读》篇专门讲。
三、验证侧:DPA 还原「随时间变化」的功耗,板级实测一锤定音
设计侧那张平均功耗表回答「电花在谁身上」,但平均会掩盖时间维度的信息:同一段逻辑,可能 99% 时间很闲、在某几个周期突然集体翻转,产生一个很窄但很高的功耗尖峰(peak / glitch)。平均值看不到它,可它会造成瞬间 IR-Drop、电压跌落甚至时序出错。这正是验证/测量侧要补的:
- 动态功耗分析 DPA(Dynamic Power Analysis):给设计喂真实激励、跑出门级波形(VCD)或翻转统计(SAIF),逐周期甚至更细地还原功耗随时间的曲线,看平均、峰值、毛刺和特定场景(如唤醒、模式切换、某条指令)的功耗形状。它仍是流片前在仿真/仿真器上做的,但强调「真实动态场景」而非静态平均。本站 DPA 专题用真实案例展开,并配有活动数据库等格式说明。
- 板级硅后实测:芯片回来后,用电流探头、电源分析仪(power analyzer)、精密电阻采样等手段直接测供电电流随时间的变化,得到最可信的真实功耗与睡眠电流 Iq,用来标定/校准前期模型。怎么搭测试、注意带宽与采样率,后续《功耗怎么测》篇讲。
设计侧像「年度财务汇总表」,DPA 像「逐笔交易的时间流水」,板级实测则是「银行真实对账单」。三者粒度和可信度不同,互相印证。
四、为什么功耗强烈依赖「喂什么向量」
功耗分析有个绕不开的特点:结果取决于激励(向量/stimulus)。 因为活动率 α 是「电路在干什么」决定的——
- 让数据通路全跑最坏翻转数据,和让它大部分时间传输不变数据,算出来的动态功耗差很多;
- 只测「全速跑分」会高估日常功耗,只测「空转」又会漏掉峰值;睡眠功耗则要在正确的低功耗场景下测才有意义。
所以工程上会准备一组有代表性的场景向量:典型使用(真实应用 mix)、峰值压力、空闲/睡眠、模式切换等,分别分析。看功耗报告时第一句要问的就是「这是在什么激励、什么工作模式下测的」,否则数字无法比较。这也是为什么早期 RTL 估算常给一个假设活动率、误差较大,而门级用真实 SAIF/VCD 才更可信。
五、两条线怎么和 UPF、低功耗设计闭环
功耗分析不是孤立报告,它和前面学的设计手段、UPF 电源意图一起构成「分析→优化→再分析」的闭环:
- 预算(budget):从续航/散热/电费目标倒推总功耗与各模块上限(后续功耗预算实战篇);
- 早期估算:RTL 粗算热点,决定电源域怎么划、哪些块要可关断/可 DVFS,写进 UPF;
- 优化:按热点加时钟门控、操作数隔离、多电压、电源门控(低功耗手段全景见后续《低功耗手段全景》篇);
- 门级/签核分析:带真实活动与寄生复算,确认达标,并做 IR-Drop、电源完整性检查(见《功耗分析与电源完整性》);
- 动态验证 + 硅后实测:用 DPA 看动态尖峰、用板级实测校准模型、验证睡眠电流,发现偏差再回到设计或修正模型。
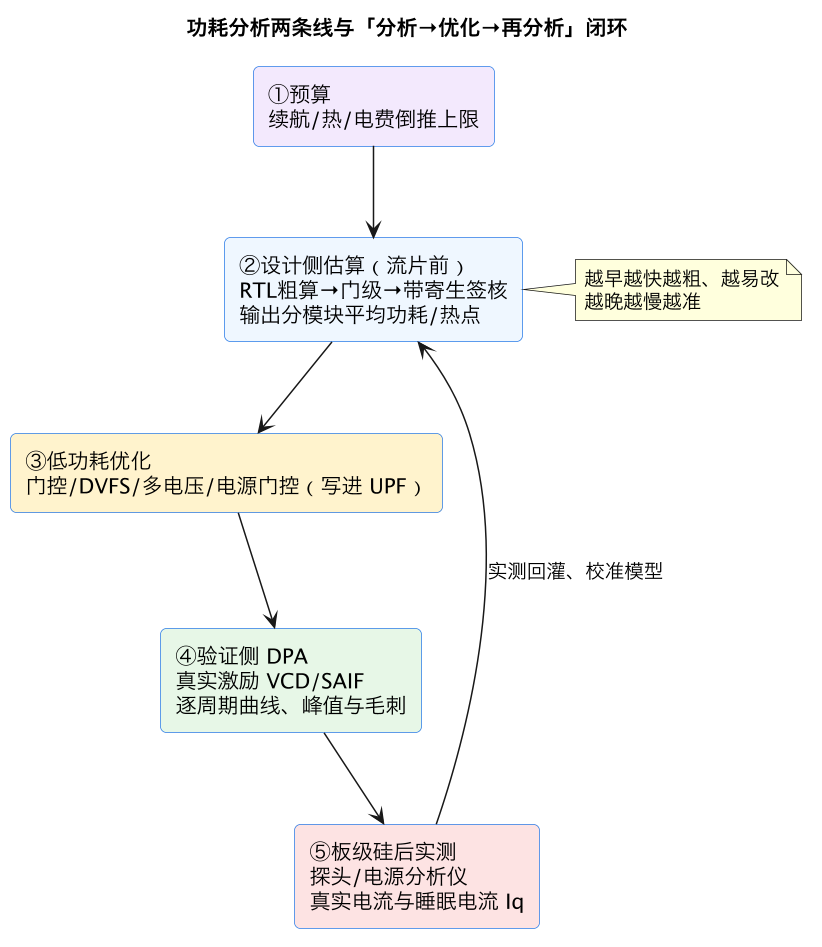
设计侧与验证侧的分工、配合岗位,后续还有《低功耗设计 vs 验证》专门收口。到这一篇,你已经把「功耗从哪来(01–02)→ 为什么省(00)→ 用电压频率/关钟/断电怎么省(03–06)→ 怎么分区与描述(07–08)→ 怎么知道省了多少(09)」这条入门主干走了一遍。
这一篇在知识体系里的位置
- 要算的账从哪来 → 第 01 篇《功耗从哪来》、第 02 篇《动态 vs 静态》;
- 活动数据 VCD/SAIF 长什么样 → DPA《VCD 与 SAIF 格式》、《UPF/.lib/SDF 配套格式》;
- 电源意图如何参与 power-aware 分析 → 第 08 篇《UPF 是什么》;
- 设计侧完整深篇(IR-Drop、电源网络、签核)→ 《功耗分析与电源完整性》;
- 实测动态案例 → DPA 动态功耗分析专题。
总结
一句话总结:「功耗怎么被知道」分两条目标不同的线——设计侧的功耗估算(power analysis)在流片前用标准单元的 .lib 功耗模型结合电路活动逐单元查表累加,按 RTL 早期、门级、带寄生签核三阶段逐步精确,越早越快越粗但越容易改、越晚越慢越准,输出分模块平均功耗排序表来定位热点、指导优化和做预算签核;验证/测量侧则补时间维度,DPA 动态功耗分析用真实激励产生的 VCD/SAIF 逐周期还原功耗曲线,专抓平均值掩盖的瞬时尖峰、唤醒与模式切换毛刺(这些会引发瞬间 IR-Drop),板级再用电流探头/电源分析仪做硅后实测给出最可信的真实电流和睡眠电流 Iq 去校准模型;两者的共同命门是向量依赖——活动率 α 由电路在干什么决定,所以必须用典型使用、峰值压力、空闲睡眠等代表性场景分别分析,看任何功耗数字都要先问激励和工作模式;在项目里它们与 UPF 电源意图、时钟门控/电源门控/DVFS 等手段组成「预算→早期估算定域、写 UPF→优化→门级带寄生复算与 IR-Drop 签核→动态验证与硅后实测再回灌修正」的闭环,至此本系列入门主干「为什么省、功耗从哪来、用电压频率/关钟/断电怎么省、怎么分区与用 UPF 描述、怎么知道省了多少」就完整走通。