AMBA 总线性能面积对比:AXI/AHB/APB/AXI-Stream 同负载吞吐、面积功耗口径与选型矩阵
更新时间:2026-09-25。本文是「集成电路大类 · 芯片设计 · 片上总线」序列的枢纽深文。协议基础分别见 AXI4 完整协议、AHB5 传输协议、APB 时序与从机设计 与 AXI-Stream 帧传输;定性选型先读 AMBA 总线选型,这一篇补上定量口径:同一份负载、同一套统计,数字怎么测、怎么比、怎么据此拍板。
本文要回答的问题
- 四种总线协议形态完全不同,放在一起比性能,「同负载模型」具体怎么搭?
- beat、beat 利用率、有效带宽这些指标各自怎么定义,四协议能不能共用一个公式?
- outstanding 深度对吞吐的收益曲线长什么样,拐点在哪里,代价是什么?
- 面积、功耗、布线复杂度的「实测口径」指什么,拿什么数字对比才公平?
- 硅前仿真统计和硅后性能计数器各能看到什么、盲区在哪?
- 最终选型决策矩阵怎么填,哪些维度是一票否决?
一、为什么必须先统一负载模型再比
「AXI 比 AHB 快」「APB 面积最小」这类说法离开负载就是空话。APB 挂 UART 配置口毫无问题,让它搬一帧 1080P 图像就是灾难;反过来给每个寄存器都接 AXI,单是接口布线和 FIFO 面积就能让 MCU 级芯片的 die size 涨出十几个百分点。协议本身没有快慢,只有「在某种流量结构下的资源占用与完成时间」。
工程上最常见的对比事故有三类:
- 拿理论峰值对打:128 位 AXI @1GHz 标称 16GB/s,但 DDR 往返延迟几十拍、outstanding 不够时实际只跑得出零头;拿这个零头和 AHB 零等待态的局部 SRAM 访问比,结论完全失真。
- 负载不一致:AXI 侧喂连续 INCR 长突发,AHB 侧喂零散 SINGLE 访问,吞吐差距里一大半是流量结构差异而非协议差异。
- 面积口径不一致:比接口面积时一个只数协议壳、另一个把互连仲裁和 FIFO 也算进去,数字没有可比性。
所以本文先立规矩:四协议共用同一个流量发生器、同一组地址/尺寸分布、同一组统计定义,只替换中间的总线 DUT 与对端模型。下图是这个统一平台的结构。

关键点只有一个:除了协议和其配置参数,一切都不许变。对端模型的响应延迟分布(比如统一设成均值 20 拍、带随机反压)也要四协议一致,否则 AXI 的 outstanding 面对的是「快从机」、AHB 面对的是「慢从机」,测出来的不是协议差异而是从机差异。
二、统一口径:beat、beat 利用率与有效带宽
beat(数据拍)是四个协议都能对齐的最小公共单位:总线上一次有效数据搬运。AXI 的一个 W/R 握手拍、AHB 的一个数据相位、APB 的一次完成访问、AXI-Stream 的一个 TVALID&TREADY 拍,都记为一个 beat;每 beat 字节数由 AxSIZE/HSIZE/总线位宽决定,beat 计算细节见 AXI4 LEN/SIZE/beat 计算。
在这个公共单位上定义三个指标:
| 指标 | 定义 | 说明 |
|---|---|---|
| 有效带宽 | 统计窗内有效字节数 / 窗时长 | 唯一跨协议可比的吞吐指标 |
| beat 利用率 | 有效数据拍数 / 统计窗总拍数 | 数据通路被真正用上的时间比例 |
| 传输延迟 | 首拍发出到末拍完成的拍数 | 除吞吐外必须同时记录,取均值与 P99 |
beat 利用率还能继续拆,因为一个统计窗里的非有效拍分属完全不同的桶:

四个桶的含义在四协议里各不相同:AXI 地址通道独立,地址开销与数据拍并行,不计入数据通道利用率;AHB 地址相位与数据相位错拍重叠,稳态无开销但每段突发首尾有填充排空;APB 每次访问固定 Setup+Access 两拍,地址/握手开销结构性地占掉一半;AXI-Stream 没有地址,理论利用率上限是 100%,损失全部来自帧间气泡与反压。这张分解表就是后文所有对比的骨架。
三、四协议的拍级吞吐结构
把同一份负载(连续搬运 4 个 beat 的载荷,零等待态)放到四条总线上,拍级形态差异一目了然。
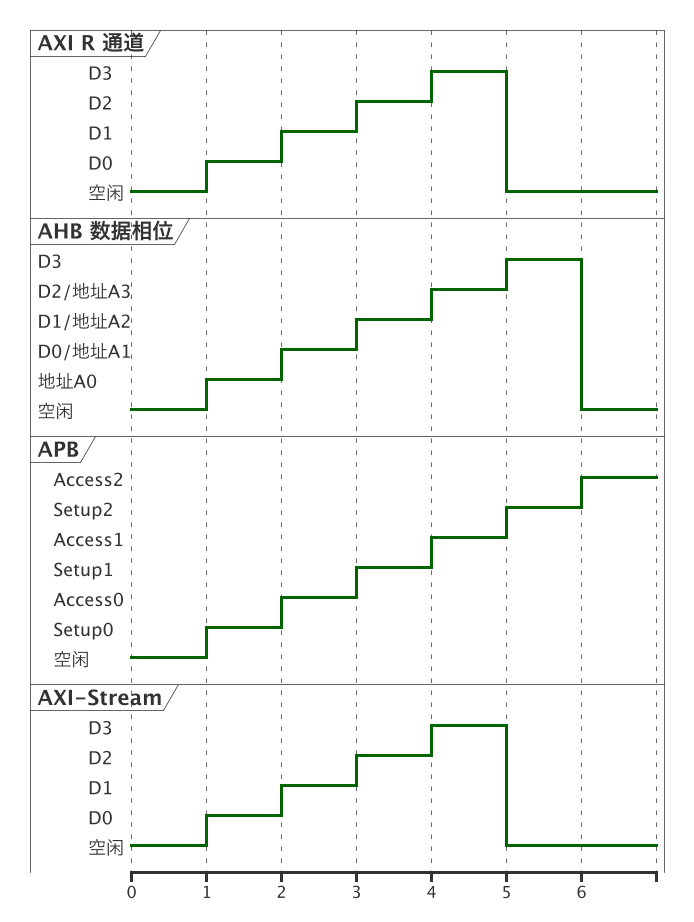
四者在这段窗口里的 beat 利用率量级分明:AXI 与 AXI-Stream 数据通路一拍不停(4/5 拍有效,首尾各一拍窗口开销);AHB 稳态也做到一拍一个 beat,但地址与数据共用一组线、靠错拍重叠,首笔数据要晚一拍出来;APB 两个 beat 要花四拍,利用率结构性封顶在 50%,4 个 beat 至少 8 拍。
更关键的差异藏在零等待这个前提背后。AXI-Stream 与 AXI 是 valid/ready 握手,发送端可以提前把数据摆上总线等授权;AHB 一旦 HREADY 拉低,地址和数据相位整体冻结,整条流水线一起停;APB 在 Access 相位等待时同样保持一切信号。协议机制决定了:面对有延迟的从机,只有能 outstanding 的协议能把等待时间变成别人的传输时间。
四、outstanding 收益:延迟掩盖的拐点
outstanding(未决事务)允许主设备不等响应就连续发多笔事务,让多笔往返延迟重叠,机制细节见 AXI4 outstanding 与 ID 保序。AHB/APB 顺序模型做不到这一点——后一笔的地址相位必须在前一笔数据相位完成的流水线里推进,从机延迟就是实打实的空等。下图对比对端响应延迟 4 拍时,outstanding=1 与 outstanding=4 的拍级行为。
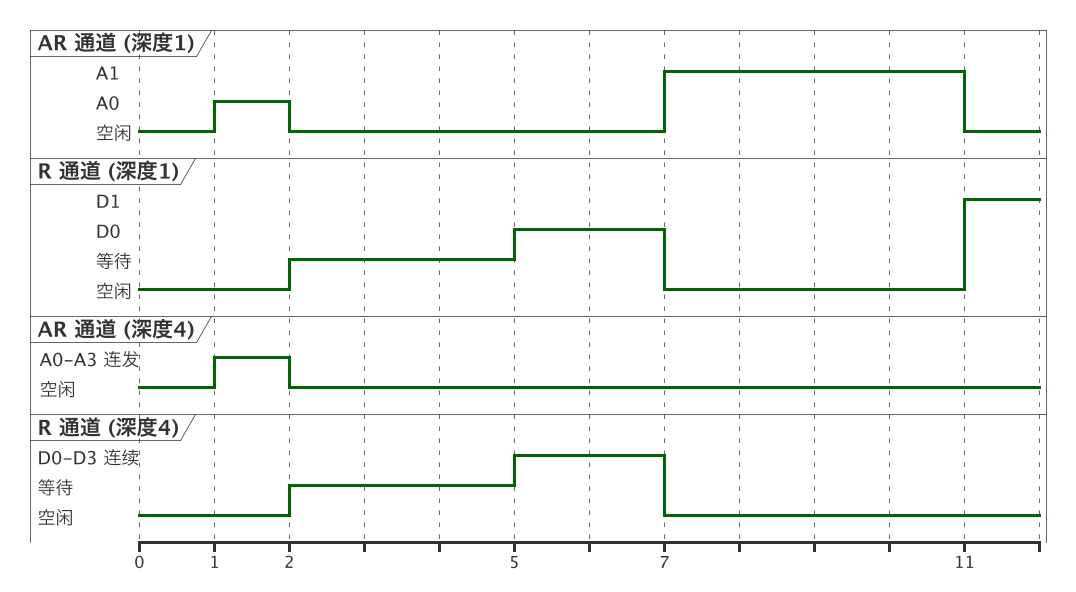
深度 1 时每笔都是「发地址 → 空等 4 拍 → 收一个 beat」,数据通道利用率约 1/(1+4+1)≈17%;深度 4 时四笔延迟重叠,D0 到 D3 连续返回,利用率冲到约 4/6≈67%。经典 Little 定律给出拐点口径:吞吐饱和所需深度 ≈ 单程延迟(拍)× 目标带宽占比,即延迟 20 拍的 DDR 口想跑满,没有 16–32 的 outstanding 深度是做不到的。
但收益不是线性的,且有三重代价,做对比时必须连同负载一起报:
| 代价 | 表现 | 对比口径 |
|---|---|---|
| 缓冲面积 | 每笔在途事务要存地址、ID、控制与返回数据 | 深度翻倍,入口 FIFO/ CAM 面积近似线性增长 |
| 乱序复杂度 | 不同 ID 允许乱序完成,需多队列与 ID 管理 | 验证状态空间爆炸,见 ID 保序 |
| 延迟尾部 | 满载时新请求排深队,P99 延迟恶化 | 高吞吐与单笔低延迟互相打架,需 QoS 仲裁 |
所以对比报告里吞吐必须配延迟分位:只报平均带宽,会把一个「带宽高但偶发几百拍延迟」的配置误判为优。
五、面积、功耗与布线复杂度的实测口径
性能之外的另一半账是物理代价。注意四个协议接口协议壳本身的面积差距其实不大,真正拉开差距的是支撑协议机制所必需的数据通路要素。统一口径是:在同一工艺、同一约束(频率/位宽)下综合,分三个层级报数——协议壳(FSM/译码)、缓冲(FIFO/寄存器切片)、互连(仲裁/MUX/布线)。
典型量级(同工艺同频率同数据位宽下的相对口径,具体数字以实际综合为准,用来建立数量级感觉):
| 维度 | AXI | AHB | APB | AXI-Stream |
|---|---|---|---|---|
| 协议壳面积 | 中 | 中 | 最低 | 最低 |
| 缓冲/FIFO | 多(随 outstanding) | 少 | 无 | 视背压策略 |
| 互连布线 | 五通道全握手,线多 | 单组共享线 | 极少 | 单向点到点 |
| 动态功耗 | 高(多组线翻转+FIFO) | 中 | 低 | 随数据活动 |
| 时钟可达频率 | 高(可插切片收敛) | 中 | 低即可 | 高 |
| 验证复杂度 | 高(乱序/多 ID) | 低(顺序 FIFO) | 极低 | 低~中 |
功耗测量同样要在同一负载下比,否则无意义:动态功耗 = α·C·V²·f,协议差异体现在活动因子 α(五通道意味着更多握手线翻转)和电容 C(长距离宽 MUX 与 FIFO 读写)。报告应同时给综合工具的功耗估算和门级仿真带波形反标的活动功耗,两者口径不同不能混用。布线复杂度还要加一个硅前指标:握手线跨 tile 数量——AXI 一组接口几十根单向线跨越多个布局区块时,congestion 和时序压力远超 AHB/APB,这正是 AXI 寄存器切片 与 AXI 互连数据通路架构 存在的理由,插切片省了时序却加了面积与延迟,三个数字要一起报。
六、测量方法学:硅前仿真统计与硅后性能计数器
数字从哪里来,决定了它可信到什么程度。两条链路各有盲区,成熟做法是互相校准。

硅前仿真能看到一切信号、能分类每一个气泡的成因,且成本只是算力;但它的负载是人造的,benchmark 覆盖不到真实软件的流量结构。仿真统计的标准做法是在 BFM/DUT 边界挂 SVA bind 监视器,逐拍记录四类事件:有效 beat、地址/握手拍、填充排空、反压等待,测试结束直接吐延迟直方图而不只是均值。
硅后性能计数器(PMU/总线 performance monitor)看到的是真实流量,却只能看到事先设计好的事件,且按窗口聚合、丢失逐拍细节。集成时应当为总线预留至少这几类计数器:周期数、有效 beat 数(可按读写分)、反压等待拍数、outstanding 占用均值/满拍数。没有这些计数器,硅后性能问题只能靠猜——这是真实项目反复付出的代价。两条链路的校准方法是:让硅前环境回放硅后抓到的计数器窗口值,若同一份流量两边 beat 计数对不上,先查监视器口径再谈架构结论。
七、选型决策矩阵
把前面的口径压成一张决策表。行是典型场景,列出主导指标与选择,最后一列是必须同时验证的约束。
| 场景 | 主导指标 | 选择 | 必须验证的约束 |
|---|---|---|---|
| CPU/DMA 访问 DDR | 高带宽 + outstanding | AXI(Full) | 深度是否掩盖 DDR 延迟;P99 延迟 |
| 点对点数据流(视频/网络/ADC) | 单向连续吞吐 | AXI-Stream | 背压时帧完整性;位宽适配 |
| Cortex-M 级 MCU 骨干 | 频率/面积折中 | AHB5 / AHB-Lite | 多层矩阵是否够端口;矩阵架构 |
| 大量分散配置寄存器 | 面积/布线最小 | APB | 经单桥挂载;软件轮询延迟可接受 |
| 偶尔忙的控制寄存器 | 低延迟单拍访问 | AXI-Lite | 与骨干同协议省桥;别给它配 FIFO |
| 跨时钟域连接 | 隔离与收敛 | 任协议 + 异步 FIFO | CDC 完整性,别让协议信号裸跨域 |
两条一票否决规则:凡需要 outstanding 掩盖片外延迟的,AHB/APB 直接出局,再省面积也不能选;凡纯配置、每毫秒不到一次访问的,上 AXI 就是纯浪费,多出的 FIFO 和布线换不回任何价值。矩阵不确定的格子,回到第一节的统一平台跑同负载实测——这正是建立这套方法学的最终用途。枢纽全景见 片上总线 AMBA 枢纽页。
这一篇在知识体系里的位置
协议细节:AXI4 完整协议、AHB5 传输协议、APB 时序与从机设计、AXI-Stream 帧传输;机制深挖见 outstanding 与 ID 保序、AXI QoS 服务质量、AXI 寄存器切片;定性选型见 AMBA 总线选型;物理代价的收敛流程见 面积与时序收敛。
总结
AMBA 总线性能面积对比必须先统一负载模型:以 beat 为公共单位,把统计窗拆成有效 beat、地址握手开销、流水填充排空、反压气泡四桶,报有效带宽时必配延迟分位;AXI 靠 outstanding 按 Little 定律拐点(深度≈延迟×带宽占比)掩盖片外往返,代价是 FIFO 面积与乱序复杂度,AHB 稳态一拍一 beat 但无法重叠延迟,APB 利用率结构性封顶 50% 但面积布线最省,AXI-Stream 单向流利用率上限最高;面积功耗要在同工艺同约束下按协议壳/缓冲/互连三层分报,硅前用 SVA 监视器做逐拍统计、硅后靠总线性能计数器看真实流量并互相校准,最终按决策矩阵选型——需要延迟掩盖的不许上 AHB/APB,纯配置口不许浪费 AXI。