派生时钟约束:create_generated_clock 对分频、倍频、相移与门控时钟的建模规则及漏约束风险
更新时间:2026-10-05。派生时钟约束是 SDC 里仅次于 create_clock 的第二高频命令:几乎没有一个真实设计只有根时钟——PLL 输出要分频给低速总线、DDR 控制器内部有相移时钟、功耗敏感模块到处挂门控单元。这些「从某个主时钟长出来」的时钟,都必须用
create_generated_clock显式声明给静态时序分析(STA)工具。写错了,工具算不出正确的时钟树延迟继承关系;漏写了,更糟——工具会把派生点之后的触发器当成「没有时钟」或者干脆按主时钟分析,报出来的违例数偏少,是一种不动声色的假乐观。这一篇把四类派生形态(分频、倍频、相移、门控)各自的建模规则、-source引脚选择的判据、-add多派生叠加的语义,以及漏约束假乐观的成因与排查方法一次讲透。读之前建议先有 SDC 综合约束 的基础,时钟关系的另一根轴(异步与互斥)见 SDC 时钟组约束。
本文要回答的问题
- 分频、倍频、相移、门控四类派生时钟各自用
create_generated_clock的哪些选项建模,语义差别在哪? -source引脚到底该指主时钟的根、还是派生逻辑的输出,选错了会偏多少?- 同一个节点上多个派生时钟为什么要用
-add,不加会发生什么? - 漏写派生时钟约束时,STA 报告为什么「看起来更干净」,假乐观是怎么产生的?
- 怎么验证派生时钟约束写全了——约束 lint 与报告抽查各查什么?
一、为什么派生时钟必须显式声明
STA 工具对时钟的全部认知来自约束文件。你用 create_clock 声明了一个 400MHz 主时钟挂在 PLL 输出端口上,工具知道这个端口每 2.5ns 翻一次、沿的方向如何。但从这个端口往后,设计里有一个二分频寄存器、一个时钟门控单元、一个相移 90 度的 DLL 输出——工具不会自动推断这些节点上的波形。它只知道逻辑连接,不知道时序语义:一个触发器的 Q 端在逻辑上是寄存器输出,在时钟意义上却可能是一个 200MHz 的新时钟域起点。
不显式声明的后果有两档。轻的一档:工具把派生节点之后的触发器全部划到主时钟域,按 400MHz 检查一条实际跑 200MHz 的路径,报出大量假违例——这是「假悲观」,烦人但安全。重的一档:派生路径涉及相位关系或跨域检查时,工具找不到公共周期、算不出相位对齐,索性把部分路径按宽松口径处理甚至不展开分析,违例数反而变少——这是「假乐观」,也是最危险的方向。create_generated_clock 的全部意义,就是把派生节点的波形语义(频率、沿位置、相对主时钟的关系)精确告诉工具,让两档后果都不发生。
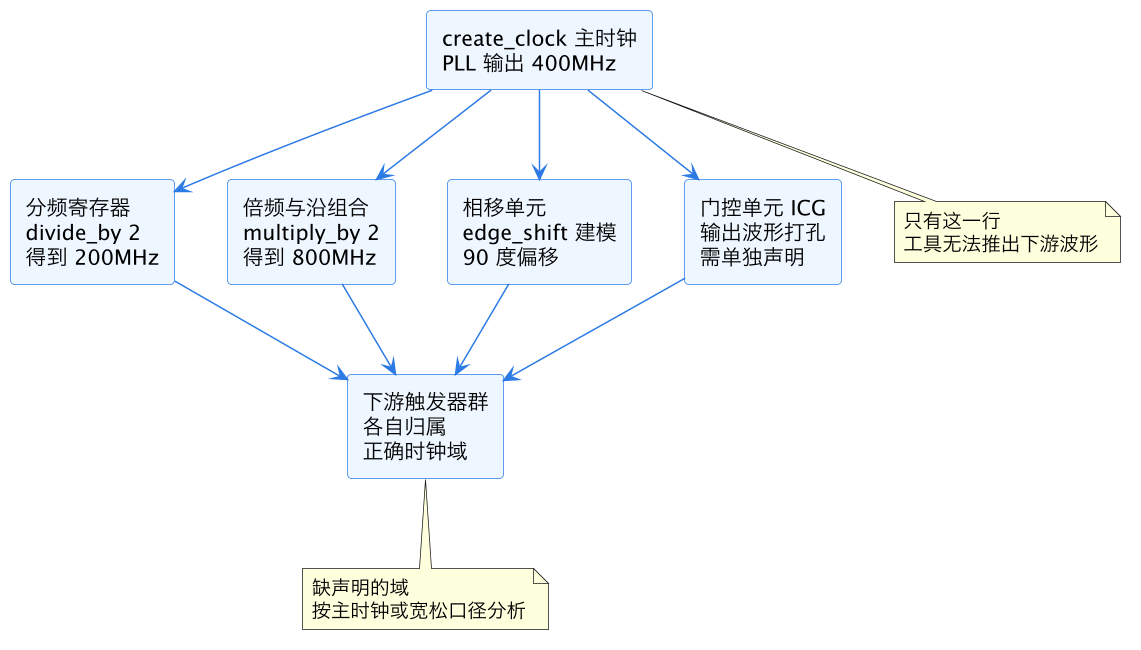
这张图是派生时钟约束的全景:一个主时钟通过四种派生逻辑长出四个新时钟域,每个派生点都需要一条 create_generated_clock。缺任何一条,对应下游触发器群的时钟语义就是错的。下面逐个形态展开。
二、分频与倍频:divide_by 与 multiply_by 的语义
分频是最常见的派生形态。一个寄存器接成 T 触发器(Q 反相接回 D),Q 端输出就是主时钟的二分频。建模写法:
create_generated_clock -name CLK_DIV2 \
  -source [get_pins u_pll/clkout] \
  -divide_by 2 \
[get_pins u_div_reg/Q]三个要素:-name 给新时钟起名(报告里靠它认路);-source 指主时钟的源头引脚;-divide_by 2 声明频率关系;行尾的对象是派生时钟的挂点——新时钟从哪个节点开始生效。工具的后续行为很关键:派生时钟的 latency(时钟树延迟)不再凭空设定,而是从 -source 引脚出发、沿真实时钟路径传播累加。这意味着时钟树综合(CTS)之后,主时钟与派生时钟的插入延迟差、以及由此带来的时钟收敛悲观度减免(CRPR,见 STA CRPR 时钟收敛),都能被工具正确计算——前提是挂点和 source 都指对。
倍频用 -multiply_by。纯组合逻辑做不出倍频,硅片上倍频都来自 PLL 或 DLL 内部的反馈环路。如果 PLL 在 SDC 里被建模为黑盒(只有输入端口的 create_clock),那么它的每个输出端口都要一条 create_generated_clock -multiply_by N -source [输入参考引脚]。注意 -multiply_by 常与 -edges 组合使用:当输出不是简单整数倍、或者占空比不是 50% 时,用 -edges {1 2 5} 这种「主时钟第几个沿对应输出第几个沿」的显式映射更精确——-edges 是「拿主时钟的沿序号拼新波形」的通用机制,-divide_by/-multiply_by 只是它的两个语法糖。
有一个细节经常被忽略:分频寄存器级联时,第二级派生时钟的 -source 应该指第一级派生时钟的挂点引脚(即第一级寄存器的 Q),而不是一路指回 PLL。工具沿 source 链逐级解析波形,指回最根部虽然有时也能算对频率,但会丢失中间级的 latency 继承关系,PBA(基于路径的分析)精度下降。
三、相移时钟:edges 与 edge_shift 的组合
相移场景在源同步接口里遍地都是:DDR 控制器内部用 90 度相移时钟采数据、SerDes 的 CDR(时钟数据恢复)输出与数据居中或沿对齐。相移的建模不能用 -divide_by/-multiply_by(频率没变),要用沿映射加平移:
create_generated_clock -name CLK_SHIFT90 \
  -source [get_pins u_pll/clkout] \
  -edges {1 2 3} \
  -edge_shift {0.625 0.625 0.625} \
[get_pins u_dll/clk90]语义解读:-edges {1 2 3} 表示输出波形的第 1、2、3 个沿分别对应主时钟的第 1、2、3 个沿(频率 1:1);-edge_shift {0.625 0.625 0.625} 给每个沿加 0.625ns 平移——对 2.5ns 周期的时钟,0.625ns 恰好是四分之一周期,即 90 度。三个沿各移相同的量,得到的就是一个同频、纯相移的新时钟。
为什么必须这样精确建模?因为相移时钟与主时钟之间的路径,setup/hold 的检查窗口完全由相位差决定:主时钟域出发、相移域捕获的路径,天然只有四分之一周期的 setup 预算;反方向则有四分之三。这种「相位即预算」的路径,工具只有在两个时钟的沿位置都精确声明后才能算对。漏建模或用 -divide_by 1 糊弄(相位丢了),这类路径的检查全部失真——而且方向不定,可能假悲观也可能假乐观。
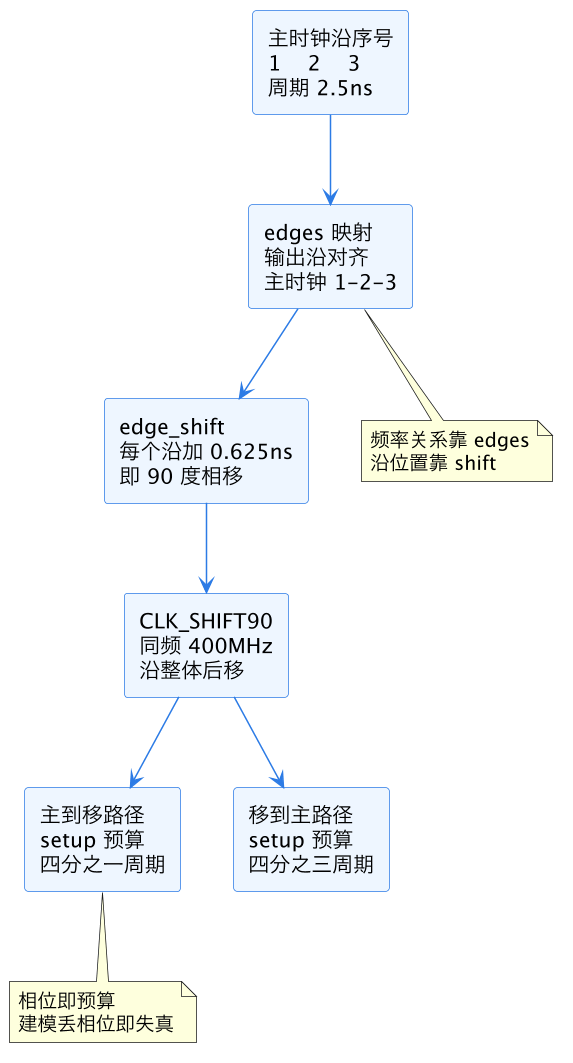
这张图把相移建模拆成两步:-edges 定频率骨架,-edge_shift 定相位偏移。缺了第二步,两个方向路径的预算全部回到整周期口径,源同步接口的时序签核就没有意义了。
四、门控时钟:波形「打孔」与 source pin 选择
时钟门控(clock gating)是低功耗设计的标配:一个 ICG(Integrated Clock Gating,集成门控单元)串在时钟路径上,使能无效时输出被钳住,波形上像被「打了孔」。门控输出的时钟必须单独声明为派生时钟,原因很简单:门控单元的输出是一个新的时钟域起点,下游触发器的时钟树延迟要从这里算,门控检查(setup/hold on enable,见 时钟门控检查 STA)也依赖这个时钟对象的存在。
门控派生时钟的写法里,source pin 选择是全文最容易踩的坑。看两个候选:
# 正确:-source 指 ICG 的时钟输入引脚
create_generated_clock -name GCLK_CORE \
  -source [get_pins u_icg/CK] \
  -divide_by 1 \
  [get_pins u_icg/ECK]

# 错误:-source 一路指回 PLL 根
create_generated_clock -name GCLK_CORE \
  -source [get_pins u_pll/clkout] \
  -divide_by 1 \
[get_pins u_icg/ECK]第一种写法里,-source 指门控单元的时钟输入端(挂点的前一跳),工具从这一点继承主时钟的波形和 latency,只叠加 ICG 自身的延迟——这是精确口径。第二种写法指回 PLL 根,工具会把从 PLL 到 ICG 输入之间的整段时钟路径延迟重复计入或按网络延迟估算,CTS 之后的时钟树延迟继承链断在这里,派生时钟的 latency 与硅片真实值出现固定偏差。这个偏差的量级在先进工艺下可以达到几百皮秒——足够让 hold 检查结果整体翻转。
source pin 选择的通用判据可以浓缩成一句:指派生波形真正被造出来的那个单元的时钟输入引脚,离挂点越近越好。分频器就指分频寄存器的时钟端(实际工程里也常直接指主时钟引脚,因为寄存器 CK 到 Q 的延迟工具自己会算);门控就指 ICG 的 CK 端;DLL 输出就指 DLL 的参考输入端。判断依据永远是「波形语义从哪个节点开始改变」。
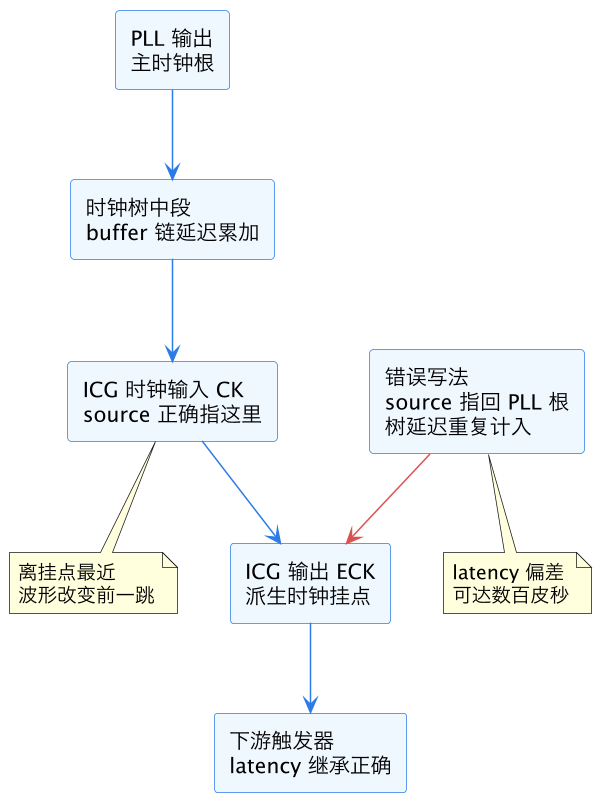
这张图对照了 source pin 的两种指法。盯住红色那一支:指回根部的写法不是「多保守一点」,而是引入了一个方向不定的系统性偏差——对 setup 是悲观、对 hold 就是乐观,而 hold 乐观是最要命的(hold 违例在硅片上是硬伤,修不了)。
五、-add 与多派生叠加:一个节点多个时钟身份
同一个节点上可以存在多个时钟。典型场景:时钟 MUX 的输出端,FUNC_CLK 和 TEST_CLK 都可能从这里经过;或者一个可配置分频器,不同模式下输出不同频率。默认行为是「后写覆盖先写」——在同一个挂点上连续写两条 create_generated_clock,第二条会把第一条顶掉。要保留多个,必须加 -add:
create_generated_clock -name FUNC_GCLK -source ... -divide_by 1 [get_pins u_mux/Z]
create_generated_clock -name TEST_GCLK -source ... -divide_by 4 \
  -add [get_pins u_mux/Z]
加了 -add 之后,挂点上同时挂着两个时钟对象,STA 会按「每个时钟各算一遍」的方式展开分析:下游每条路径被 FUNC_GCLK 检查一遍、再被 TEST_GCLK 检查一遍,两个时钟之间的跨时钟路径也会生成(通常配合 set_clock_groups -logically_exclusive 把它们互斥掉,语义见 SDC 时钟组约束)。
忘记加 -add 的翻车是沉默的:约束文件读起来两行都在,lint 不一定报错,但先写的那个时钟已经不存在了。测试模式下整片逻辑的时序检查凭空消失,而功能模式报告一切正常——约束评审时很容易漏看。防御手段是 report_clocks 全量列出时钟对象,逐个挂点对账:凡是 MUX 输出、可配置分频器输出这类「多身份」节点,时钟数必须大于等于身份数。
| 场景 | 关键选项 | source pin 指向 | 常见错误 |
|---|---|---|---|
| 寄存器二分频 | -divide_by 2 | 主时钟引脚或上级挂点 | 级联分频指回最根部 |
| PLL 倍频 | -multiply_by N 或 -edges | PLL 参考输入引脚 | 占空比非 50% 仍用 multiply_by |
| 相移 90 度 | -edges 加 -edge_shift | DLL 参考输入引脚 | 用 divide_by 1 丢相位 |
| 门控时钟 | -divide_by 1 | ICG 的 CK 输入引脚 | 指回时钟根重复计延迟 |
| 多身份节点 | 第二条起加 -add | 各路各自的源 | 忘加 -add 后者覆盖前者 |
六、漏约束的假乐观:成因与排查
现在把全文最重要的问题收拢:漏写 create_generated_clock 为什么产生假乐观,而不是简单报错?机制有三层。
第一层,未声明时钟的触发器按工具的「unconstrained」策略处理。多数 STA 工具默认对没有时钟的寄存器不做检查时发出 warning 而不是 error——warning 埋在几十万行日志里,签核压力一大就被 waive 掉。这些路径从报告里消失,违例数自然「干净」。
第二层,派生点被误当主时钟的一部分。如果派生寄存器的 Q 端没有派生时钟声明,部分工具会沿时钟网络把主时钟「穿透」到 Q 之后的逻辑(取决于 propagated clock 的解析策略),按 400MHz 检查 200MHz 的路径——这方向是假悲观。但当派生关系涉及相位或分频沿对齐时,工具找不到合法的沿组合,会退化为宽松口径(比如只查数据存在性不查沿对齐),违例数再次变少。
第三层,跨时钟路径的消失。主时钟域到派生域的路径,在派生时钟缺失时按同一时钟分析,工具套用单时钟的零相位检查口径——跨域路径的 setup 窗口被算成整周期,实际是半周期或四分之一周期的路径全部「达标」。这是最纯粹的假乐观:报告里每条路径都是 PASS,硅片上每条都在违例边缘。
排查手段两道。其一,约束 lint(见 SDC 约束验证与 lint):lint 工具会扫描所有时钟网络上的寄存器,凡是时钟引脚无法归属到任何时钟对象的、凡是时钟路径上存在「时钟经过寄存器数据逻辑再生」形态(分频器特征)却没有派生时钟声明的,都会列出来。其二,报告抽查三连:report_clocks -attributes 核对时钟清单与设计图纸逐一对账;check_timing 报告里的 unconstrained endpoints 必须为零或全部有 waive 理由;report_clock_timing -type summary 看每个时钟的 latency 分布,派生时钟的 latency 应该略大于其 source 主时钟(多了一段派生逻辑延迟),如果某个派生时钟 latency 与主时钟完全一样,多半 source pin 指错了位置。
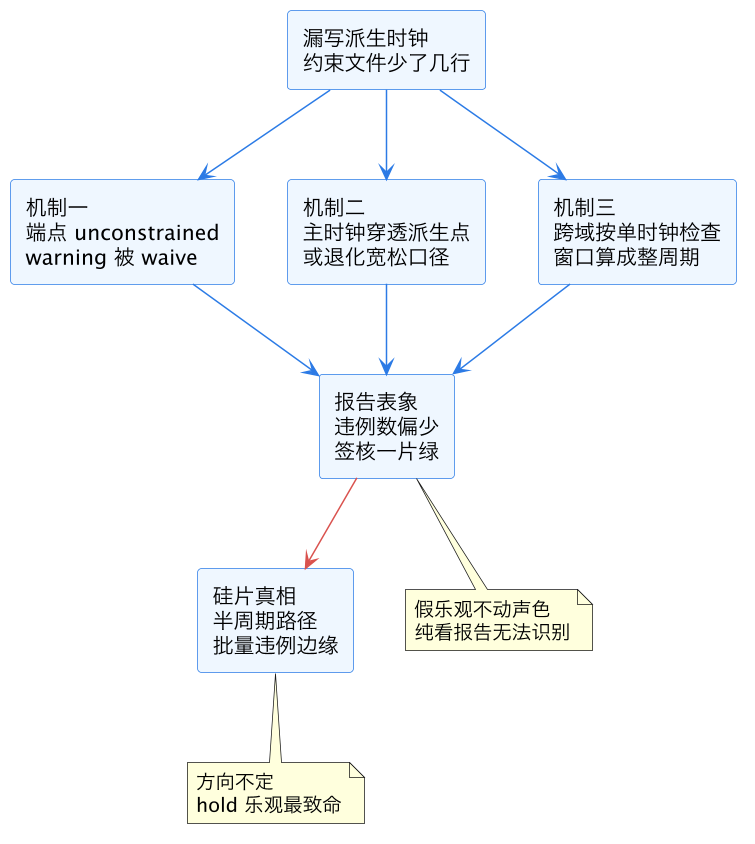
这张图是假乐观的三层成因汇流。核心教训和时钟组那篇一脉相承:时序报告的「干净」从来不是约束正确的证据,只有 lint 的拓扑核对加报告抽查的对账,才能让「缺几行约束」这种沉默错误现形。
七、工程落地:写法纪律与流程集成
几条反复验证过的纪律。第一,派生时钟声明紧跟主时钟写、按派生链顺序排(PLL 输出 → 一级分频 → 二级分频),source 链断在中间时一眼能看出。第二,命名带频率或比例信息(CLK_DIV2_200M),报告里排查时不用回查波形。第三,MMMC(多模式多角)场景下,功能模式和测试模式的派生结构往往不同,派生时钟约束按模式分文件维护(框架见 corners 与 MMMC 配置),切忌一个文件打所有模式。第四,层次化设计里 block 级声明的派生时钟要与 top 级时钟定义对账(接口时钟的衔接见 层次化 STA 与块接口),block 内部声明的 source pin 引用的是 block 端口,集成到 top 后要确认该端口挂的确实是预期的主时钟。第五,任何改动派生时钟约束的 commit,回归时不止看违例数——违例数变少恰恰是危险信号,要同时 diff report_clocks 的时钟清单和 check_timing 的 unconstrained 统计,确认变化方向符合预期。
这一篇在知识体系里的位置
本篇是 eda/ 目录约束线里专讲派生时钟建模的一篇,与 SDC 时钟组约束 构成「时钟约束的两根轴」:本篇管单个时钟怎么从主时钟正确长出来,时钟组管长出来的时钟之间是什么关系。上游接 SDC 综合约束 的基础语法与 时钟 uncertainty 与抖动 的时钟建模总论,同层与 时钟延迟 source 与 network、STA CRPR 时钟收敛(都依赖派生时钟的正确 latency 继承)并列,下游落地到 时钟门控检查 STA 的门控专项检查、Signoff STA 与 PrimeTime 的报告解读,以及 SDC 约束验证与 lint 的自动化核对。掌握了 create_generated_clock,SDC 里 80% 的时钟建模问题都有了抓手。
总结
派生时钟约束的核心是 create_generated_clock 把分频、倍频、相移、门控四类派生形态的波形语义精确交给 STA:分频倍频用 -divide_by/-multiply_by(本质是 -edges 沿映射的语法糖),相移必须 -edges 配 -edge_shift 保相位(相位即预算),门控时钟的 -source 要指 ICG 时钟输入引脚而非时钟根(指错会重复计入时钟树延迟、先进工艺下偏差可达数百皮秒),多身份节点从第二条声明起必须加 -add 否则后写覆盖先写。漏写派生时钟产生的是假乐观而非报错——端点 unconstrained 淹没在 warning 里、跨域路径按单时钟宽松口径放行,报告一片绿而硅片上批量违例;防御靠约束 lint 的拓扑扫描加 report_clocks 清单对账、check_timing 端点统计、report_clock_timing 延迟分布三连抽查,回归时违例数变少永远要当作危险信号而不是好消息。