UVM 流水 driver 乱序响应:outstanding 请求-响应匹配表、时序回填与协议约束的实现模式
更新时间:2026-10-05。站内的 UVM driver 与 sequence item 流转 讲的是 driver 和 sequencer 之间
get_next_item/item_done的基础握手,那一套语义建立在「一个事务处理完再取下一个」的隐含前提上——对 UART、SPI 这类严格串行的接口够用,但对 AXI、CHI、PCIe 这类支持多笔在途(outstanding)和乱序完成(out-of-order response)的高性能总线,这个前提本身就是错的。真实的 AXI4 master 可以同时挂着十几笔读请求,数据按 ID 分组乱序回来;driver 如果还按「发一笔、等响应、再发一笔」的节奏驱动,等于把 DUT 的流水能力阉割成了单步机,性能验证、乱序路径、ID 交织这些场景全部打不到。这一篇讲 UVM 流水 driver 的乱序响应实现:怎么让 driver 持续发请求不阻塞、怎么用请求-响应匹配表管理在途事务、响应回来时怎么按时序回填给 sequence,以及协议的 outstanding 上限和乱序规则怎么在 driver 里显性建模。
本文要回答的问题
- 为什么经典的
get_next_item→ 驱动 →item_done单循环无法支持 outstanding 和乱序响应? - 支持多笔在途的 driver 内部应该拆成几个进程,fork-join 结构怎么搭才不会泄漏?
- 请求-响应匹配表用什么数据结构,匹配键(transaction ID)从哪里来、谁负责分配?
- 乱序响应回来后,driver 怎么把响应「按时序」回填给对应的 sequence,rsp_port 和 put_response 怎么选?
- 协议层的约束(outstanding 上限、同 ID 保序、写响应不可超前)在 driver 里怎么建模,和 scoreboard 的职责边界在哪?
一、单循环 driver 的天花板:流水被 item_done 卡死
先看清经典 driver 主循环到底哪里不支持流水。教科书写法是:forever begin seq_item_port.get_next_item(req); drive_transfer(req); seq_item_port.item_done(); end。这个循环的问题不在 API 而在时序语义——item_done() 在 drive_transfer 返回之后才调用,而 drive_transfer 的返回点通常定义为「这个事务在总线上走完了」。对一笔 AXI 读事务来说,「走完」意味着 R 通道最后一拍握手完成。于是 loop 的周期等于一笔事务的完整延迟,下一笔请求的 AW/AR 握手被推迟到上一笔响应结束之后——总线上永远只有一笔事务在飞,outstanding 数恒等于 1。
乱序响应就更无从谈起了。单循环结构里 driver 在同一时刻只「记得」一笔事务,如果 DUT 按乱序返回响应(比如 ID=2 的数据先于 ID=1 回来),driver 根本没有结构去接收和路由它——要么把乱序响应张冠李戴塞进当前事务,要么干脆采不到。这就是为什么「能跑通功能测试」的 driver 到了性能验证和一致性验证阶段必须重写,而不是打补丁。
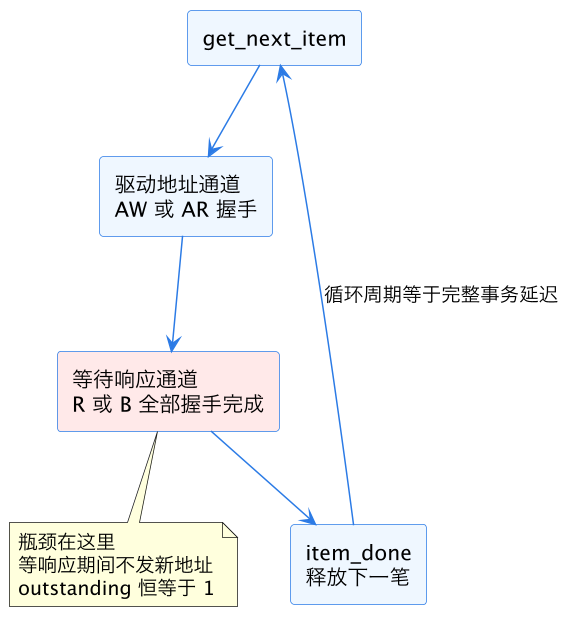
上图把单循环的时序瓶颈标了出来:红色节点「等待响应通道」是流水的断点,循环边「done → get」意味着新请求的发出被旧请求的响应完成所阻塞。要支持 outstanding,改造的方向很明确——把「发请求」和「收响应」拆成两个并发进程,让它们各跑各的节奏,中间用一张匹配表关联。这就是下一节的骨架。
二、三进程骨架:发令、收令、匹配表
支持 outstanding 与乱序响应的 driver,工业界的标准形态是三个并发进程加一个共享的匹配表(transaction tracking table)。三个进程是:地址驱动进程(从 sequencer 取 item、驱动 AW/AR/W 通道)、响应采样进程(盯 R/B 通道、按 ID 接收乱序响应)、响应回填进程(把收齐的响应路由回对应的 sequence)。匹配表是三者之间的共享状态,记录了每笔在途事务的句柄、发出的拍数、已回收的数据拍数。
发令进程的节奏由协议 outstanding 上限控制,而不是由响应控制:只要匹配表里的在途数没超上限、总线地址通道可握手,就 get_next_item 取新 item、登记进匹配表、立刻 item_done(rsp)(注意这里可以提前 item_done,把响应的交付责任转交给回填路径——后文细说),然后驱动地址握手。收令进程完全独立于 sequencer,它只盯接口信号:R 通道每拍握手成功,就按 RID 去匹配表查这笔事务,把数据拍追加进该事务的响应缓冲区;RLAST 到来时标记该事务响应收齐。回填进程则负责把「收齐」这个事件翻译成 sequence 能拿到的响应对象。
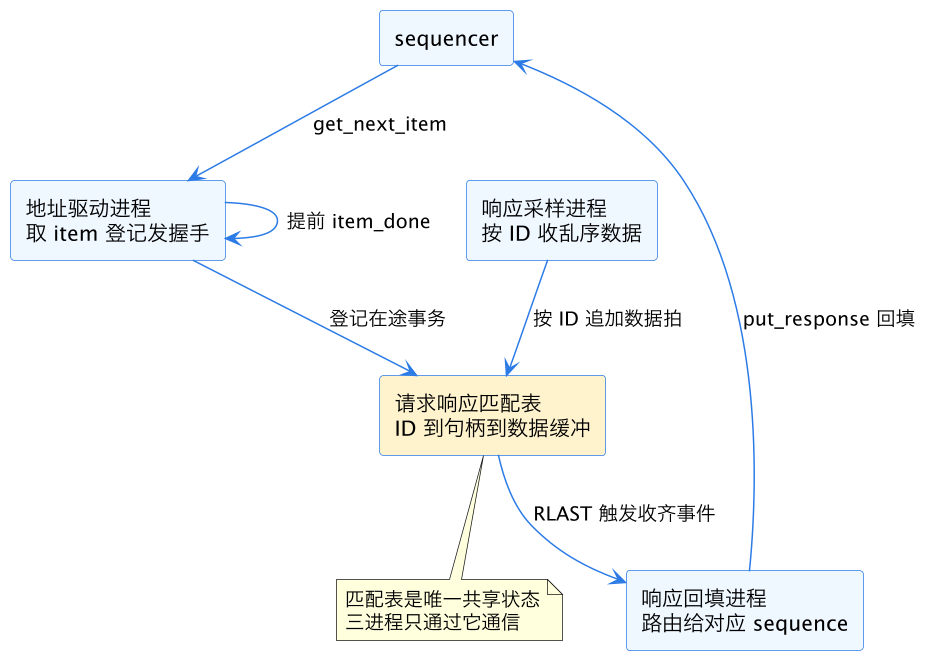
上图是三进程骨架的数据流:sequencer 只和地址驱动进程打交道,响应通路完全绕过它,所有交叉都收敛到黄色的匹配表。这个结构有一个关键的纪律——三个进程之间不直接发消息,只通过匹配表交换状态,否则 fork...join_none 的进程间乱发 mailbox,调试时根本追不清时序。进程管理上用 fork...join_none 拉起后,句柄要保存好,在 phase_ready_to_end 或 reset 处理里能干净地 kill 掉;复位时尤其要清表,否则上一段仿真残留的在途事务会污染匹配。
三、请求-响应匹配表:ID 是键,分配权在 driver
匹配表的数据结构选择直接决定乱序支持的能力边界。最常见的两种:协议支持乱序的(AXI4 按 ID 分组乱序),用以 transaction ID 为键的关联数组套队列——req_queue_t table[axi_id_t],每个 ID 下一个 FIFO 存该 ID 的在途事务;协议完全不保序的(比如某些 NoC),才退化成句柄级全关联数组。AXI 场景下「ID 套队列」这个结构不是随意选的,它恰好编码了协议的核心规则:同 ID 事务保序完成,不同 ID 之间允许乱序。匹配逻辑因此很简单——RID 来了查表,取该 ID 队首事务追加数据;队首事务 RLAST 则出队。如果回来时该 ID 队列为空,说明 DUT 返回了一个从未发出的 ID,这是协议错误,driver 应该立刻报 uvm_error 而不是默默丢弃。
ID 从哪来、谁分配,是第二个关键决策。两种做法:sequence 侧在 randomize 时指定 ID(适合定向场景和 ID 交织覆盖率),或者 driver 在登记时自动分配(适合随机压力场景,保证 ID 池被充分利用)。工程上推荐混合策略:item 里 ID 字段默认值为一个非法哨兵(比如 '1),sequence 没指定时 driver 从可复用 ID 池里轮转分配,指定了就尊重 sequence 的选择。这个约定要写进 item 的注释里,否则多人协作时 ID 分配权混乱,查「同 ID 保序违例」根本定位不到责任方。
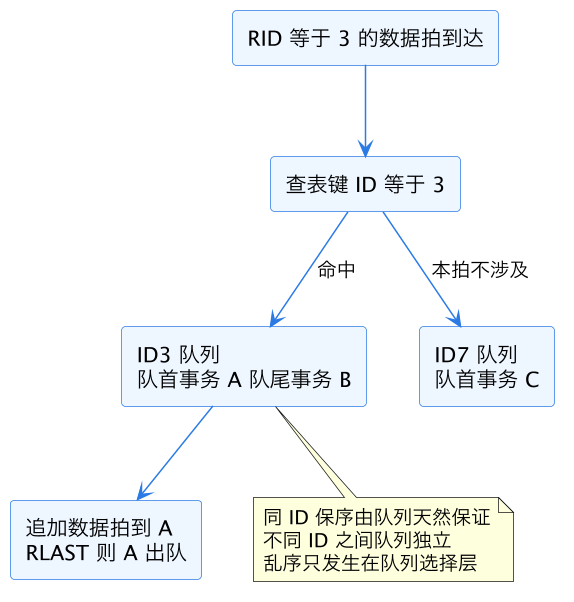
上图画的是一拍乱序数据到达时匹配表的工作方式:以 RID 为键选中对应 ID 的队列,数据拍追加到队首事务。注意这张图也解释了为什么「同 ID 保序」不需要额外逻辑——队列的 FIFO 序就是协议要求的完成序,乱序自由度全部收敛在「选哪个队列」这一层,数据结构本身即协议约束。匹配表的容量上限也顺便承担了 outstanding 限流:地址驱动进程在登记前检查表内总在途数,达到配置上限就反压(不调用 get_next_item),sequencer 自然被阻塞——这比在 sequence 里数 outstanding 优雅得多,限流逻辑只存在于 driver 一处。
四、响应回填:提前 item_done 与 put_response 的分工
乱序响应场景下,「driver 怎么把响应还给 sequence」是最多人踩坑的地方。UVM 提供了两条回填路径,语义差别很大。第一条,seq_item_port.item_done(rsp):响应对象随 item_done 交给 sequencer,sequence 里 get_response(rsp) 按 FIFO 顺序取。第二条,独立的 uvm_analysis_port #(rsp_t) rsp_port:driver 把响应广播出去,scoreboard 或覆盖收集器直接订阅,sequence 不参与响应消费。
乱序场景的正确搭配是「提前 item_done 加 put_response」组合:地址握手完成的瞬间调用 item_done()(不带参),把 sequencer 释放出来发下一笔;响应真正收齐后(可能乱序、可能隔几百拍),driver 通过 seq_item_port.put_response(rsp) 或者 item 内的 response 队列把响应塞回 sequencer,sequence 侧用 get_response(rsp, transaction_id) 按事务 ID 精确取回自己的响应。这里有一个必须搞懂的机制:sequencer 内部的响应队列是按 sequence 的 transaction_id 路由的,put_response 时 UVM 会根据响应对象里的 sequence_id/transaction_id 字段把它放进正确的 sequence 的响应 FIFO——所以 driver 在回填前必须把原请求的这两个字段拷贝进响应对象,漏拷贝的后果是所有响应都堆在默认队列里,多 sequence 并发时互相抢错响应,而且报错信息完全指向别处。
| 回填方式 | 时序语义 | 乱序支持 | 适用场景 |
|---|---|---|---|
item_done(rsp) 即时返回 | 响应必须已收齐,阻塞流水 | 不支持 | 严格串行接口 |
提前 item_done() 加 put_response | 发令与响应解耦,响应按 ID 路由 | 完整支持 | AXI/CHI 等乱序总线 |
rsp_port 广播 | 响应只给 scoreboard,sequence 不消费 | 完整支持 | 只关心比对不关心回填的环境 |
| 事件加 wait_trigger 手动同步 | sequence 自己阻塞等事件 | 支持但脆弱 | 定向调试,不建议进回归 |
对只需要 scoreboard 比对的环境,第三条路(rsp_port 广播)更干净——sequence 根本不关心响应内容时,让响应走 analysis port 直连 scoreboard,省掉 sequencer 响应队列这一跳,也避免了 sequence 忘记调 get_response 导致响应 FIFO 溢出(UVM 默认队列深度 8,溢出只给 warning 很容易被日志淹没,是个经典暗坑)。选择标准就一条:sequence 的后续激励是否依赖这笔响应的内容。依赖(比如读回数据决定下一次写地址),走 put_response;不依赖,走 rsp_port。
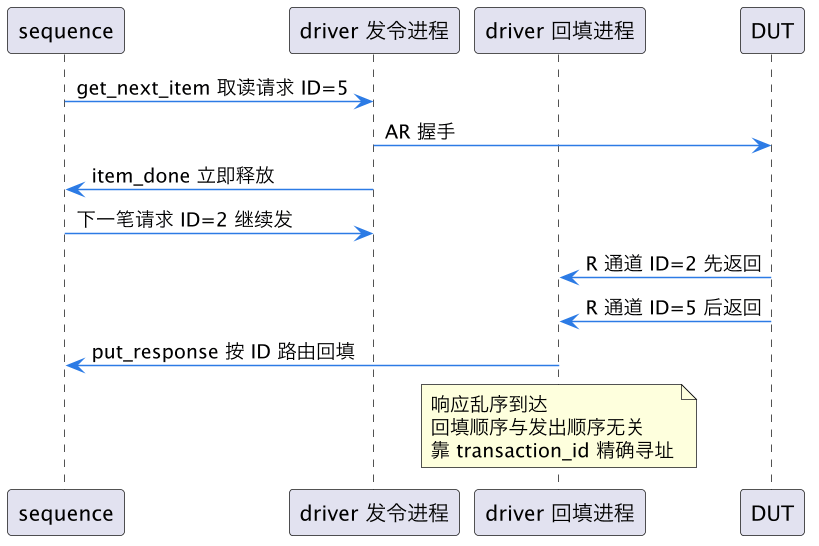
这张时序图展示了完整的乱序回填闭环:sequence 连发两笔请求,DUT 乱序返回(ID=2 先于 ID=5),回填进程按 transaction_id 把每个响应精确投递给发出它的 sequence 实例。注意 item_done 的调用点在 AR 握手完成的瞬间——这是整个流水的「解锁键」,比经典单循环提前了整整一个事务延迟。
五、协议约束建模与 scoreboard 的职责边界
driver 建到这一步已经能跑乱序了,但还差一层:协议约束的显性建模。高性能总线的乱序不是无规则的乱,AXI4 的约束至少包括:outstanding 上限由 DUT 的接收能力决定(ARREADY/AWREADY 反压体现);同 ID 事务必须保序完成;写响应 B 通道必须在该写的全部 W 数据和 AW 都被接收后才合法;不同 ID 的读数据可以任意交织到拍级(AXI3 允许 interleave,AXI4 取消了 R 通道交织但仍允许乱序)。这些约束哪些归 driver 管、哪些归 scoreboard 和断言管,职责划分要一刀切清楚,否则环境会在两处同时查同一个错、又在缝隙里漏掉另一个错。
分工原则:driver 管「发出侧合法性」,scoreboard 和 SVA 管「返回侧合法性」。具体来说,driver 负责:不超 outstanding 上限发请求(匹配表限流,第三节讲过)、同 ID 的依赖事务按序发出(如果 sequence 要求 ID 复用)、W 通道数据与 AW 的配对节奏符合配置。DUT 返回侧的一切——响应是否对应真实发出的请求、同 ID 是否保序、B 响应是否超前于 W 数据——driver 只做最轻量的完整性检查(比如「ID 查表未命中」这种结构性错误),语义级比对全部交给 scoreboard 的乱序匹配逻辑(站内 scoreboard 乱序匹配 讲的就是这一侧的实现)和接口上的 SVA 断言(参考 SVA AXI4 读通道检查 的写法)。driver 里不做语义比对的道理很简单:driver 是激励方,它越「宽容」,越能驱动出 DUT 的真实行为让 scoreboard 去判;driver 里塞一堆 fatal 断言,等于把激励器和裁判混成一个组件,重用性(尤其是 passive 复用为 monitor 时)直接报废。
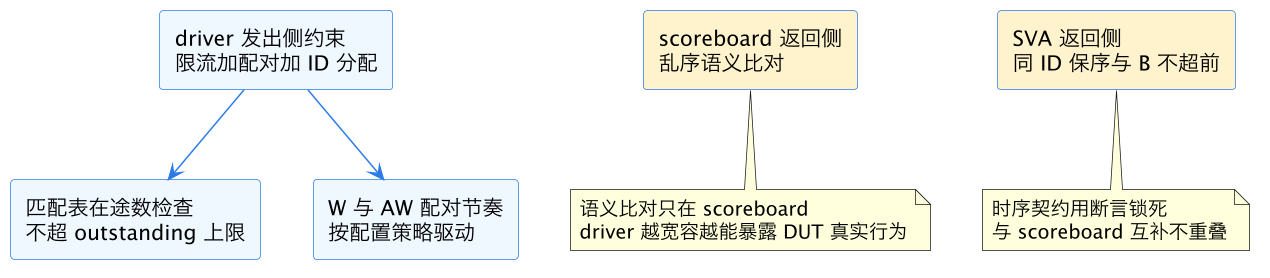
上图把约束的检查责任画成了两个阵营:左侧蓝色是 driver 的发出侧约束,右侧黄色是返回侧的 scoreboard 与 SVA。落地的检查清单建议这样收尾:driver 配置对象里暴露 max_outstanding、id_pool、w_data_timing_mode 三个旋钮,用 UVM 环境 CSV 旋钮 的思路做成回归可扫的参数;每条乱序用例跑完,从匹配表 dump 一份「峰值在途数、ID 分布、平均响应延迟」统计进报告,这组数字是证明「流水真的被压满了」的直接证据——没有这组统计,你永远不知道回归里的 driver 到底跑出了 outstanding 等于 16 还是又退化回了 1。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录下 UVM 组件实现线的一篇 S 层深文,主关键词 UVM 流水 driver。向下衔接 UVM driver 与 sequence item 流转——那一篇讲清 get_next_item/item_done 的基础握手,本篇把它扩展到多笔在途与乱序回填;sequence 侧的并发组织见 UVM sequence 与 sequencer 仲裁。横向的伙伴是三篇: scoreboard 乱序匹配(响应回来后语义比对怎么按 ID 配对,与本篇的匹配表互为镜像)、SVA AXI4 读通道检查(乱序约束的断言化)、AMBA AXI UVM 环境(本篇的 driver 放进完整 AXI 环境里的装配方式)。向上,掌握乱序 driver 之后,UVM reactive agent 响应器 是它的对偶问题——本篇是「主动发令收乱序响应」,那一篇是「被动收令发乱序响应」,两篇合起来覆盖总线两侧的全部乱序建模。
总结
UVM 流水 driver 支持 outstanding 与乱序响应的核心改造是把「发请求」和「收响应」从单循环拆成三个并发进程:地址驱动进程在握手完成即提前 item_done 释放 sequencer,响应采样进程按 ID 把乱序数据追加进请求-响应匹配表(ID 套队列的关联数组,同 ID 保序由 FIFO 天然保证),响应收齐后经 put_response 按 transaction_id 精确回填给 sequence(或走 rsp_port 直连 scoreboard);匹配表容量兼作 outstanding 限流阀,协议约束按「driver 管发出侧、scoreboard 和 SVA 管返回侧」划清边界,最后务必 dump 峰值在途数证明流水真的被压满——乱序 driver 写对了,DUT 的并行能力才被真正验证,而不是被测试台悄悄降速成单步机。