时序收敛迭代方法学:从综合到 PR 到 ECO 的完整收敛版图、节奏与判据
更新时间:2026-10-05。几乎每个后端工程师都经历过这种时刻:昨晚 signoff STA 报告显示全 corner 干净,今早一个功能 ECO 下去,时序又炸出三百条违例——「时序关了又开」不是项目失控的信号,而是时序收敛(timing closure)这门手艺的常态。单点修复技巧本站已经讲透:setup 违例的换 VT 与 sizing 见 STA setup 修复之换 VT 与 sizing,hold 违例的插 buffer 见 STA hold 修复之 buffer 插入,批量修复的脚本化见 batch ECO 脚本化流程。这一篇是枢纽深文:不教任何单一修招,而是把「从综合到 PR 到 signoff 到 ECO」的整条迭代版图铺平,讲清每个阶段迭代什么、收敛曲线怎么读、瓶颈怎么分层、什么判据下可以说「这一轮真的关了」。
本文要回答的问题
- 时序收敛为什么必然是多轮迭代,而不是「跑一次 STA 修一次」的一次性动作?
- 综合、布局、CTS、布线、signoff 各阶段迭代的对象和精度有什么本质区别?
- WNS/TNS 收敛曲线怎么读,什么样的曲线形状预示「收敛不了」?
- 「关了又开」的根因分哪几类,如何用冻结纪律把重开次数压到可接受范围?
- 时序收敛的完成判据是什么——零违例就够了吗?
一、总览:时序收敛是一张多阶段迭代版图
先把全局图景立起来。时序收敛不是某个阶段末尾的一道检查,而是一条贯穿综合、布局、时钟树综合(CTS,Clock Tree Synthesis)、布线、signoff 的迭代链。每个阶段都在做同一件事:在当前精度可得的时序视图下,把违例压到「可以移交下一阶段」的水位。精度随阶段递进——综合阶段连布局信息都没有,用的是线负载模型(wire load model)估延迟;布线之后才有真实寄生;signoff 阶段才用 foundry 签核级 STA 引擎(Signoff STA 与 PrimeTime)做全 corner、全模式的多角多模分析(MMMC,Multi-Mode Multi-Corner,背景见 MMMC 之 OCV 与寄生)。精度每上一个台阶,上一阶段「看起来干净」的路径会暴露出新违例——这就是「关了又开」的第一类结构性根因,它不是失败,是精度递进要付的学费。
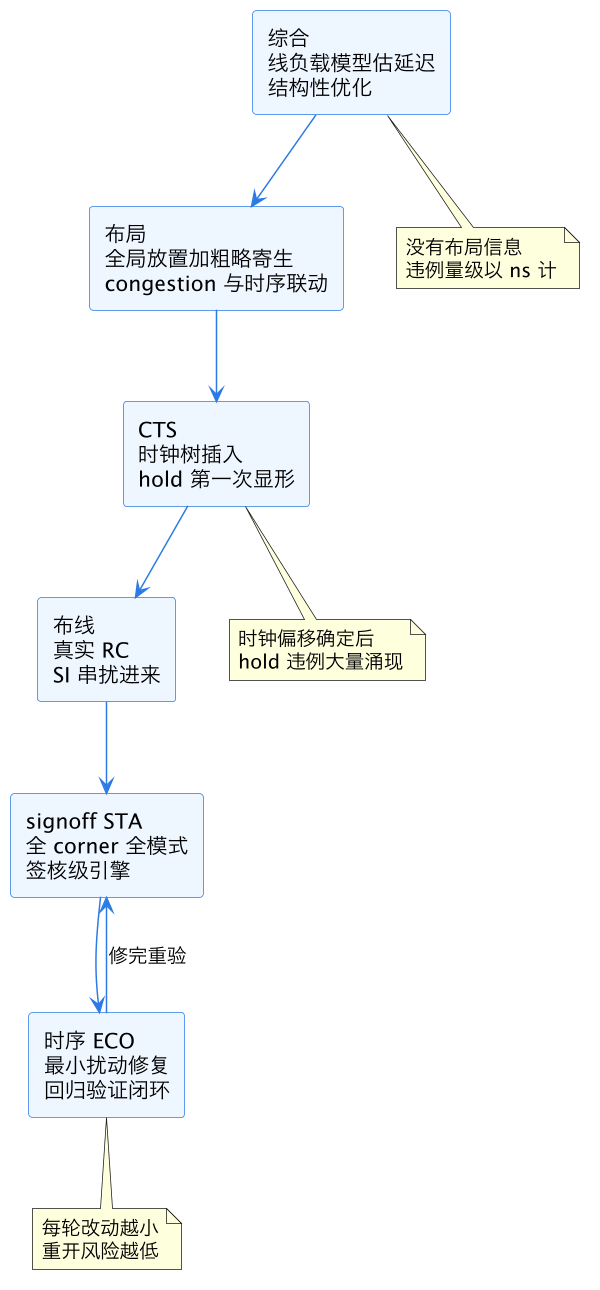
读这张图抓一条主线:迭代对象的粒度沿链条持续变细。综合阶段改的是逻辑结构(重构、复制、retiming),布局阶段改的是物理位置(时序驱动布局,见 全局布局之时序驱动),CTS 之后时钟偏移(clock skew)成为可调变量(useful skew 之 CTS 优化 讲怎么主动利用它),布线之后能动的只剩换 cell、挪线、插 buffer 这类局部手术,signoff 阶段的 ECO 则要求「最小扰动」——改动越小,把已经收敛的别的东西(DRC、功耗、时钟树)撞坏的概率越低。工程上把这条规律叫「优化自由度递减、扰动成本递增」,整条迭代方法学都是围绕它排兵布阵的:大改往前放,小改往后留。
二、各阶段迭代什么:精度递进与违例涌现
把每个阶段的迭代对象钉清楚,才能理解为什么违例会「一波一波」地涌现而不是一次性全暴露。
综合阶段回答「这个逻辑能不能跑到这个频率」。此时没有物理信息,时序全靠线负载模型和约束里的 uncertainty 裕量撑着,所以综合的收敛判据必须留足余量——惯例是综合到 0 违例之后还要再压 10% 到 15% 的时序余量(over-constrain),为后面的物理效应预存款。综合阶段的迭代形态是「跑综合、看 QoR 报告(综合 QoR 报告解读)、调约束或重写 RTL 热点、重综合」,每一轮以天计。这个阶段能修的违例类型最廉价:逻辑层级太深就重构数据通路(综合之数据通路算子选择),扇出太大就复制寄存器。
布局阶段第一次有了物理位置,congestion(布线拥塞)和时序开始打架——为了时序把 cell 摆近会加剧局部拥塞,为拥塞打散又拉长走线。迭代形态变成「布局、看时序和 congestion 双报告、调 placement 约束或 floorplan、重布局」。
CTS 是整个链条上违例形态突变最大的节点。CTS 之前所有时序分析都假设理想时钟(ideal clock),hold 检查没有意义;CTS 一落地,真实时钟偏移确定,hold 违例成批涌现——一个中型设计 CTS 后第一次全量 STA 报出几千条 hold 违例是家常便饭,这正是 STA hold 修复之 buffer 插入 的主战场。布线阶段再上一个精度台阶:真实 RC 寄生、串扰(SI,signal integrity)延迟(STA 串扰之 SI 增量延迟)进来,setup 违例回潮。
| 阶段 | 时序视图精度 | 主要违例形态 | 迭代手段 | 单轮周期 |
|---|---|---|---|---|
| 综合 | 线负载模型 | setup 结构性违例 | 重构/复制/retiming | 天 |
| 布局 | 粗略寄生 | setup 加 congestion 耦合 | 时序驱动布局/floorplan 调整 | 天 |
| CTS 后 | 真实时钟偏移 | hold 大量涌现 | 插 buffer/时钟树再平衡 | 半天到一天 |
| 布线后 | 真实 RC 加 SI | setup 回潮加 hold 残留 | 换 VT/sizing/局部重绕 | 半天 |
| signoff | 全 corner 签核级 | corner 交叉违例 | 时序 ECO 最小扰动 | 小时 |
这张表同时是一份「违例涌现日历」:项目计划里每个阶段的第一轮 STA 都应该预期有违例,预期没有才是计划不现实。资深项目经理看进度时问的不是「还有没有违例」,而是「违例的量级和性质是否在该阶段的正常水位」。
阶段之间的余量接力值得单独画一张图。时序余量(timing margin)在迭代链上的角色类似接力赛里的交接棒缓冲区:综合交棒时多留 10% 到 15%,布局吃一部分,CTS 吃一部分,布线后的 SI 效应再吃一部分,到 signoff 手里必须还剩正裕量——任何一棒把缓冲区吃成负数,后面的阶段就不是在收敛而是在还债。
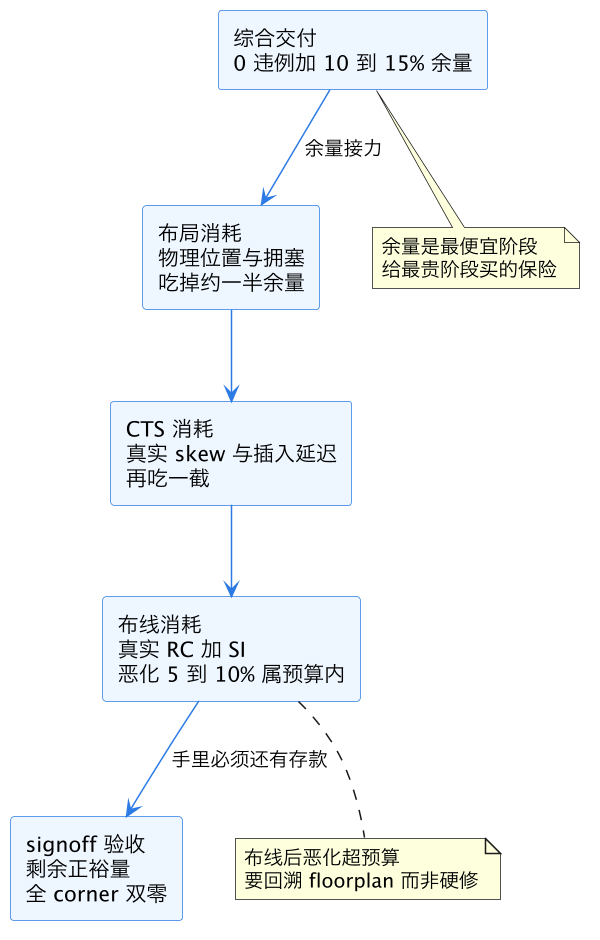
图里最容易被低估的是「布线消耗」这一棒的回溯判据:布线后时序比布线前恶化 5% 到 10% 在先进节点上属于正常预算内,增量修一修就回来了;恶化超过 15% 则几乎总是 floorplan 层面的问题——宏摆位把关键路径挤成绕远、拥塞区被迫拉长走线、供电网格限制了 cell 摆放自由度。这时候在布线后阶段硬修(拼命 sizing、换 LVT)就算把 WNS 修回来,代价也是功耗超标和 hold 恶化,等于把债务从左口袋挪到右口袋。正确姿势是判据触发即回溯:重调 floorplan 或重跑布局,宁可付出一轮大迭代的周期,也不在小迭代里消耗团队士气。
三、收敛曲线怎么读:WNS、TNS 与违例数的三位一体
时序收敛的日常管理靠三个指标:WNS(Worst Negative Slack,最差负裕量,最差路径差多少)、TNS(Total Negative Slack,总负裕量,所有违例路径的违例总和)、NVP(Number of Violating Paths,违例路径条数)。三者必须一起看,单看任何一个都会误判。
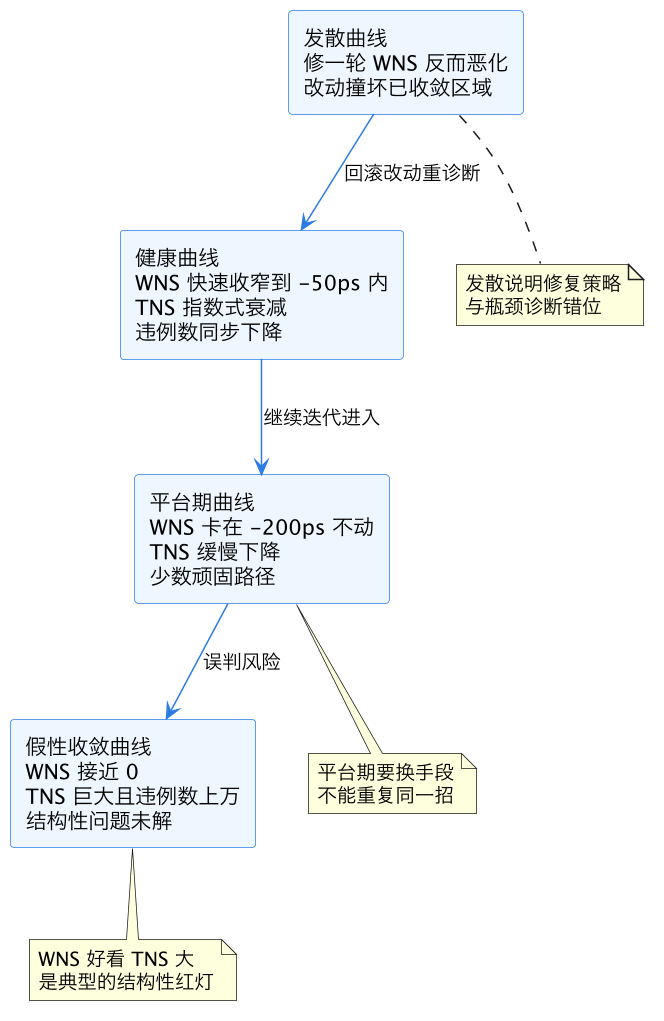
四种曲线形态对应四种处置。健康曲线不用干预,按节奏走就行。平台期曲线是最常见的:同一招(比如反复 sizing)修到边际收益归零,WNS 卡在某几条顽固路径上——这时候要换手段,顽固路径往往卡在物理层面(宏挡道、跨层次绕远)或约束层面(该设 multicycle 的没设,审计方法见 STA multicycle 路径验证),继续拧 sizing 旋钮只会浪费轮次。假性收敛曲线最危险:WNS 接近零让汇报材料很好看,但上万的违例条数意味着设计整体跑不到这个频率,头部路径是被个别「运气路径」撑着的,正确处置是回综合或回 floorplan 做结构性手术,而不是在 PR 里硬修。发散曲线说明修复在撞坏已收敛的东西——典型场景是修 setup 的 sizing 改动加大了下游负载,把原本干净的邻居路径拖下水,处置是先回滚、再用 what-if 分析(时序 ECO 之 what-if 分析)在动手前预演改动后果。
判读曲线还有一条量化经验:TNS 的衰减速率。健康项目里每轮迭代 TNS 应该降一个数量级或至少减半;连续三轮 TNS 降幅不足 20% 就触发「收敛风险评审」,把瓶颈路径拉到架构层面重审。另一个经验数字是违例的 corner 分布:如果违例集中在单一 corner,多半是约束或库的问题(corner 修剪见 corner 修剪之 MMMC 精简);如果所有 corner 同花顺式地违在同一条路径,那是真结构性瓶颈,别指望换 corner 救场。
四、瓶颈分层:修不动的时候先给违例分堆
平台期之后的关键动作是瓶颈分层——把残留违例按根因分堆,不同堆的出路完全不同,混在一起修是收敛周期失控的最大来源。
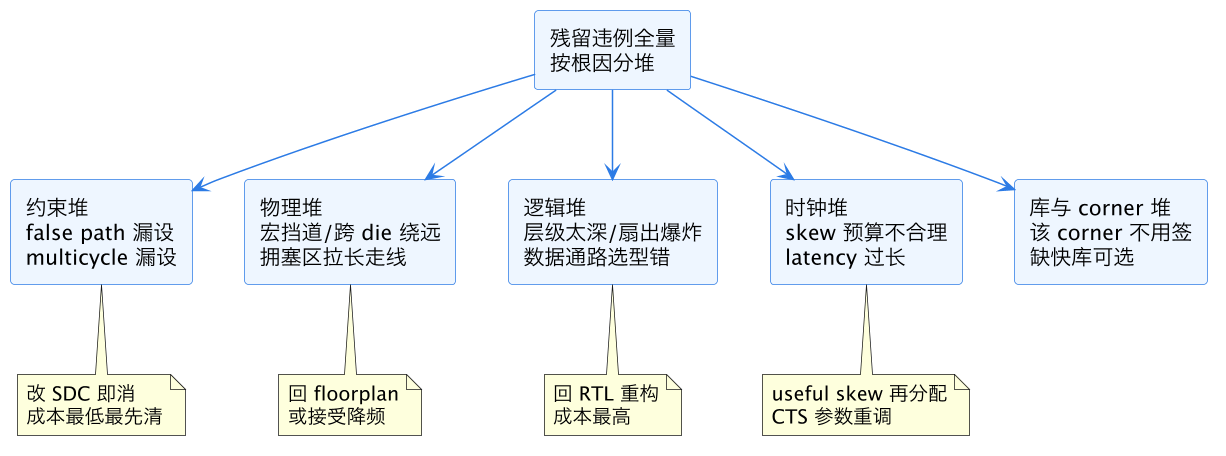
分堆的工程顺序有讲究:先清约束堆,因为它成本最低且数量往往不小——审计方法见 STA false path 审计方法学,一个项目里误伤的假路径违例占残留违例两到三成并不稀奇。约束堆清完,真实的物理堆和逻辑堆才显形。物理堆的典型出路是回 floorplan 挪宏、开 feedthrough(feedthrough buffer 插入)或者在接口时序预算上重新分账(IO 时序预算约束)。逻辑堆最贵——回 RTL 重构意味着前端、验证、回归全部重跑,这就是为什么综合阶段的 over-constrain 纪律那么重要:它本质上是在为最便宜的阶段买最贵的保险。时钟堆的出路是把 skew 当资源重新分配,useful skew 之 CTS 优化 讲的「故意让晚到路径的捕获时钟更晚到」就是这一堆的标准武器;时钟不确定性预算(STA 时钟 uncertainty 与 jitter)过紧时也应该在这一堆复议,而不是在数据通路上硬挤。
分堆还有一个管理价值:它把「时序修不动」从一句模糊的焦虑变成一张可分配的任务清单——约束堆归 STA 工程师、物理堆归 PR、逻辑堆归前端、时钟堆归 CTS 负责人,各堆并行推进,收敛曲线才会恢复下降。
分堆操作本身也有一套手法,不是拍脑袋归类。第一步先做路径分组(path group)透视:把违例按 reg2reg、in2reg、reg2out、in2out 四类分开统计,in2out 成片违例多半是接口预算问题(归物理堆或约束堆),reg2reg 集中在某个时钟域成片违例则指向该域的逻辑深度或 skew 预算。第二步做起点终点聚类:违例路径的起点终点如果密集落在同一个宏或同一个层次边界两侧,物理堆实锤;如果散布全芯片但共享同一种逻辑拓扑(比如同一种宽位比较器),逻辑堆实锤。第三步做 corner 交叉比对:单 corner 违例进库堆复查 corner 合法性,全 corner 同违一条路径直接钉死结构性瓶颈。三步走完,一个上千条的违例清单通常能收敛到个位数的「根因簇」,每簇一个责任人一个出路——这比逐条修路径的效率高出不止一个量级,因为同簇路径共享根因,修一处往往消一片。
五、「关了又开」的根因谱系与冻结纪律
现在正面回答本篇的核心问题:时序为什么关了又开。根因可以钉成五类,每类的防御手段不同。
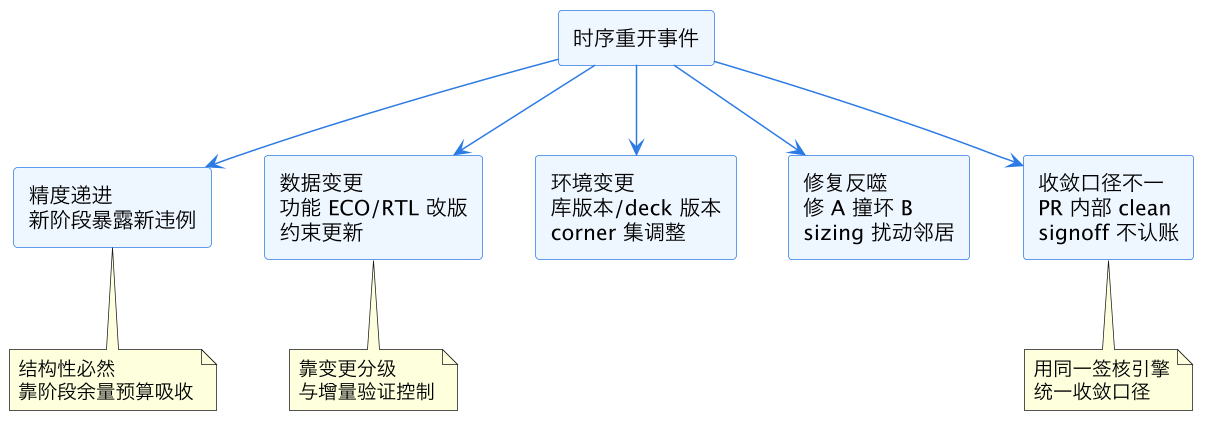
第一类精度递进前文已讲,防御手段是「阶段余量预算」:每个阶段移交时留足给下一阶段的时序存款,存款额度按工艺节点和设计规模历史数据定,先进节点上布线后比布线前恶化 5% 到 10% 是正常预算内。第二类数据变更是项目后期的主力:功能 ECO 改网表(功能 ECO 之网表补丁)、约束更新、甚至换一个 macro 版本,任何输入变更都可能让已收敛时序失效,防御手段是变更分级——改动按影响半径分级,局部改动走增量 STA 回归,结构性改动触发全量重跑,变更传播机制见 数据流 X3 之 ECO 变更传播。第三类环境变更最容易被忽视:库文件升版、signoff deck 换版、corner 集按 foundry 新指南调整,这些「设计本身没动」的变更照样能让时序翻盘,纪律是环境版本与设计版本绑定存档、任何环境升级先在副本上试跑对比再切换。
第四类修复反噬是 ECO 阶段的日常,防御手段就是 what-if 预演加小步快跑:每轮 ECO 的改动量控制在「回归一次能讲清因果」的粒度,几十条路径一批,不要几千条一把梭。第五类收敛口径不一在多人协作项目里高发——PR 工具内部的 STA 说 clean,signoff 引擎说不行,两边 engine 精度、derate 模型(STA derate 建模之 POCV)、CRPR 处理(STA 之 CRPR 时钟收敛)都有差异,唯一解是收敛口径以 signoff 引擎为唯一裁判,PR 内部报告只用于过程导航。
冻结纪律是把五类根因压到可管理范围的组合拳。核心条款三条:其一,分阶段冻结——floorplan 冻结后才准大规模 CTS 调优,时钟树冻结后才准大规模 hold 修复,数据通路冻结后只准 ECO 级改动;其二,变更门禁——冻结期内任何变更走评审,说明影响半径和回归计划;其三,回归自动化——ASIC CI/CD 回归 把「每次改动后自动重跑增量 STA 并对比 QoR」变成流水线动作,靠人自觉的冻结纪律撑不过项目后期的高压。
六、ECO 迭代闭环:最后一公里的工程形态
signoff 阶段的时序 ECO 是整条迭代链的最后一公里,也是「迭代方法学」浓度最高的环节。它的完整闭环是:signoff STA 出违例报告、ECO 引擎或脚本生成修复方案、what-if 预演、物理实现(换 cell、挪位置、连线)、增量提取寄生、增量 STA 回归、判定收敛或进入下一轮。
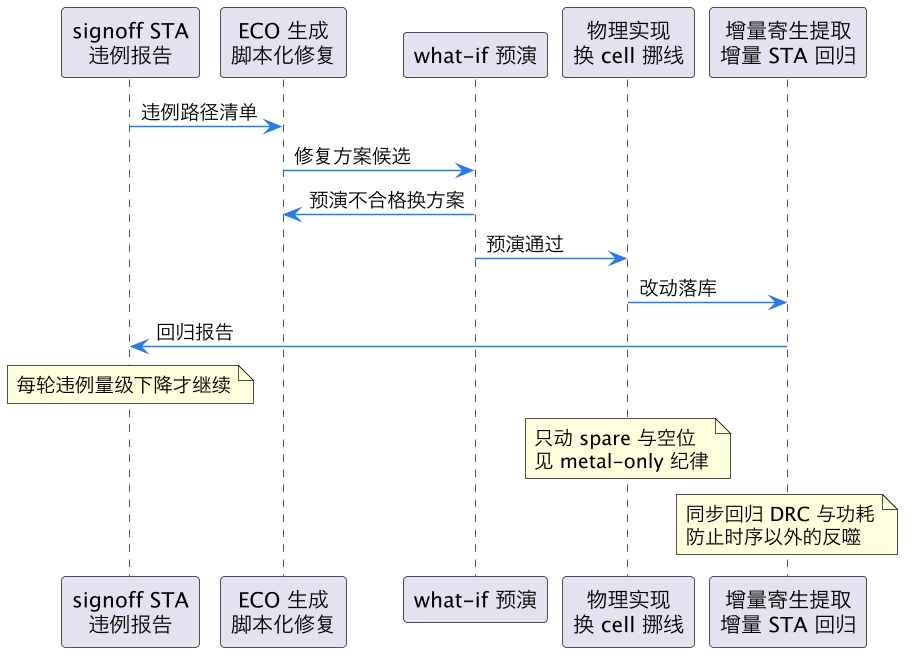
这张时序图里有三个工程要点值得放大。第一,方案生成已经高度脚本化:主流做法是 ECO 工具(或自研脚本,模式见 batch ECO 脚本化流程)按违例路径自动产出「换 VT、sizing、插 buffer」的候选组合,人只审头部疑难路径;PR 之时序收敛 ECO 和 签核收敛 ECO 分别讲了 PR 内与 signoff 两条 ECO 流水线的差异。第二,项目后期物理实现受「metal-only」约束:掩膜分层投产后只允许动金属层,修复手段退化为 spare cell 重连(ECO metal-only 之 spare 流程、ECO spare cell 布局策略),可用的优化自由度进一步收窄——这也是为什么 spare cell 的预布策略要早在 floorplan 阶段就规划。第三,回归不能只盯时序:每次 ECO 回归要同步检查 DRC、功耗(换 VT 直接影响漏电,恢复手段见 multi-Vt 之漏电恢复)、噪声,时序修好了功耗炸了同样是重开。层次化设计里 block 与 top 的 ECO 还要对拍,见 层次化 ECO 之 block top 同步。
七、收敛判据:凭什么说「这一轮真的关了」
最后钉完成判据。零违例是必要条件,但远不是充分条件。一份可以交付的时序收敛判据清单包含六条:一,全 corner、全模式下 setup 与 hold 双零违例(corner 集合本身经过修剪评审,见 corner 修剪之 MMMC 精简);二,max transition、max cap、max fanout 等设计规则类时序检查同步干净(STA max tran/cap/fanout 检查),这类违例不修会以「信号完整性」的形式回来报复;三,脉冲宽度、recovery/removal、clock gating 检查全过(min period 脉冲宽度检查、STA recovery/removal 检查、clock gating 检查之 STA)——这三类是「容易忘、忘了就流片失败」的检查项;四,时序签核用的数据版本与物理验证签核一致(寄生来自填充后版图,与 物理验证签核流程 的末次数据同源);五,残余风险登记在案:被 waiver 的违例、被评审接受的边缘路径、未覆盖角的外推依据,全部写进签核包;六,QoR 仪表盘(数据流 X5 之 QoR 看板)归档,作为下一版硅反馈(数据流 X6 之硅反馈)的基线。
| 判据 | 检查内容 | 常见漏项 | 漏项后果 |
|---|---|---|---|
| 双零违例 | setup/hold 全 corner 干净 | 只查 signoff corner 子集 | 量产温区翻车 |
| 设计规则时序 | max tran/cap/fanout | 只看 setup/hold | SI 问题回潮 |
| 专项时序检查 | pulse width/recovery/clock gating | 低功耗域漏查 | 流片功能失效 |
| 数据同源 | 寄生与填充后版图一致 | 用填充前 SPEF | 时序漂移数个百分点 |
| 风险登记 | waiver 与边缘路径在案 | 口头豁免无记录 | 复盘无据可查 |
| 基线归档 | QoR 看板存版 | 无存档 | 硅反馈无法对拍 |
六条判据全部打勾,才允许说「时序收敛」四个字。行业里把只满足第一条的状态叫「timing clean」,把六条全满足叫「timing closed」——前者是过程态,后者是交付态,混用这两个词是项目评审会上最常见的误导。
这一篇在知识体系里的位置
本篇是 eda/ 目录时序专题的枢纽深文:向上挂主线流程的 数据流 S5 之签核收敛,向前衔接 PR 之时序收敛 ECO 与 签核收敛 ECO 两条 ECO 流水线;向下收拢已发长尾——setup 修招在 STA setup 修复之换 VT 与 sizing、hold 修招在 STA hold 修复之 buffer 插入、时钟侧武器在 useful skew 之 CTS 优化、corner 治理在 corner 修剪之 MMMC 精简、批量修复在 batch ECO 脚本化流程、动手前预演在 时序 ECO 之 what-if 分析;横向关联 Signoff STA 与 PrimeTime(收敛的唯一裁判)、STA false path 审计方法学(约束堆清理)、数据流 X3 之 ECO 变更传播(重开控制)与 数据流 X5 之 QoR 看板(收敛判据的仪表盘化)。
总结
时序收敛迭代方法学的核心是把「关时序」当成一条有精度递进、有节奏、有判据的工程流水线来管理:综合留余量、布局平衡拥塞、CTS 后 hold 涌现用 buffer 收口、布线后吸收 SI 回潮、signoff 以唯一裁判做全 corner 裁决;日常靠 WNS/TNS/违例数三位一体的收敛曲线导航,平台期先按约束、物理、逻辑、时钟、库五堆给违例分层再分头处置,「关了又开」用阶段余量预算、变更分级门禁与冻结纪律压缩,ECO 最后一公里走「生成、预演、实现、增量回归」的小步闭环——最终以双零违例、设计规则时序干净、专项检查全过、数据同源、风险登记、基线归档六条判据宣告 timing closed:收敛签的不是「这轮报告没有红字」,而是「任何一次重开都有预算、有门禁、有交代」。