存储器修复 BIRA/BISR:冗余行列分配算法、内建自修复结构与修复信息烧录的硅后联动
更新时间:2026-10-03。先进工艺下 SoC 一半以上的面积是 SRAM,一颗大芯片几百上千个存储器实例,任何一个 bit 打坏都可能让整颗芯片报废——冗余行/列加自修复就是把这部分良率捞回来的标准手段。整套机制分两半:BIRA(Built-In Redundancy Analysis,内建冗余分析)是一块小逻辑,拿到 MBIST 跑出来的故障位图后算出「用哪根冗余行换哪根坏行、用哪根冗余列换哪根坏列」的分配方案;BISR(Built-In Self-Repair,内建自修复)是执行机构,把 BIRA 的方案写进修复寄存器或熔丝,让后续的地址访问被重映射到冗余资源上。本站的 MBIST 存储器内建自测 讲了故障怎么被抓出来,MBIST March 算法 讲了故障模型和测试原语,IJTAG 1687 网络 讲了仪器访问骨架。这一篇补齐下游:抓到故障之后,「算方案、熔方案、验证方案」这条链怎么走,以及硅后诊断怎么和 BIRA 结果对账。
本文要回答的问题
- BIRA 和 BISR 的职责边界在哪,软修复和硬修复差别是什么?
- 冗余行/列分配是个什么算法问题,为什么「必须修复」和「可以修复」要分开判?
- 修复信息从 BIRA 寄存器到 eFuse 烧录的完整流程是什么,上电加载怎么工作?
- RTL 阶段怎么验证 BIRA 算出来的方案真的修好了存储器?
- 硅后 CP/FT 上 BIRA 结果和诊断数据怎么联动,修不了怎么分诊?
一、职责边界:MBIST 抓故障、BIRA 算方案、BISR 执行重映射
先把三个角色钉死。MBIST 控制器负责跑 March 算法,把存储器阵列过一遍,每抓到一个失配就吐出「故障地址 + 失效 bit 位置 + 失效的算法原语」三件套,自己不做任何决策。BIRA 是决策者:它收集整个测试过程中的故障记录,在冗余资源(spare row、spare column,数量物理固定,比如每 bank 2 行 2 列)的约束下解一个分配问题,输出「可修复/不可修复」加一张映射表。BISR 是执行者:它拿这张映射表配置比较器——此后 CPU 或总线访问到坏行地址时,地址译码路径上的比较逻辑命中,访问被悄悄导到冗余行,软件完全无感。
上图是全链路的骨架。注意 eFuse 那个环:BISR 有两种工作模式——软修复(soft repair)每次上电重跑 MBIST 加 BIRA,方案只放寄存器里,断电即失,优点是 born-die 缺陷和使用中老化的故障都能修;硬修复(hard repair)在 CP(晶圆测试)阶段把方案烧进 eFuse,上电时由加载逻辑把熔丝值灌回 BISR 寄存器,优点是开机即用、不占用启动时间。量产芯片通常两者结合:制造缺陷走硬修复,留少量冗余资源给软修复兜底现场退化。
二、BIRA 的分配算法:必须修复先行、可修复补位
冗余分配本质上是一个带约束的覆盖问题:故障位的集合要用有限的冗余行和冗余列盖住。一根冗余行能修掉该行上任意多个故障 bit,一根冗余列同理;难的是故障往往散落在行列交叉处,行和列怎么搭配用最少资源盖住所有故障点,是 NP-hard 的组合问题。工程实现不追求全局最优,用两条规则的贪心足够好,而且必须在片上以可接受的面积和周期数跑完。
第一条规则:必须修复(must-repair)先行。某一行上的故障 bit 数超过剩余冗余列能盖住的总量时,这一行没有别的选择,必须用冗余行换——这类行叫 must-row,列同理。BIRA 先扫描故障位图把所有 must-row/must-col 挑出来强制分配,这一步没有任何自由度。第二条规则:可修复(repairable)补位。剩余零散故障用启发式分配,常见做法是每次选「覆盖剩余故障最多」的行或列,直到故障清空或冗余耗尽。如果冗余耗尽还有故障没盖住,输出不可修复标志,这颗 die 在 CP 上直接判废或降级。
这张图是 BIRA 的决策流。工程上有两个细节值得记:一是故障位图要不要全存。大容量 SRAM 全位图存不下,BIRA 通常只维护故障行/列的压缩表示(按行地址聚合的计数表),牺牲一点最优性换面积;二是算法运行在测试时钟下,March 测试和 BIRA 分析可以边测边算(on-the-fly),也可以测完再算,前者省测试时间后者逻辑简单,商用 MBIST 工具两种都支持。和 ATPG 压缩向量 里压缩与诊断信息的折衷是同一类工程权衡。
三、从寄存器到 eFuse:修复信息的烧录与上电加载
BIRA 算出的映射表存在易失寄存器里只是第一步,硬修复要把它变成永久数据。完整流程是:CP 测试机上 MBIST 跑完,BIRA 结果通过 JTAG TAP 控制器 或 IJTAG 网络读出到 ATE;ATE 把全片几百个存储器的映射表拼成一张烧录镜像,加上 ECC 校验位,发给 eFuse 烧录器逐位熔断;烧完回读校验,确认熔丝内容和镜像一致。之后每次上电,复位释放前 eFuse 控制器自动把熔丝值串行搬进各 BISR 寄存器,搬运完成才放行系统时钟——这就是「上电加载」(fuse load),耗时取决于熔丝位数的总量,大芯片几十微秒到几毫秒。
| 维度 | 软修复(寄存器方案) | 硬修复(eFuse 烧录) |
|---|---|---|
| 生效时机 | 每次上电重测重算 | 上电加载即生效 |
| 能修的故障 | 制造缺陷加现场退化 | 仅 CP 时可见的制造缺陷 |
| 测试时间开销 | 每次启动付出 MBIST 时间 | 只付一次烧录时间 |
| 不可逆性 | 无,可重跑 | 熔丝不可逆,烧错即废 |
| 典型用途 | 车规现场自修复、兜底 | 量产良率修复主力 |
这张表是选型决策的核心。两个工程坑要点名:一是熔丝不可逆,烧录镜像拼接错一个 bit(比如存储器实例顺序排错),整颗芯片永久修错——所以烧录前必须回读 BIRA 原始数据做交叉校验,烧录后必须重跑 MBIST 确认「修复生效后测试全绿」;二是ECC 和重烧策略,eFuse 自身也可能烧不透或随时间退化,量产流程通常给修复区配 ECC,并预留第二份冗余的熔丝块支持一次重烧。烧录接口的边界扫描描述见 BSDL 边界扫描描述。
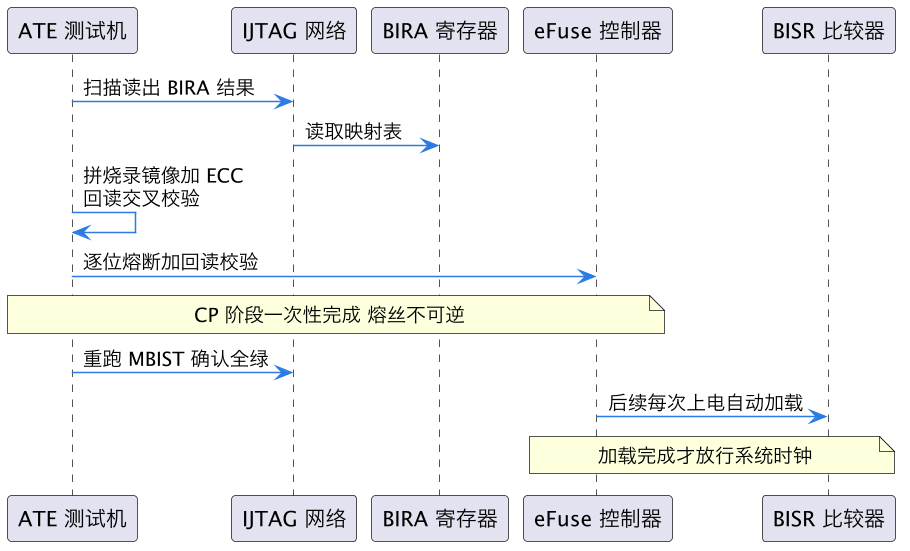
这张时序图把 CP 上的一次性动作和每次上电的重复动作分成了上下两段。验证环境里要重点测的是上电加载那一段的复位时序:熔丝加载没完成就放行时钟,BISR 比较器里是 X,好地址也可能被误重映射——这类 bug 在门级仿真加 X 传播(见 门级仿真 SDF Xprop)时才会现形。
四、RTL 验证:怎么证明 BIRA 的方案真的修好了
BIRA/BISR 验证的难点在于「正确的修复方案」本身就是一个算法输出,没法人肉对拍。标准打法是故障注入加行为级参考模型双线。故障注入侧:在存储器行为模型(SV 存储器模型后门 讲了后门读写机制)里用后门把指定 bit 钉成 stuck-at,故障位置由约束随机生成——随机撒点、聚簇成行、聚簇成列、行满列满的 must 场景、超容量不可修场景,每个类别都要打到。参考模型侧:用软件(C 或 SV class)实现一份黄金 BIRA 算法,和 RTL 的 BIRA 吃同一份故障位图,比对映射表是否等价——注意是等价不是相等,覆盖问题有多个合法最优解时两者不同但都算对,比对器要按「故障全覆盖加配额不超限」判而非逐位比。
第二条验证主线是端到端修复确认:注入故障后先跑一遍 MBIST 确认变红,触发 BIRA/BISR,再跑一遍 MBIST 必须全绿。这个「先红后绿」的翻转是修复链路生效的最强证据,而且要用不同的 March 算法各跑一遍——只测一次可能漏掉比较器只重映射了部分地址位的 bug。第三条线是上面说的上电加载与复位时序,放在门级或带时序的仿真里做。功能覆盖率方面,covergroup coverpoint bins 的机制可以用来给「故障密度 x 冗余配额使用率」打交叉覆盖,确保 must 边界、恰好修满、差一根修不满这些角落都转过。
上图是验证环境的组织结构:一份注入喂两个 BIRA,等价比对解决「多个最优解」的判等难题,端到端翻转解决「映射表对了但重映射没生效」的盲区。经验数据:这类环境里抓到的真实 bug 六成在比较器地址位宽和 bank 拼接上,三成在 BIRA 边界(must 判定、配额回绕),一成在加载时序——故障注入的随机密度要往高配额占用率倾斜,低故障密度下什么实现都是对的。
五、硅后联动:CP/FT 上的对账与不可修复分诊
流片回来后,BIRA 从「被测对象」变成「良率数据来源」,和硅后流程的联动有三件事。第一件是对账:CP 上每颗 die 的 BIRA 结果(哪些存储器用了几根冗余、有没有不可修)要落进测试数据系统,和诊断工具从失效位图反推出的物理缺陷位置交叉比对——BIRA 说用了 2 根冗余行,诊断说缺陷落在 2 个行地址上,两边对得上说明修复可信;对不上(比如 BIRA 修了 3 行但诊断只看到 2 个缺陷簇)往往意味着 BIRA 算法在某种故障拓扑下过度消耗冗余,是算法改进的输入。这属于 硅后 bringup 调试 里数据回流的常规一环。
第二件是不可修复分诊。BIRA 判不可修的 die 不要直接扔:诊断数据要回答「是真没冗余了,还是 BIRA 误判」。真没冗余的进失效分析看缺陷来源;误判的(比如 must 判定把可修的判成不可修)是 RTL bug,走 CP FT burn-in 诊断 的分诊流程回填验证。第三件是现场软修复监控:车规芯片运行中周期性跑 MBIST 加 BIRA 做在线修复,修复事件的频次趋势是存储器退化速率的直接观测——某颗芯片软修复调用突然频繁,往往预示阵列在加速老化,这个信号要进预测性维护系统。层级化大芯片上 BIRA 结果的逐层汇聚还依赖 层次化 SoC 测试访问 讲的访问路径。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录 DFT 存储器线的一篇 S 层深文,主关键词 BIRA BISR。向上承接 MBIST 存储器内建自测 与 MBIST March 算法 的故障抓取能力,把「抓到故障之后怎么办」这一环补齐;横向与 IJTAG 1687 网络(仪器访问)、JTAG TAP 控制器(烧录通道)、ATPG 压缩向量(同类工程权衡)互为支撑。验证方法论上复用 SV 存储器模型后门 的注入手段与 covergroup coverpoint bins 的覆盖机制。向下,BIRA 数据汇入 硅后 bringup 调试 与 CP FT burn-in 诊断,完成从设计到良率的闭环。
总结
BIRA/BISR 是嵌入式存储器良率修复的决策与执行组合:MBIST 抓故障,BIRA 在固定冗余配额下用「必须修复先行、启发式补位」的贪心算法解行列分配,BISR 把映射表熔进比较器让坏地址透明重映射到冗余资源;工程上要守住四件事——硬修复走 eFuse 且烧录前后双重校验(熔丝不可逆)、软修复留给现场退化兜底、RTL 验证靠故障注入加黄金参考模型做等价比对并坚持「先红后绿」端到端翻转、硅后坚持 BIRA 结果与诊断数据对账并把不可修复分诊回填验证——修复链条每一环都有独立的失效模式,只有闭环对账才能让「良率捞回来了」这句话可信。