FPGA 入门 18:GPU 计算入门与 FPGA 对照
更新时间:2026-09-12。本文是
fpga/入门层第 20 篇。选型直觉先看 FPGA vs CPU/GPU/ASIC/MCU,AI 推理视角见 神经网络与 FPGA,HLS 为什么是"FPGA 上类 CUDA 的 C 编程"见进阶 HLS 入门。
本文要回答的问题
- CPU、GPU、FPGA 三种「并行」到底差在哪?SIMT、warp、海量线程切换是什么意思?
- 一个 CUDA kernel 从主机到设备大概怎么跑:grid/block/thread、显存拷贝、合并访存?
- GPU 为什么喜欢大批量、规则、高算术强度的负载,又为什么怕小批量、硬实时、不规则分支、自定义接口?
- FPGA 没有核心和指令,「流水线并行」为什么能做到拍数确定的亚微秒延迟?
- warp divergence(分支发散)、kernel 启动开销、CPU-GPU 数据搬运分别怎样吃掉性能?
- 从延迟、抖动、吞吐、功耗、带宽、灵活性、开发难度、生态几个维度,GPU 和 FPGA 怎么系统对比?
- 真实系统里 GPU、FPGA、CPU 通常怎么协同分工(采集/前处理/训练/推理/数据搬运)?
- 为什么 AI 训练在 GPU,而低延迟推理、协议加速常常下沉到 FPGA?
读完本文,你不写 CUDA 也能建立够用的工程判断:面对一个加速需求,能说清它更像 GPU 的菜还是 FPGA 的菜,以及在异构平台里把每段任务放到哪最合适。
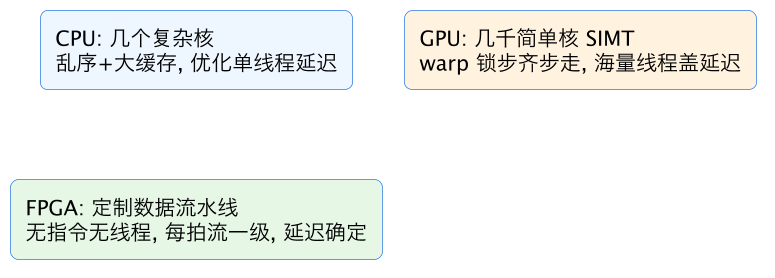
一、三种"并行"心智模型
二、CUDA 流程(知道即可)
host 分配/拷贝数据 → 启动 kernel(grid→block→thread,每线程算一个元素)→ 拷回结果。性能关键:合并访存、少分支、数据驻留显存。
三、GPU vs FPGA 对照
| 维度 | GPU | FPGA |
|---|---|---|
| 硬件 | 固定众核,软件调度 | 可重构流水线电路 |
| 并行表达 | 几千线程 SIMT | 流水线/数据级并行 |
| 单任务延迟 | 微秒~毫秒,抖动 | 拍数固定,亚微秒确定 |
| 强项负载 | 大批量、规则、高算术强度 | 低延迟、自定义接口、前处理 |
| 弱项 | 小批量、硬实时、不规则分支 | 大算力浮点、软件生态 |
| 开发 | CUDA/C++,库丰富 | RTL/HLS,周期长 |
| 典型场景 | AI 训练、渲染、科学计算 | 采集前处理、推理、协议加速 |
四、协同分工
- FPGA:贴传感器/接口 → 采集、解析、滤波前处理、线速数据搬运;
- GPU:规整大批量重计算(训练、矩阵运算、渲染);
- CPU:控制、调度、软件栈;
- AI:训练在 GPU,低延迟/边缘推理下沉 FPGA。
五、SIMT:GPU 并行模型再讲细一点
CPU 为「让少数线程跑得尽量快」优化:复杂的乱序执行、分支预测、大缓存、每个核很强。GPU 反过来,为「用海量简单线程做同样的事」优化:几千个小核心组成流式多处理器(SM/CU),按 SIMT(Single Instruction, Multiple Thread,单指令多线程) 工作。
- warp(NVIDIA,AMD 称 wavefront):32 个(AMD 64 个)线程组成一组,锁步执行同一条指令,但各自处理不同数据。当这 32 个线程走同一个分支时,一条指令算 32 份数据,效率满格。
- 分支发散(warp divergence):若同一 warp 内线程因条件不同走向不同分支,硬件只能把两条路径串行执行(一条路径时另一路径线程空转),并行度骤降。这是 GPU 怕不规则分支的硬件原因。
- 海量线程掩盖访存延迟:单个线程访问显存要几百个周期,GPU 不等它,而是切换到同核心上另一批就绪线程,用足够多的并发把显存带宽吃满。线程切换是硬件管理的、几乎免费,但前提是你得有足够多、且规则的线程。
- 内存层级与合并访存:同一 warp 的线程若访问连续对齐的显存地址,硬件能把这些访问合并成少数几次宽传输(coalesced access);若地址散乱,则效率大降。共享内存(on-chip SRAM)供一个 block 内线程复用数据。
一句话心智:CPU 是几个资深工程师并行解决复杂任务,GPU 是几千个按统一口令齐步走的工人做海量重复工作。
六、一个 CUDA 程序的生命周期
不教语法,只建立「数据怎么动、并行怎么表达」的直觉:
- 主机(CPU)在内存准备输入,在显存
cudaMalloc分配空间,cudaMemcpy把数据 Host→Device; - 以 grid/block/thread 三层配置启动 kernel:一个 grid 含若干 block,一个 block 含若干 thread(常见 128/256);
- 每个线程用内建变量算出自己的全局编号,只处理结果数组中对应下标(典型 SPMD:同一份代码、不同数据);
- kernel 里是普通 C/C++ 加少量关键字,几千线程同时执行;
- 算完再
cudaMemcpy把结果 Device→Host。
性能关键点:①数据要在 GPU 上「待够久」,避免算一点搬一点(PCIe 搬运很贵);②让相邻线程访存连续以触发合并访问;③尽量减少 warp 内分支发散;④给够大批量把几千核心喂饱。这套「写一个线程做什么、复制成几千份」的并行表达,和 FPGA「设计一条数据如何逐拍流过电路」是两种根本不同的范式。
七、GPU 的四类「不擅长」,恰好是 FPGA 的主场
- 小批量/单请求:kernel 启动、显存分配与搬运有微秒级固定开销,数据量小时这些开销主导,GPU 大量核心闲置;FPGA 流水线上来一笔数据就按固定拍数处理,没有启动惩罚。
- 硬实时、确定性低延迟:GPU 的完成时间依赖调度、缓存、显存占用,抖动大,难以承诺「几十纳秒内必响应」;FPGA 数据通路延迟 = 流水级数 × 时钟周期,编译后固定,可做最坏情况分析(STA,见进阶 静态时序分析)。
- 不规则控制/分支:warp divergence 让并行退化;FPGA 里分支就是 mux/状态机,不同操作甚至可以做成并行电路,没有「发散」概念。
- 自定义硬件接口与时序:GPU 收不到 LVDS/MIPI/自定义串行协议,数据必须先进 CPU/网卡;FPGA 可以直接在引脚级实现几乎任意数字接口和精确定时(见 开发板外设地图、SPI ADC)。
八、FPGA 的确定性延迟从哪来
在 FPGA 上,你设计的是一条空间上铺开的流水线:数据每个时钟沿前进一级,一级做一点运算。若一条通路有 K 级寄存器、时钟周期 T,则单个结果从进入到出来的延迟就是 K×T(确定值),而流水线填满后每个周期都能输出一个新结果(高吞吐)。这里没有:取指令/译码(不是冯·诺依曼执行模型)、缓存未命中(数据按你设计的 RAM 层次驻留)、线程调度、分支预测。
代价也明确:①功能由电路固定,改算法要重新综合/布局布线甚至重写 RTL,开发周期长;②通用软件生态、库、调试工具不如 CUDA;③浮点大算力绝对值通常不及高端 GPU;④并行度受片上 DSP/RAM/逻辑资源限制。因此 FPGA 的强项不是「峰值 FLOPS 最高」,而是「确定性、低延迟、可定制接口、能效比、与传感器紧耦合」。
九、从数字感受两者的延迟/吞吐差异
量级对比(仅建立直觉,具体数字随代际变化):
- GPU kernel 端到端延迟:启动、调度、显存往返常在几微秒到毫秒级,且随负载抖动;适合把几千个核心喂满的大批量任务,峰值吞吐(TFLOPS/TOPS)非常高。
- FPGA 流水延迟:数据进来到结果出来由流水级数决定,配合几百 MHz 时钟,常是几十纳秒到亚微秒/微秒级,且每个样本都一样,没有「排队等调度」的抖动。
- 接口侧:FPGA 可在 I/O 引脚直接以线路速率解析协议、做时间戳和过滤;GPU 拿到的是已经过网卡/CPU 整理的数据。
- 能效:FPGA 没有取指/缓存/大量通用核心开销,固定流水做特定任务时常有更优的性能/瓦,但开发成本高、灵活性低。
所以不能只比「谁 TOPS 高」:大矩阵乘、训练、渲染、科学计算这类大批量规则高算术强度任务,GPU 的绝对吞吐和生态碾压;单包网络处理、高频交易信号、传感器实时控制、小批量 AI 推理这类「延迟和确定性优先、还要接硬件」的任务,FPGA 更合适。算术强度、batch 大小、延迟上限、接口需求四个量决定答案。
十、真实异构系统如何分工
实际加速平台常常 CPU+GPU+FPGA 同框,各管最擅长的一段:
- 采集与前处理链:FPGA 紧贴 ADC/传感器/高速口,做采集、串并转换、协议解析、滤波、降采样、像素预处理,把杂乱的实时信号整理成规整数据(确定性、自定义时序)。
- 重计算/训练:规整大批量数据送 GPU 做矩阵运算、渲染、模型训练,吞吐最大化。
- 控制与软件栈:CPU 跑操作系统、调度、文件系统、业务逻辑、不适合硬件加速的不规则任务。
- 网络/存储加速:FPGA 做 SmartNIC、压缩解压、加解密、数据搬运,线速、低延迟、释放 CPU。
- AI 链路:GPU 在云端训练,FPGA/ASIC 在边缘或数据中心做低延迟、低功耗推理(见 神经网络与 FPGA)。
- 金融/电信:FPGA 在网卡旁做纳秒~微秒级策略与基带处理,GPU 集群做回测、训练、离线分析。
数据在三者间流动是有成本的(PCIe、以太网搬运),好的划分让每段数据在对应器件上「一次搬入、处理充分、再搬出」,避免来回倒手——这一点对 GPU 和 FPGA 都成立。
十一、决策口诀与一张判断表
口诀:规则大批量、高吞吐、生态依赖强 → GPU;确定性低延迟、自定义接口、小批量灵活、贴近传感器/线速 → FPGA;复杂控制、不规则、快速迭代 → CPU。
| 需求特征 | 更偏向 |
|---|---|
| 海量规则并行、浮点矩阵乘、模型训练 | GPU |
| batch=1 也要微秒内确定响应 | FPGA |
| 直接对接 LVDS/MIPI/自定义串行时序 | FPGA |
| 算法频繁变化、靠丰富软件库快速迭代 | GPU/CPU |
| 线速网络/存储/协议处理、时间戳 | FPGA |
| 数据前处理 + 后段重计算 | FPGA 前处理 + GPU 计算 |
| 极致单位成本/功耗且算法已固化、量极大 | ASIC(FPGA 做原型/中小批量) |
需要注意 FPGA 也在「软化」:HLS 让你用 C/C++ 加指导生成电路(见进阶 HLS 入门),高层综合和 AI 工具链降低了门槛;GPU 也在加入更确定的执行能力和网卡直连。但两者的根基——固定众核 + SIMT 软件调度 vs 可重构空间流水线——没有变,选型逻辑也基本稳定(总览见 FPGA vs CPU/GPU/ASIC)。
十二、自测要点与学习地图
自测:① 用「工人比喻」解释 CPU、GPU、FPGA 三种并行;② 说明 warp 和分支发散为什么让 GPU 怕不规则分支;③ 列出 CUDA 程序的主要阶段和两个最大性能开销;④ 解释 FPGA 流水延迟为何确定、写成 K×T;⑤ 各举两个「明显该上 GPU」「明显该上 FPGA」的负载并说明理由;⑥ 描述一条传感器→决策的异构链路各段归谁;⑦ 说明为什么 AI 训练在 GPU、边缘推理常下沉 FPGA。
学习地图:选型总览先看 FPGA vs CPU/GPU/ASIC;AI 视角看 神经网络与 FPGA;理解 FPGA 确定性的基础是 计数器与时钟使能、时序报告入门 与进阶 静态时序分析;想用类 C 方式写 FPGA 看进阶 HLS 入门;系统学习 GPU/CUDA 可去独立的 GPU 计算域(gpu/)。
十三、把常见应用「对号入座」
- 视频 AI 摄像头:FPGA 接 MIPI/LVDS 做采集、去马赛克、缩放等前处理,再跑小批量量化推理(或把大模型送 GPU),原因是接口和确定性都在传感器侧——典型 FPGA 主场。
- 数据中心训练大模型:海量浮点矩阵乘、需要 CUDA/cuDNN 生态和高带宽显存——GPU/NPU 主场。
- 高频交易/行情解析:网卡进来的每个包要在固定、极低延迟内解析、决策、发出,不能接受调度抖动——FPGA 在线速侧,GPU 做回测。
- 科学计算/渲染/离线转码:大批量、规则、可排队——GPU。
- 软件无线电、电机控制、实时协议桥:精确到时钟周期的时序和自定义物理接口——FPGA(见 VGA 显示、SPI ADC 这类「必须自己造时序」的例子)。
- 大批量图像分类推理(云端):吞吐优先、可批处理——GPU 或专用 ASIC;边缘单帧低延迟则倾向 FPGA。
- 原型验证一个未来要流片的 ASIC:先用 FPGA 验证功能与时序,再量产 ASIC 摊薄成本。
判断时不要被「谁更先进」带偏,二者是为不同约束优化的工具:GPU 用时间维度上的海量线程获得吞吐,FPGA 用空间维度上铺开的专用电路获得确定性和定制性。
十四、常见误解澄清
- 「FPGA 并行度比 GPU 高,所以什么都更快。」错。并行的「种类」不同:GPU 有几千个现成浮点核心,峰值通用算力通常高得多;FPGA 并行度取决于你摆多少运算单元和片上资源,且开发代价大。
- 「上 FPGA 延迟一定低。」只有写得好的流水化设计才低。若 FPGA 里跑软核、经操作系统/总线反复搬数,延迟也会很高;确定性来自「数据通路化」,不是来自芯片名字。
- 「GPU 不能做实时。」在可排队、毫秒级实时且能批处理的场景,GPU 完全胜任;它不擅长的是微秒/纳秒级、抖动受限的硬实时和物理接口。
- 「学会一个就够了。」真实平台常是异构协同,理解彼此边界(包括 CPU)才能把任务放对位置,这也是本文的核心目的。
怎么量化「确定性」
FPGA 的时序由 STA 在编译期保证:时钟周期、路径延迟、建立/保持 slack 都有上界(见 时序报告入门),最坏情况可计算。GPU 的单次任务时间受 warp 调度、显存竞争、其他 kernel 影响,只能给统计分布(平均、尾延迟 P99/P999),无法给「这条数据必在 N 纳秒内完成」的硬保证。控制系统和高速协议要的正是前者那种硬保证。
十五、同一任务,两种写法的心智对照
用「对一个数组每个元素做一次固定运算」这个极简任务体会两种范式:
- CUDA 思路:写「一个线程如何处理
a[i]」,启动 N 个线程;性能关注点变成索引怎么算、相邻线程是否连续访存、一个 block 多少线程、数据何时搬到显存、kernel 启动几次。你在调度大量时间上并发的线程。 - FPGA/RTL 思路:设计数据如何在空间上流动——每拍读一个元素、经一级或多级运算流水、若干拍后每拍输出一个结果;性能关注点变成流水级数能否跑到目标频率、输入/输出带宽够不够、状态机怎么控制、时序是否收敛。你在铺设一条电路。
前者改算法主要改 kernel 代码、重新启动即可;后者改算法往往要改电路结构并重新综合。灵活性的差距就在这里,但后者因此换来了无调度、无指令、延迟确定和接口可定制。HLS 试图弥合二者:用 C/C++ 描述流水/并行,让工具生成 RTL,是「想用软件方式获得部分 FPGA 优势」的折中(见进阶 HLS 入门)。
对 FPGA 学习者的实际意义
理解 GPU 不是为了转行写 CUDA,而是建立异构判断力:①知道哪些需求不该硬塞给 FPGA(大批量浮点训练、生态依赖重的任务);②在联合项目里能和 GPU/软件同事对齐接口与数据边界;③看懂「FPGA 做前处理+确定性、GPU 做批量重计算」的分工为什么高效;④评估方案时同时问延迟(含抖动)、吞吐、带宽、功耗、开发周期和可维护性,而不是只比峰值算力。把这套判断和本系列的 RTL、时序、接口能力结合,你就能在真实系统里做出合理的硬件加速选型,而不是执着于「用一种器件解决所有问题」。
最后把两种架构的「第一性原理」再压缩一遍:处理器(CPU/GPU)的灵活性来自用同一套硬件、靠软件在时间上复用——取指令、调度、缓存让同一批运算单元能跑任意程序,代价是每条数据都承担指令和调度开销、完成时间是统计量;FPGA 的确定性来自为这个任务专门铺一条数据通路、让数据在空间上并行流动——没有指令、没有调度,代价是换任务就要重构电路、开发更重。看懂这条取舍,你就理解了为什么训练在 GPU(问题大而规则、要灵活性和生态)、线速与硬实时在 FPGA(问题确定、要接口与最坏延迟)、复杂控制在 CPU(要通用与快速迭代),也能在新硬件(带 AI 引擎的 FPGA、GPU 的 DPU/网卡直连、各类 NPU/ASIC)不断出现时,依然用「时间复用 vs 空间定制、统计延迟 vs 确定延迟、通用生态 vs 专用能效」这几个不变的维度快速归类。这比记住任何一款具体产品的参数都更经得起时间考验。等你后面真正接触带 AI 引擎的自适应 SoC、集成 DPU 的智能网卡或 GPU 直连 NVMe/网卡的新平台时,会发现它们都是在这两个极端之间寻找更细的折中:用空间专用电路守住延迟与接口、用可编程/SIMT 核心保住灵活与吞吐。作为 FPGA 学习者,既不必神化 FPGA、也不必在 GPU 生态面前自我设限;把「问题的延迟约束、数据批量、规则程度、接口需求、迭代速度」这五张牌摆清楚,选型答案往往会自己浮现。很多工程最终不是在「二选一」,而是在设计一条让数据各得其所的异构流水线,这也正是当下高性能嵌入式与数据中心系统最真实的形态。
十六、能效视角:为什么数据中心也开始看 FPGA
除了延迟和灵活性,能效(每焦耳电能够完成多少计算)是 GPU 与 FPGA 之争里越来越重的一个维度,尤其在大规模数据中心和边缘端。GPU 为通用性付出的代价是:大量晶体管花在控制、缓存、分支预测和把成千上万核心喂饱的调度结构上,即便某条运算用不到这些单元,时钟仍然在翻转、仍然在耗电;它擅长的是"吞吐",单位是每秒多少万亿次运算,但单位能耗下的有效运算未必高。FPGA 则是"量体裁衣":你为某个具体算法定制数据通路,只实例化真正需要的运算单元,没有指令译码、没有通用寄存器堆、没有缓存一致性开销,配合流水线可以让数据以接近每个时钟一次的节奏稳定流过,单位运算的能耗往往更低。在机房动辄上千瓦、电费和散热成为主要运营成本的背景下,能在同等吞吐下省一部分电,规模化后就是可观的成本差异。
但要避免把"FPGA 一定省电"当成绝对结论,它成立有明确前提。第一是任务相对固定、专用数据通路能跑满:如果加速器大部分时间在等数据(访存瓶颈)、或者任务频繁变更导致要反复重新综合部署,FPGA 的能效和易用优势都会缩水。第二是工艺与规模:高端 GPU 用最先进制程、配备高带宽显存(HBM),单芯片峰值算力和内存带宽远超多数 FPGA;FPGA 常常赢在"恰好够用且省",而非"绝对峰值最高"。第三是开发摊销:把一个算法做成高利用率的 FPGA 加速器,工程成本远高于直接在 GPU 上调用成熟库,只有当任务量大、长期运行、或延迟/功耗约束硬性时,这笔投入才划算。现实趋势是两者与专用 ASIC(TPU 一类)并存:GPU 主导训练和通用吞吐,FPGA 在低延迟流式处理、定制加速、可重构嵌入场景占位,ASIC 在超大规模定型任务上追求极致能效。理解能效这条线索,能帮助你在选型时不止比较峰值 GOPS,而是把功耗、供电散热、任务稳定性和开发成本一起算进总拥有成本。
十七、什么时候三者都不选:ASIC 与 CPU 的位置
把视野放大到整个计算硬件谱系,会更清楚 FPGA 和 GPU 的定位,也能避免"什么都想拿 FPGA 做"的锤子心态。最灵活、最易编程的是 CPU:通用指令集、成熟操作系统和软件生态,擅长复杂控制、分支密集、数据依赖强、批量不大的任务,延迟在微秒到毫秒级、算力和确定性有限,是系统的"管家"和控制平面。GPU 牺牲一部分单线程控制灵活性,换来海量并行数据通路和高显存带宽,是训练和大规模并行推理、图形与科学计算的主力。FPGA 在通用性上再退一步、在确定性和定制性上进一步:没有预定义指令集,直接把算法烧成专用电路,微秒甚至亚微秒确定延迟、可与 IO 紧耦合、可重构,适合中小批量、长寿命、低延迟或需随标准升级的硬件加速。
谱系的尽头是 ASIC(专用集成电路):为某一类算法从晶体管级别定制,单位算力的性能、功耗、成本在量产规模下可以做到最优,但要付出极高的一次性流片费用、数月到数年周期,以及"一旦定型不可更改"的刚性。因此选择逻辑往往由产量、稳定性、上市时间、单位功耗与成本共同决定:任务不确定或量小→CPU/FPGA;任务并行且量大、可用软件栈→GPU;任务定型、出货量极大、对每瓦性能和每颗成本极致敏感→ASIC。一个典型系统甚至是四者协同:CPU 跑控制与协议栈,GPU 训练,FPGA 做前端低延迟预处理和粘合加速,定型后再考虑把 FPGA 设计中的成熟部分 ASIC 化(FPGA 原型验证本就是 ASIC 流片前的标准环节)。对学习者最务实的启示是:FPGA 是理解"硬件如何直接承载计算"的最佳教学与实验平台——它既比写软件更贴近电路,又不必承担流片的巨额成本和风险,学会从"问题的并行度、延迟确定性、数据搬运、产量与生命周期"几个维度去判断该把任务放在谱系的哪个位置,比单纯争论谁取代谁更有工程价值。
常见坑对照
| 坑 | 后果 | 正确判断 |
|---|---|---|
| 拿 GPU 拼硬实时延迟 | 抖动过不了 | 确定性延迟选 FPGA |
| 小批量数据上 GPU | 核喂不饱、延迟高 | 小批量灵活任务选 FPGA |
| kernel 分支发散 | warp 串行化掉速 | GPU 要规则并行 |
| 数据在 CPU/GPU 间来回搬 | 拷贝时间盖过计算 | 数据驻留、批量传输 |
| 指望 FPGA 替代 GPU 训练 | 算力/生态都不够 | 训练归 GPU,推理可下沉 |
相关与延伸
选型总览:FPGA vs CPU/GPU/ASIC;AI 视角:神经网络与 FPGA。 "用 C 写 FPGA"的 HLS:进阶 HLS 入门;想系统学 GPU 计算/CUDA(SIMT/kernel/显存/多卡),见独立的 GPU 计算域(gpu/);FPGA 加速架构深论见专家层《FPGA 加速架构》(后续)。
一句话总结
GPU 快在几千个简单核心按 SIMT 锁步执行(warp 齐步走)、用海量线程切换掩盖访存延迟,编程上是 CUDA kernel——你写"一个线程算一个元素"、GPU 复制成几千份并行,它喜欢大批量、规则、高算术强度的负载,代价是单任务延迟高(微秒~毫秒)且抖动、分支发散会串行化、接不了自定义硬件接口;FPGA 没有核心/线程/指令,搭的是专用数据流水线,数据每拍流一级、延迟按拍数确定(亚微秒)、引脚协议可自定义。二者不是替代而是分工:GPU 做 AI 训练和规整大吞吐批处理,FPGA 做传感器采集/协议解析/前处理、低延迟推理和线速数据搬运,CPU 管控制调度——真实加速平台常是三者同框,判断口诀是"规则大批量找 GPU,确定性低延迟/自定义接口/小批量灵活硬件找 FPGA"。
上一篇:20 神经网络与 FPGA 推理入门 | 下一篇:22 状态机入门(米利/摩尔、三段式、编码) | FPGA 系列目录